
机器学习与深度学习 / 系统课时
使用学习率调度器
使用学习率调度器
固定学习率往往只能兼顾训练的某一阶段。PyTorch 的学习率调度器可以按 epoch 预定下降,也可以观察验证指标后再下降。本篇用 StepLR 和 ReduceLROnPlateau 演示两种典型策略,并明确 scheduler.step() 应该放在哪里。
学习目标
- 能根据训练轮次使用
StepLR分段降低学习率。 - 能根据验证损失使用
ReduceLROnPlateau触发降学习率。 - 能正确安排
optimizer.step()、验证过程与scheduler.step()的调用顺序。
按轮次调整学习率
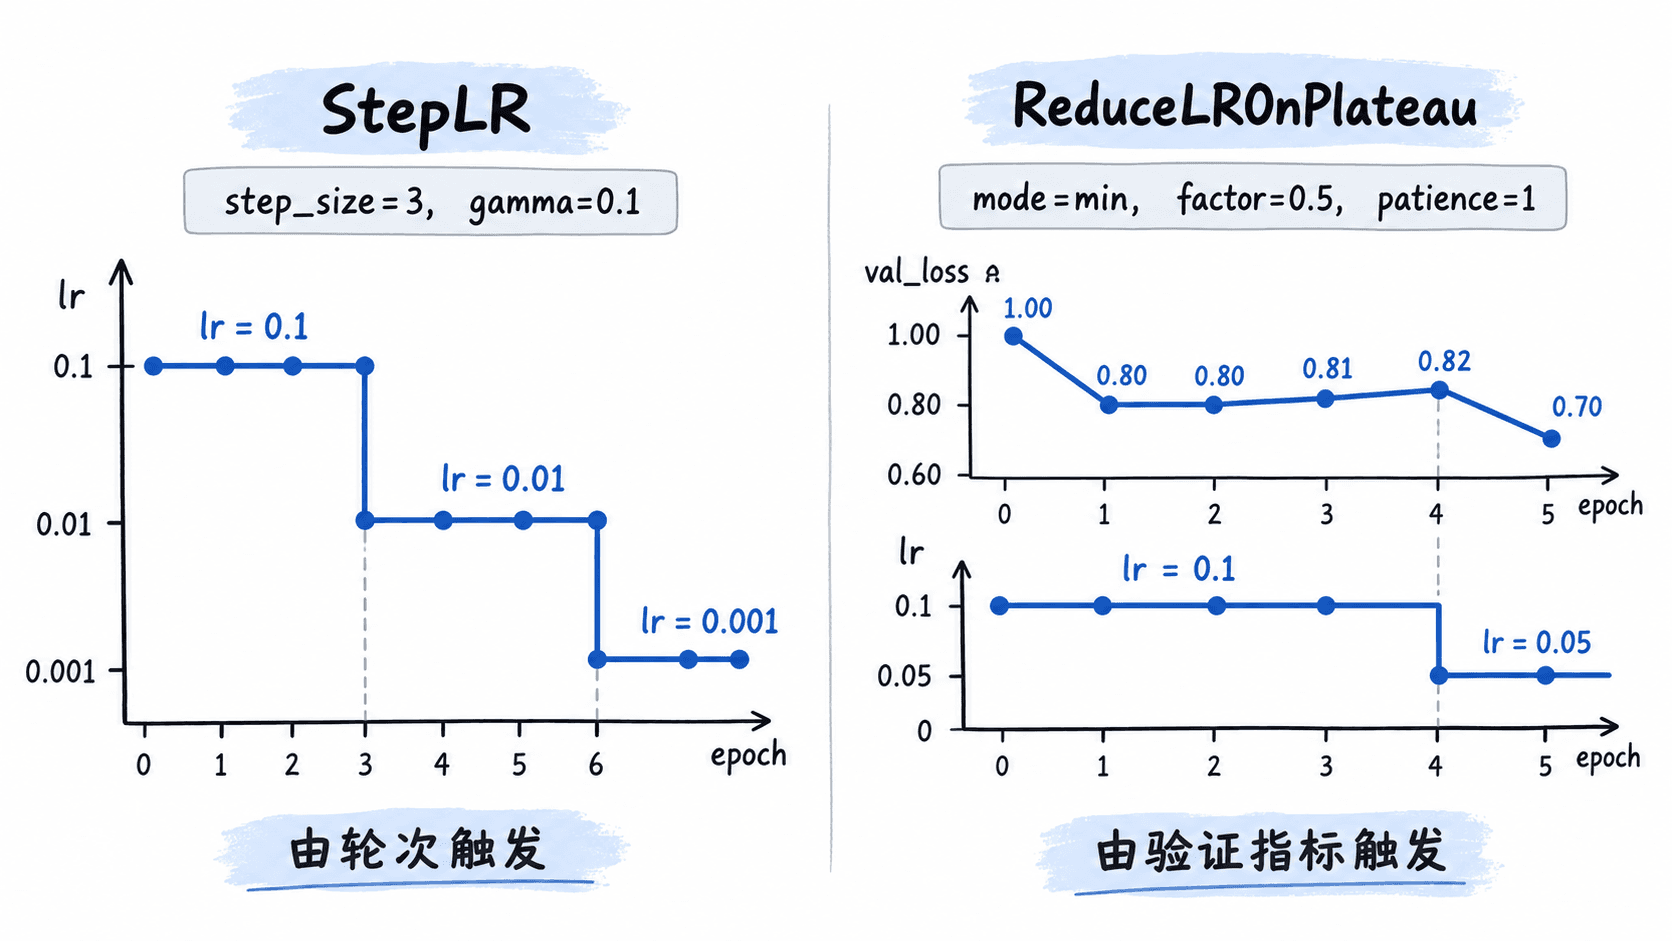
torch.optim.lr_scheduler.StepLR 每经过 step_size 个 epoch,把当前学习率乘以 gamma。例如初始 lr=0.1、step_size=3、gamma=0.1 时,第 3 个 epoch 结束后降为 0.01,第 6 个 epoch 结束后再降为 0.001。
这种策略适合训练总轮次已知、历史实验能给出大致转折点的任务。若希望在指定 epoch 才下降,可以改用 MultiStepLR(milestones=[30, 60, 90], gamma=0.1);若希望平滑衰减,则可考虑 CosineAnnealingLR。
按验证指标触发下降
torch.optim.lr_scheduler.ReduceLROnPlateau 不看 epoch 计数本身,而是读取一个指标。做分类训练时常设置 mode="min" 监控 val_loss,例如 factor=0.5、patience=1 表示指标连续没有改善时,在容忍 1 个坏 epoch 后把学习率乘以 0.5。
可直接控制的参数包括 threshold=1e-4、cooldown=0 和 min_lr=0。如果验证指标本身噪声较大,可把 patience 提高到 2~5;如果不希望学习率无限下降,可设置如 min_lr=1e-6 的下限。
运行两种调度策略
下面的脚本使用一个标量参数完成真实的反向传播和优化步骤,再分别调用两个调度器。StepLR 在每个 epoch 的参数更新之后调用;ReduceLROnPlateau 则在得到该 epoch 的验证指标之后调用。
import torch

def run_step_lr():
    p = torch.nn.Parameter(torch.tensor([1.0]))
    optimizer = torch.optim.SGD([p], lr=0.1)
    scheduler = torch.optim.lr_scheduler.StepLR(
        optimizer,
        step_size=3,
        gamma=0.1,
    )

    print("StepLR")
    for epoch in range(1, 7):
        optimizer.zero_grad()
        loss = p.square().sum()
        loss.backward()
        optimizer.step()
        scheduler.step()
        lr = optimizer.param_groups[0]["lr"]
        print(f"epoch={epoch}, lr={lr:.3f}")

def run_plateau():
    p = torch.nn.Parameter(torch.tensor([1.0]))
    optimizer = torch.optim.SGD([p], lr=0.1)
    scheduler = torch.optim.lr_scheduler.ReduceLROnPlateau(
        optimizer,
        mode="min",
        factor=0.5,
        patience=1,
    )
    val_losses = [1.00, 0.80, 0.80, 0.81, 0.82, 0.70]

    print("ReduceLROnPlateau")
    for epoch, val_loss in enumerate(val_losses, 1):
        optimizer.zero_grad()
        loss = p.square().sum()
        loss.backward()
        optimizer.step()

        # 真实项目中这里应先完成验证,再把指标传给调度器。
        scheduler.step(val_loss)
        lr = optimizer.param_groups[0]["lr"]
        print(
            f"epoch={epoch}, val_loss={val_loss:.2f}, "
            f"lr={lr:.3f}"
        )

run_step_lr()
run_plateau()
预期输出
StepLR
epoch=1, lr=0.100
epoch=2, lr=0.100
epoch=3, lr=0.010
epoch=4, lr=0.010
epoch=5, lr=0.010
epoch=6, lr=0.001
ReduceLROnPlateau
epoch=1, val_loss=1.00, lr=0.100
epoch=2, val_loss=0.80, lr=0.100
epoch=3, val_loss=0.80, lr=0.100
epoch=4, val_loss=0.81, lr=0.050
epoch=5, val_loss=0.82, lr=0.050
epoch=6, val_loss=0.70, lr=0.050
输出中的 lr 是 scheduler.step() 执行后的值,也就是下一个 epoch 将采用的学习率。patience=1 的直观含义是允许 1 个没有改善的 epoch;继续出现坏 epoch 时才触发下降,所以例子中学习率在 epoch 4 后变为 0.05。
把调用顺序放对
对于 StepLR、MultiStepLR、CosineAnnealingLR 这类按进度更新的调度器,常规顺序是先完成当前 epoch 内的 optimizer.step(),再在 epoch 末调用一次 scheduler.step()。把调度器放到优化器更新之前,可能跳过调度序列的第一个学习率值。
ReduceLROnPlateau 的位置不同:先训练,再计算验证集指标,最后调用 scheduler.step(val_loss)。如果监控准确率,把 mode 改为 "max" 并传入 val_accuracy。训练日志至少记录 epoch、验证指标和当前 optimizer.param_groups[0]["lr"],这样才能确认降学习率是否发生在预期时刻。