
机器学习与深度学习 / 系统课时
实现线性回归训练
实现线性回归训练
这一课用一组可精确拟合的数据完成线性回归训练:从可求导参数、前向计算和损失函数开始,经过反向传播与参数更新,最终让模型恢复真实关系 ,并用损失和参数误差验收训练结果。
学习目标
- 使用叶子张量和
requires_grad=True创建可训练参数。 - 串起清梯度、前向计算、反向传播和 SGD 更新的完整训练循环。
- 根据损失值和参数误差判断模型是否真正收敛。
把回归问题写成可求导目标
使用 5 个样本:x=-2,-1,0,1,2,目标值按 生成,因此对应 y=-4,-1,2,5,8。模型只包含两个待学习标量:权重 w 和偏置 b,预测规则为 。
| 项目 | 训练设置 |
|---|---|
| 参数初值 | w=0.0、b=0.0 |
| 损失 | 均方误差 MSE |
| 优化器 | torch.optim.SGD |
| 学习率 | 0.1 |
| 更新次数 | 101 次 |
| 验收目标 | w≈3、b≈2、loss 接近 0 |
w 和 b 必须是参与计算图的叶子张量,因此直接用 torch.tensor(..., requires_grad=True) 创建。经过 loss.backward() 后,PyTorch 会把损失对这两个参数的偏导数写入各自的 .grad。
串起一次训练迭代
标准迭代顺序是先调用 optimizer.zero_grad(set_to_none=True) 清除上一轮梯度,再计算预测与损失,然后执行 loss.backward(),最后由 optimizer.step() 更新参数。PyTorch 默认累加梯度;如果漏掉清理步骤,第 2 轮开始得到的就不是单轮梯度。
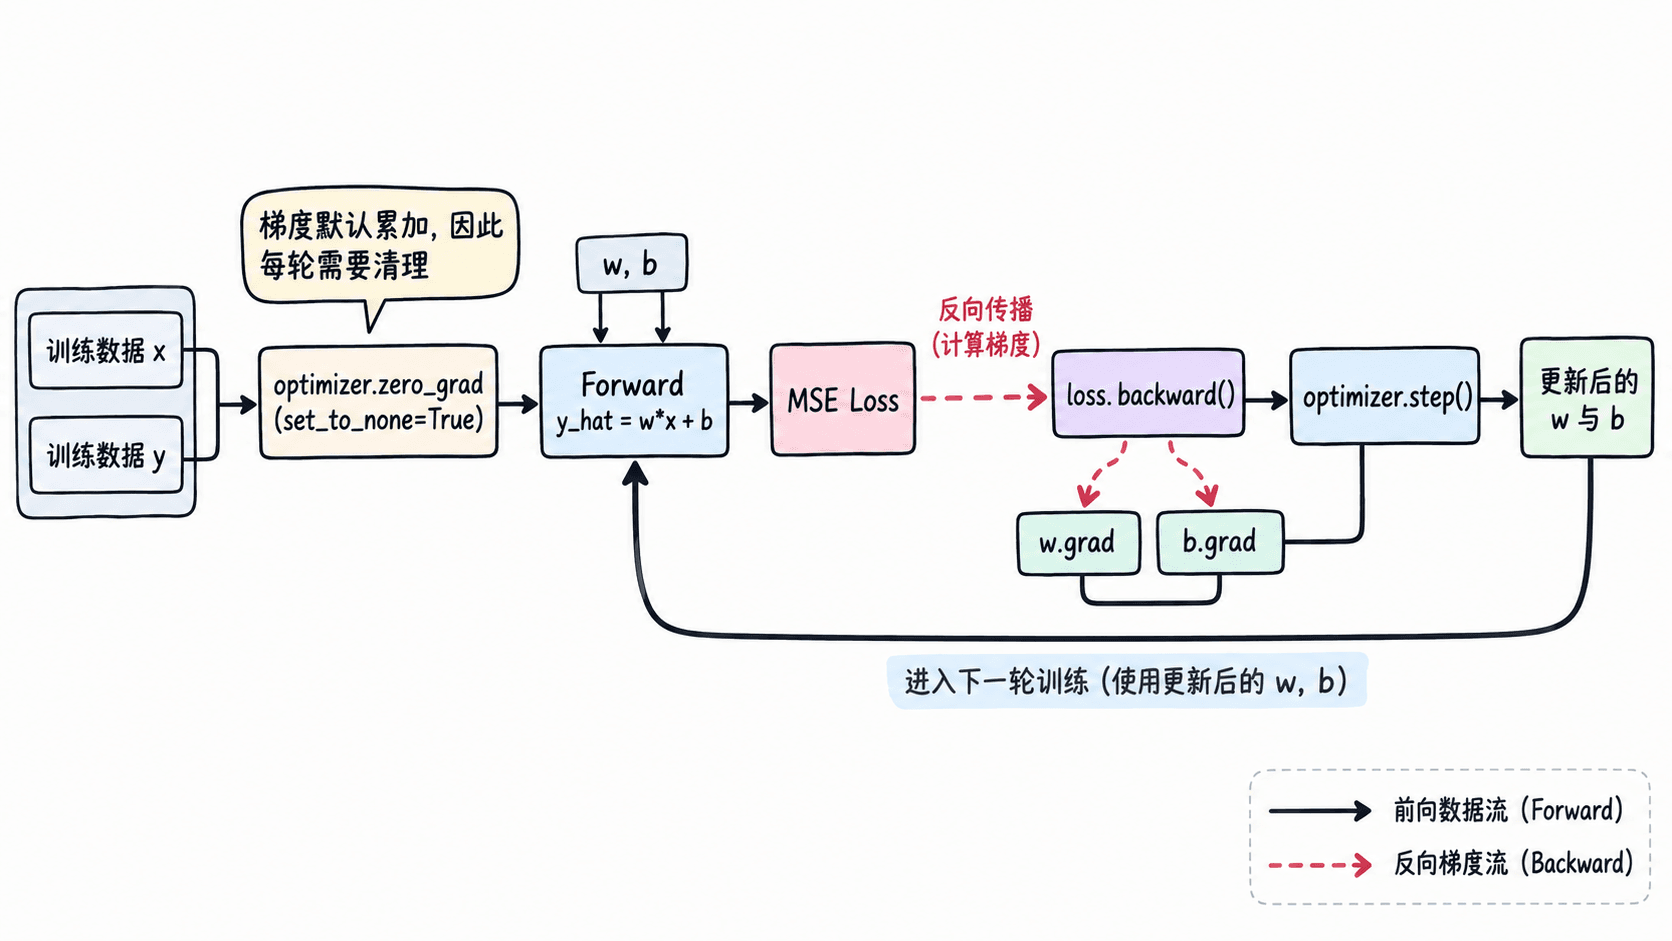
这里使用 set_to_none=True 后,梯度在下一次反向传播前保持为 None,既能避免误用旧梯度,也通常比把梯度张量逐项写成 0 更节省操作。
运行完整训练
下面的程序只使用张量、自动求导和 SGD。数据没有噪声,因此模型可以把两个参数训练到非常接近真实的 3 和 2。
import torch

x = torch.tensor([[-2.0], [-1.0], [0.0], [1.0], [2.0]])
y = 3.0 * x + 2.0

# 叶子张量直接作为待优化参数。
w = torch.tensor(0.0, requires_grad=True)
b = torch.tensor(0.0, requires_grad=True)
optimizer = torch.optim.SGD([w, b], lr=0.1)

for step in range(101):
    optimizer.zero_grad(set_to_none=True)

    prediction = w * x + b
    loss = ((prediction - y) ** 2).mean()

    loss.backward()

    if step in (0, 20):
        print(f"step={step:03d} loss={loss.item():.6f}")

    optimizer.step()

print(f"final_loss={loss.item():.6f}")
print(f"w={w.item():.3f} b={b.item():.3f}")
预期输出
step=000 loss=22.000000
step=020 loss=0.000532
final_loss=0.000000
w=3.000 b=2.000
不同 PyTorch 版本或硬件的浮点末位可能略有差异,但保留到三位小数时参数应接近 w=3.000、b=2.000。初始 loss 为 22,说明输出不是通过预先写入正确参数得到,而是确实经过优化收敛。
用参数与损失验收训练
仅看到 loss 下降还不够。本例知道真实参数,因此可以同时检查 loss < 1e-6、abs(w-3) < 1e-3 和 abs(b-2) < 1e-3。真实项目不知道真实权重时,则应改用独立验证集误差作为主要验收依据。
最常见的两个错误可以直接从训练现象判断。漏掉 zero_grad 会让梯度跨迭代累加,参数更新越来越偏离当前批次;把学习率从 0.1 直接提高到 1.0 时,本例的权重更新会发生大幅振荡并迅速发散,而不是更快收敛。
训练循环中还应避免在计算 loss 前对预测结果调用 detach(),因为这会切断预测值到 w、b 的计算图。只把 .item() 用于日志输出,不要把它得到的 Python 数值重新用于需要反向传播的损失计算。