
机器学习与深度学习 / 系统课时
理解循环神经网络
理解循环神经网络
循环神经网络处理序列时,会把前一个时间步的隐藏状态传给下一个时间步,使后面的计算能够利用前文信息。本篇用 PyTorch 的 nn.RNN 跑通一个三步序列,并通过张量形状与最终隐藏状态验证时间维是怎样被逐步处理的。
学习目标
- 理解输入、隐藏状态和输出在时间步之间的传递关系
- 使用
nn.RNN处理 batch-first 序列并读懂返回张量形状 - 区分逐时间步输出
output与最终隐藏状态h_n
隐藏状态把前文传到下一步
最简单的 RNN 在时间步 同时读取当前输入 和前一状态 ,再生成新的状态:
因此一个长度为 4 的序列并不是四次互不相关的计算。第 2 步依赖第 1 步得到的隐藏状态,第 3 步继续依赖第 2 步。模型参数在所有时间步共享,而隐藏状态随时间变化。
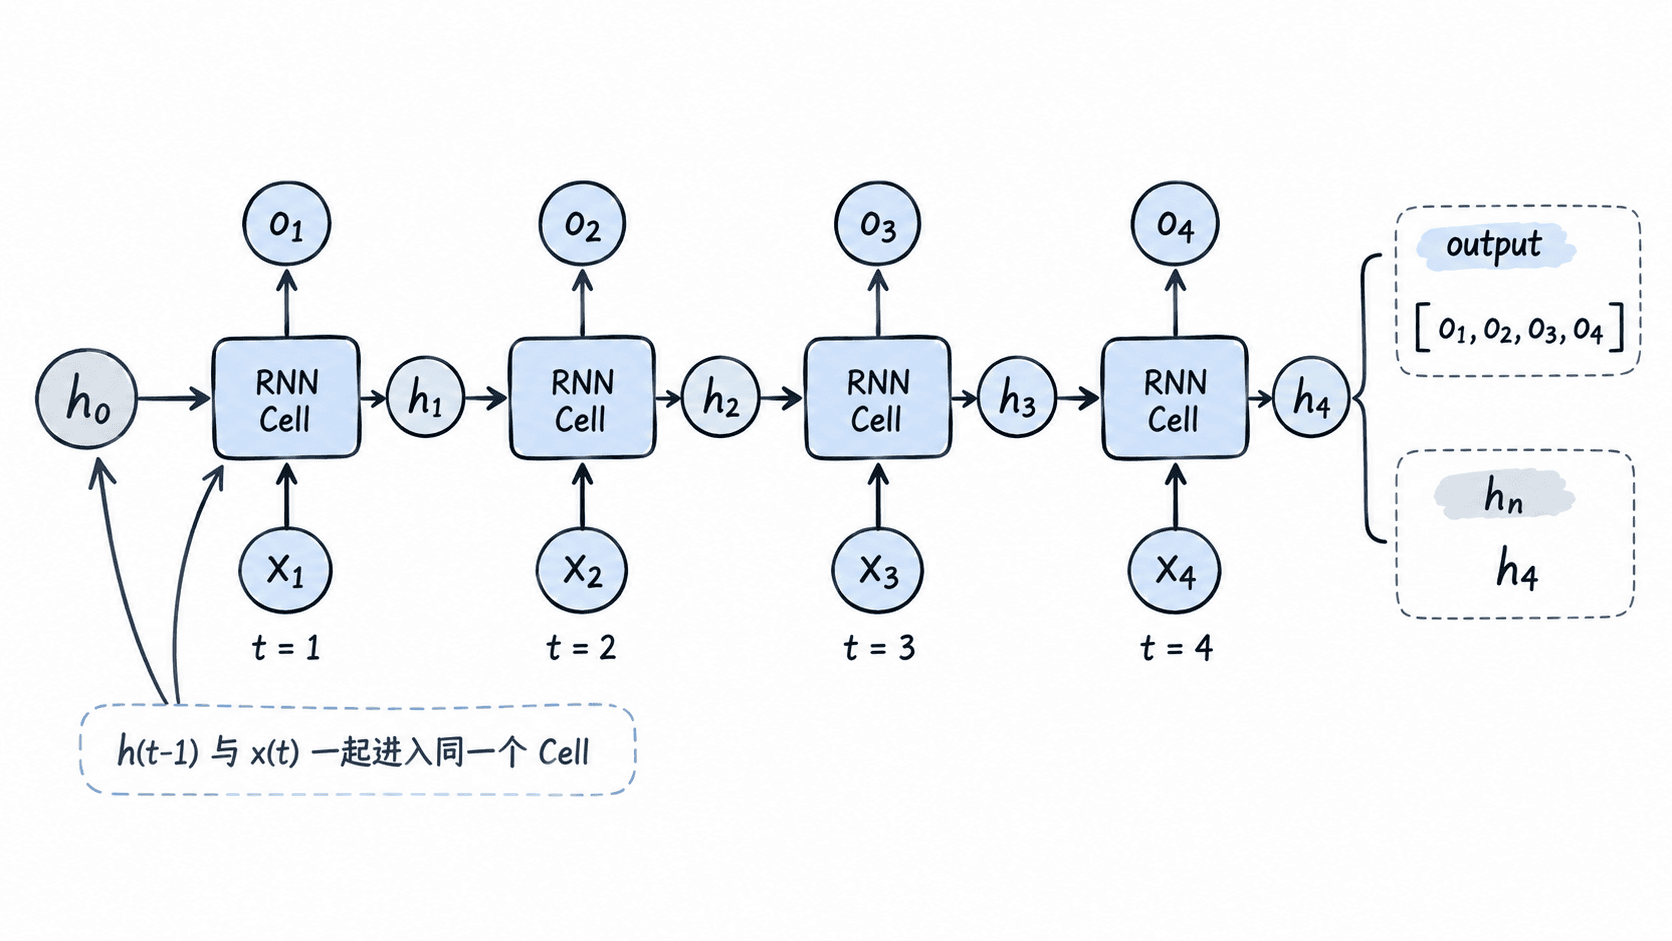
如果没有显式传入初始状态,PyTorch 会使用零状态。实际代码也常主动创建 h0,这样尺寸关系更容易检查,同时便于需要跨片段传递状态的场景。
用 nn.RNN 跑通三步序列
下面设置 input_size=5、hidden_size=4,输入包含 2 条序列,每条有 3 个时间步。batch_first=True 让输入和 output 都按 [batch, seq, feature] 排列。
import torch
from torch import nn

torch.manual_seed(7)

rnn = nn.RNN(
    input_size=5,
    hidden_size=4,
    num_layers=1,
    nonlinearity="tanh",
    batch_first=True,
)

# 2 条序列,每条 3 个时间步,每步 5 个输入特征。
x = torch.randn(2, 3, 5)
h0 = torch.zeros(1, 2, 4)

output, h_n = rnn(x, h0)

print("input shape:", x.shape)
print("output shape:", output.shape)
print("h_n shape:", h_n.shape)
print("last step equals h_n:", torch.allclose(output[:, -1, :], h_n[0]))
预期输出:
input shape: torch.Size([2, 3, 5])
output shape: torch.Size([2, 3, 4])
h_n shape: torch.Size([1, 2, 4])
last step equals h_n: True
output 保留了三个时间步各自的隐藏状态,所以形状是 [2, 3, 4]。单层、单向 RNN 的 h_n[0] 则保存每条序列最后一个时间步的隐藏状态,因此它与 output[:, -1, :] 相同。
看懂 h0 和 h_n 的维度
隐藏状态并不遵循 batch_first。无论 batch_first 是否为 True,h0 与 h_n 的形状都按 [num_layers * num_directions, batch, hidden_size] 排列。
本例只有 1 层、单向传播,因此 h0 是 [1, 2, 4]:第一维表示 1 个层与方向组合,第二维对应 2 条样本,第三维是 4 个隐藏特征。如果把 num_layers 改为 2,第一维就变为 2;若同时使用双向 RNN,第一维还要再乘 2。
文本分类通常读取哪个状态
如果所有样本长度都相同,单向 RNN 可以把最后时间步的状态作为整条序列表示,再接一个 nn.Linear(hidden_size, num_classes) 做分类。本例中就是取 output[:, -1, :] 或单层情况下的 h_n[0],得到 [batch, hidden_size]。
真实文本往往经过 padding,最后一个数组位置可能只是 <pad>。这时不能机械地取 output[:, -1, :];应根据真实长度选取有效的最后时间步,或使用 pack_padded_sequence 等机制避免把补齐部分当作正文继续循环。
普通 nn.RNN 的隐藏状态需要沿很多时间步反复传播,长序列训练时容易出现梯度衰减等问题。工程中处理较长依赖时常改用 nn.GRU、nn.LSTM 或 Transformer,但读取输入形状、时间步输出与最终隐藏状态的思路仍然是理解这些序列模块的基础。