
机器学习与深度学习 / 系统课时
编写训练循环
编写训练循环
训练循环把一个批次的数据真正变成一次参数更新:切换训练模式、清理旧梯度、前向计算、求损失、反向传播,再由优化器修改参数。下面用一个可直接运行的线性回归例子把这些动作组织成稳定的批次循环,并给出能发现“代码在跑但模型没学”的检查方法。
学习目标
- 按正确顺序组织
model.train()、前向计算、loss.backward()与optimizer.step() - 理解为什么每个批次都要清理梯度,以及
set_to_none=True的行为 - 用有限损失、优化器步数和参数变化验证训练循环确实生效
训练迭代的执行顺序
一个批次通常按下列顺序执行。model.train() 一般在进入整个训练阶段时调用一次,而不是每个批次重复调用。
| 顺序 | 操作 | PyTorch API | 可检查的结果 |
|---|---|---|---|
| 1 | 清理上一次梯度 | optimizer.zero_grad(set_to_none=True) |
参数的 .grad 变为 None |
| 2 | 前向计算 | pred = model(x) |
输出形状符合任务要求 |
| 3 | 计算损失 | loss = loss_fn(pred, y) |
loss 是有限标量 |
| 4 | 反向传播 | loss.backward() |
可训练参数得到梯度 |
| 5 | 更新参数 | optimizer.step() |
至少一个参数值发生变化 |
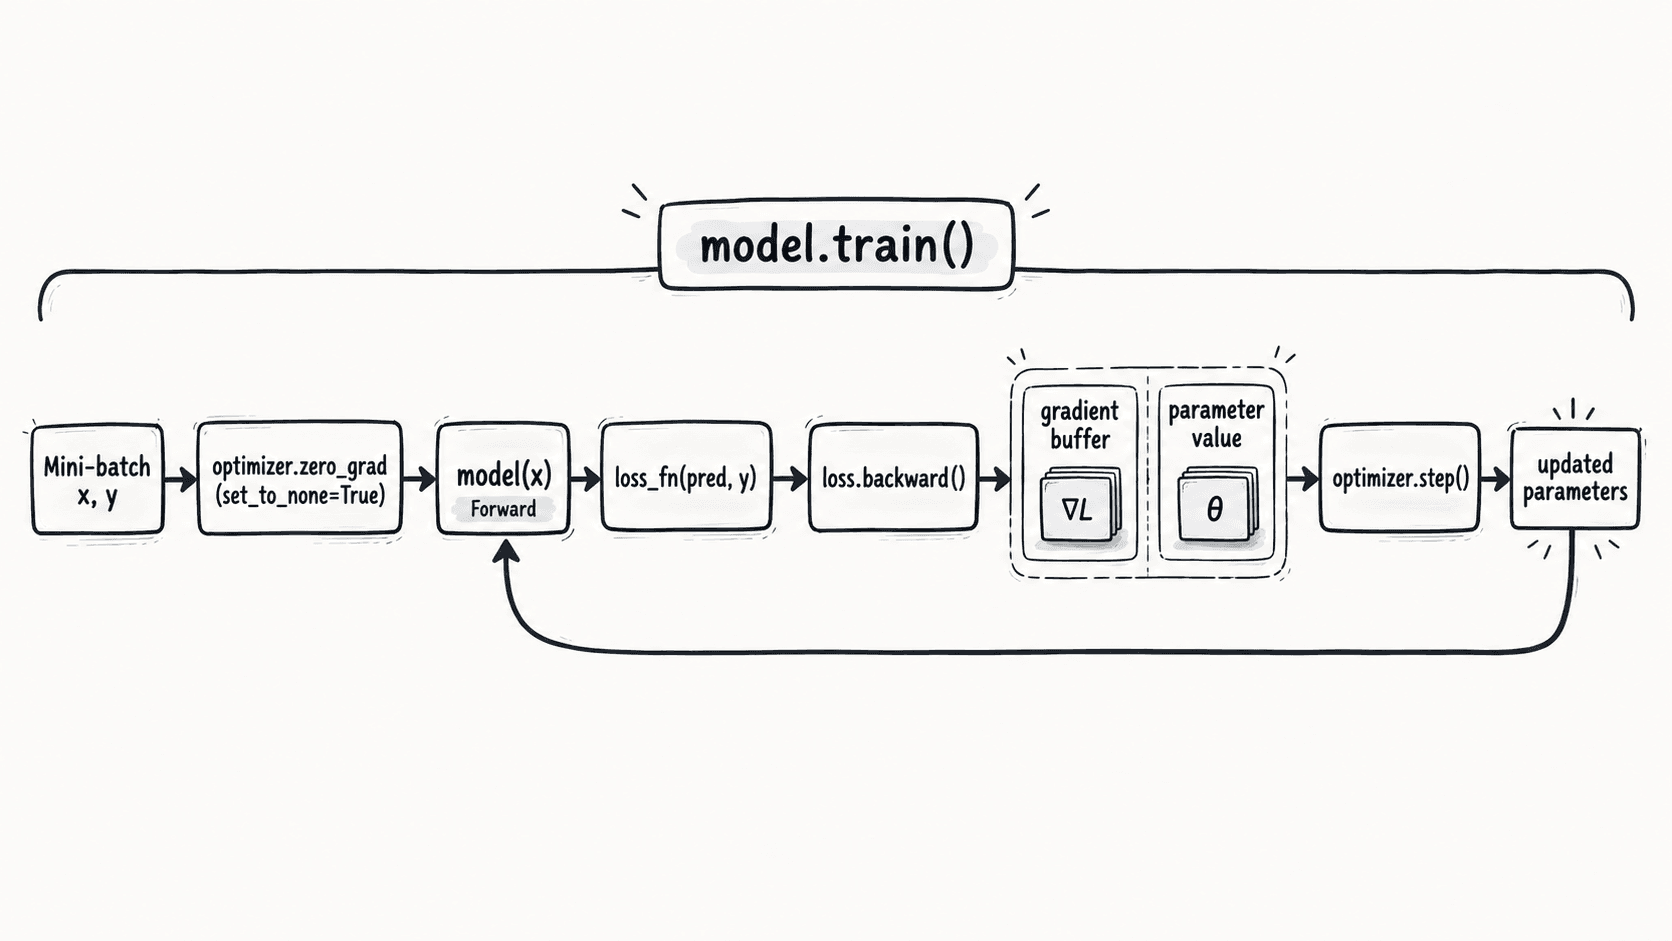
关键边界是:backward() 只负责把梯度累积到参数的 .grad,真正改变权重的是 optimizer.step()。如果漏掉清零,第二个批次的梯度会叠加到第一个批次上;除非你有意做梯度累积,否则这通常不是想要的行为。
写出可运行的最小训练循环
下面的例子拟合关系 y = x1 + 2*x2。为了让检查结果稳定,线性层从全零参数开始,数据集有 4 条样本、批大小为 2、训练 3 轮,因此优化器应执行 6 次更新。
import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

x = torch.tensor([
    [1.0, 0.0],
    [0.0, 1.0],
    [1.0, 1.0],
    [2.0, 1.0],
])
y = torch.tensor([[1.0], [2.0], [3.0], [4.0]])

loader = DataLoader(TensorDataset(x, y), batch_size=2, shuffle=False)
model = nn.Linear(2, 1)
nn.init.zeros_(model.weight)
nn.init.zeros_(model.bias)

loss_fn = nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.1)

initial_params = [p.detach().clone() for p in model.parameters()]
optimizer_steps = 0
last_loss = None

model.train()
for _ in range(3):
    for batch_x, batch_y in loader:
        optimizer.zero_grad(set_to_none=True)
        pred = model(batch_x)
        loss = loss_fn(pred, batch_y)
        loss.backward()
        optimizer.step()

        optimizer_steps += 1
        last_loss = loss.detach()

params_changed = any(
    not torch.equal(before, after.detach())
    for before, after in zip(initial_params, model.parameters())
)

print("epochs=3")
print(f"optimizer_steps={optimizer_steps}")
print(f"last_loss_finite={torch.isfinite(last_loss).item()}")
print(f"params_changed={params_changed}")
预期输出
epochs=3
optimizer_steps=6
last_loss_finite=True
params_changed=True
这段代码的核心不是最终拟合精度,而是验证训练链路完整:6 个批次都执行了 step(),损失没有变成 NaN 或 Inf,并且参数确实离开了初始值。
梯度清零与训练模式的边界
optimizer.zero_grad(set_to_none=True) 推荐放在每个批次前。set_to_none=True 会把梯度引用设为 None,而不是写成全零张量,通常能减少一次内存写入;更重要的是,如果某个参数本轮根本没有参与计算,它的 .grad 会保持 None,更容易暴露断开的计算路径。
model.train() 只改变部分模块的运行行为,例如 Dropout 会启用随机丢弃,BatchNorm 会更新运行统计;它不会自动开启反向传播,也不会替代 backward()。训练阶段如果从验证阶段切回来,应该显式再次调用 model.train()。
验证训练循环是否真的在学习
真实项目里至少保留三类检查。第一,批次进入模型前先确认形状,例如回归任务这里应满足 batch_x.shape == [B, 2]、batch_y.shape == [B, 1];形状意外广播可能让损失“能算”但含义已经错了。
第二,训练早期检查 torch.isfinite(loss)。一旦损失非有限值,应停止该批次并排查学习率、输入尺度或除零,而不是继续让坏参数扩散。第三,确认参数确实发生变化;如果连续多个 optimizer.step() 后参数完全不变,常见原因是忘记 backward()、参数未交给优化器,或在错误的无梯度上下文中执行了前向计算。
当这三项都通过后,再增加 epoch 级平均损失、学习率和验证指标;训练循环本身则保持“清梯度 → 前向 → 损失 → 反向 → 更新”的单一职责,后续加入混合精度、梯度裁剪或调度器时也更容易定位顺序错误。