
机器学习与深度学习 / 系统课时
建立标准项目结构
建立标准项目结构
PyTorch 项目一旦同时包含数据、模型、训练脚本、配置、测试和实验产物,把文件全部堆在仓库根目录会很快失控。本篇建立一个适合中小型训练项目的目录约定,并明确哪些内容进 Git、哪些内容只作为本地或 CI 产物保存。
学习目标
- 按数据、模型、训练、配置、测试和输出职责规划目录。
- 用可执行命令创建一套最小项目骨架并检查目录是否齐全。
- 区分源码、配置、数据和训练产物的版本控制边界。
先按职责切开目录
推荐先把“可复现输入”和“运行产生的输出”分开:src/、configs/、tests/ 属于工程定义,artifacts/ 属于运行产物,data/ 再区分原始数据与可重建的处理结果。
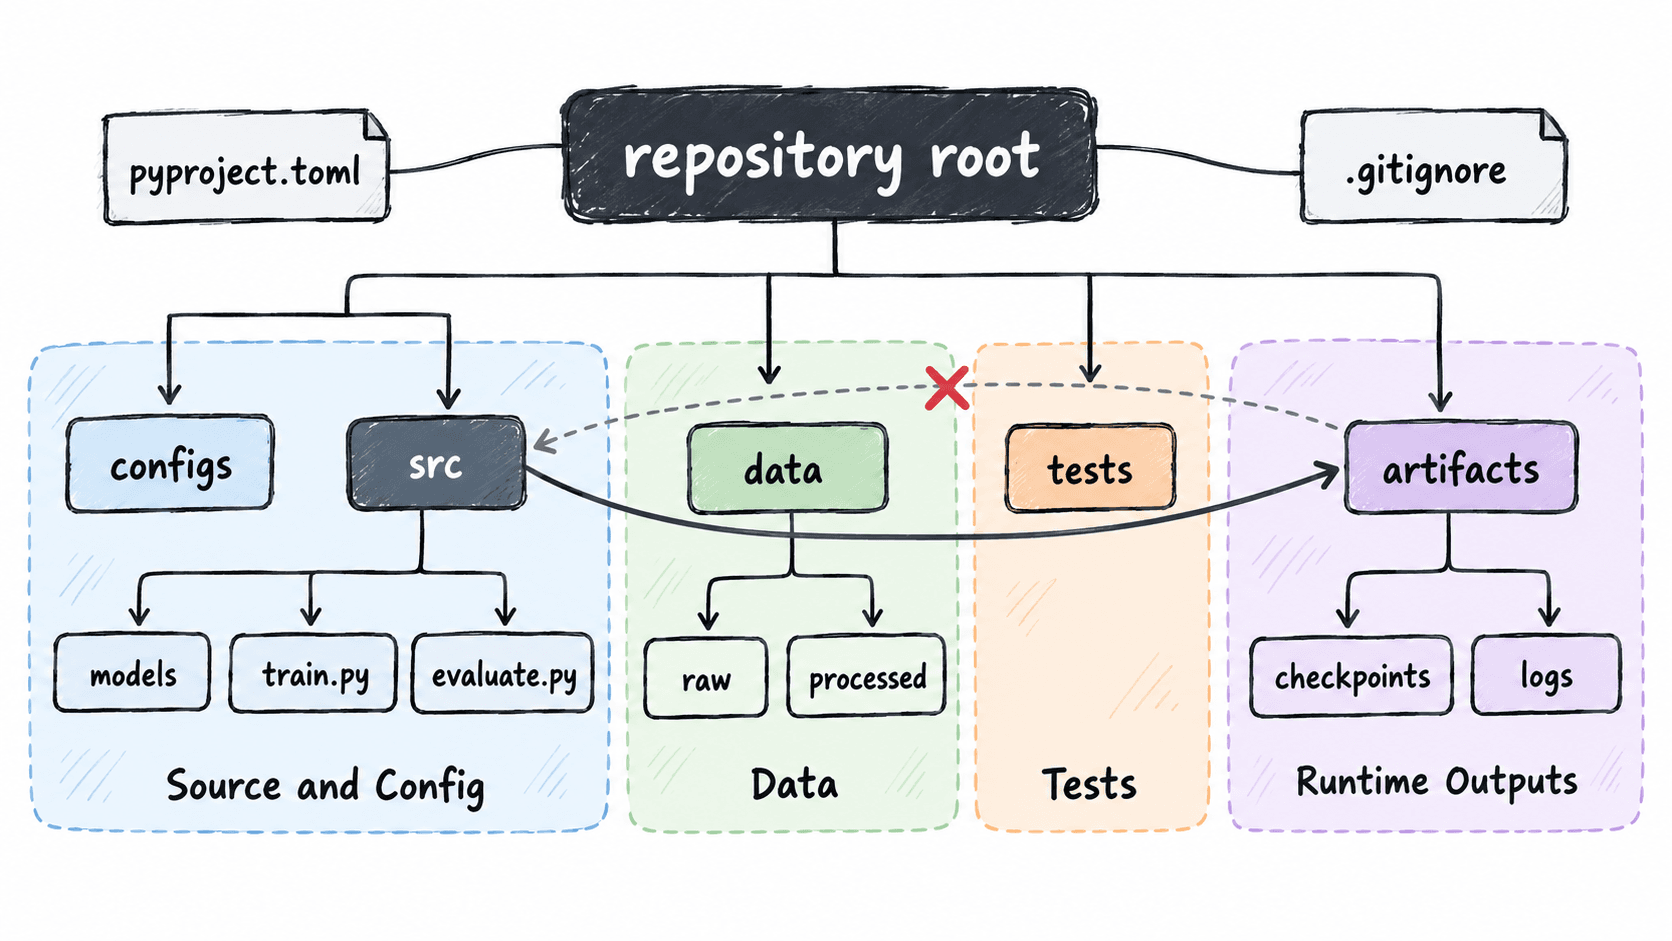
各目录可以采用下面的职责约定:
| 路径 | 放什么 | 不建议放什么 |
|---|---|---|
configs/ |
学习率、batch size、epoch、随机种子等配置 | 密码、访问令牌 |
data/raw/ |
原始数据快照或本地挂载入口 | 训练脚本生成的中间文件 |
data/processed/ |
可由预处理流程重建的数据 | 唯一不可替代的原始数据 |
src/models/ |
nn.Module 与模型组件 |
命令行解析、日志目录创建 |
src/train.py |
训练编排、优化器和保存逻辑 | 大段模型定义重复代码 |
src/evaluate.py |
冻结数据集上的评估入口 | 继续修改模型参数的训练逻辑 |
tests/ |
模型 shape、数据转换、冒烟测试 | 大型训练产物 |
artifacts/ |
checkpoint、日志、指标、导出模型 | 需要人工维护的源码 |
创建最小项目骨架
下面命令适用于 Linux、macOS 和 Git Bash。它创建目录与常用空文件,再列出三级以内的目录,便于立即检查路径是否符合约定。
# 创建职责明确的目录和最小入口文件。
mkdir -p pytorch-project/{configs,data/raw,data/processed,src/models,tests,artifacts/checkpoints,artifacts/logs}
touch pytorch-project/{pyproject.toml,.gitignore}
touch pytorch-project/configs/train.yaml
touch pytorch-project/src/{__init__.py,train.py,evaluate.py}
touch pytorch-project/src/models/__init__.py
touch pytorch-project/tests/test_model.py

# 列出三级以内目录,用于检查骨架。
find pytorch-project -maxdepth 3 -type d | sort
预期输出:
pytorch-project
pytorch-project/artifacts
pytorch-project/artifacts/checkpoints
pytorch-project/artifacts/logs
pytorch-project/configs
pytorch-project/data
pytorch-project/data/processed
pytorch-project/data/raw
pytorch-project/src
pytorch-project/src/models
pytorch-project/tests
这里把训练输出统一放在 artifacts/,是为了让删除一次实验产物不会破坏源码。src/ 内加入 __init__.py,可以让后续代码使用包导入,例如从 src.models 引入模型,而不是依赖当前工作目录拼接 sys.path。
把可调参数放进配置
训练参数不要散落在多个 Python 文件里。一个最小的 configs/train.yaml 可以明确随机种子、训练轮数、batch size、学习率与设备选择:
seed: 7
model:
  hidden_dim: 128
train:
  epochs: 20
  batch_size: 64
  learning_rate: 0.001
runtime:
  device: cuda
这是配置片段,不是独立可执行程序。训练入口读取它之后,应在启动日志中打印最终生效值,并在 CUDA 不可用时明确报错或按项目约定回退到 CPU,不能静默换设备导致性能结果难以比较。
参数命名也要保持单一来源。例如学习率只保留 train.learning_rate,不要同时在 train.py 里再硬编码 1e-3。当一次实验要把学习率改为 0.0003 时,只改配置并保存对应运行记录,才能准确解释两个实验的差异。
明确 Git 与运行产物的边界
通常应提交 src/、configs/、tests/、pyproject.toml 和少量用于测试的样例数据;大型原始数据、虚拟环境、checkpoint 和日志则不应直接进入普通 Git 历史。
一个基础 .gitignore 可以这样写:
.venv/
__pycache__/
*.pyc
artifacts/
data/raw/
data/processed/
这份规则会忽略本地训练数据和全部运行产物。若团队确实需要版本化大型数据或模型,应使用对象存储、数据版本工具或模型仓库,并在配置或发布清单中记录版本标识,而不是删除 .gitignore 后把数 GB 文件直接提交进 Git。
用结构检查阻止目录漂移
骨架创建后,可以先做一个只检查关键目录存在性的冒烟验证。下面命令在前面的 pytorch-project 同级目录执行:
# 验证四个关键目录;任一不存在时都不会打印成功标记。
test -d pytorch-project/configs && test -d pytorch-project/src/models && test -d pytorch-project/tests && test -d pytorch-project/artifacts/checkpoints && echo "structure-ok"
预期输出:
structure-ok如果没有输出,逐个执行 test -d <PATH> 或直接检查拼写,常见问题是把 artifact 与 artifacts、config 与 configs 混用。项目一旦选定目录名,就应让训练脚本、测试和 CI 使用同一套路径;不要在不同脚本里各自发明新的输出目录。
一个合格的项目结构应该满足四个检查点:新成员能快速找到模型和训练入口;删除 artifacts/ 不影响源码;配置文件能描述一次实验的关键参数;测试不依赖某个历史 checkpoint 才能通过。做到这些后,目录本身就能成为工程边界,而不是简单的文件分类。