
机器学习与深度学习 / 系统课时
理解前向传播
理解前向传播
前向传播就是把一批输入按网络定义的顺序依次经过线性层、激活函数等运算,最终得到预测值。掌握它之后,你能看懂张量形状如何变化,也能判断模型输出为什么是某个数。
学习目标
- 说明前向传播中输入、参数、激活值和输出之间的关系。
- 用 PyTorch 手算并运行一个两层网络的前向过程。
- 根据张量形状定位常见的维度不匹配问题。
前向传播实际计算什么
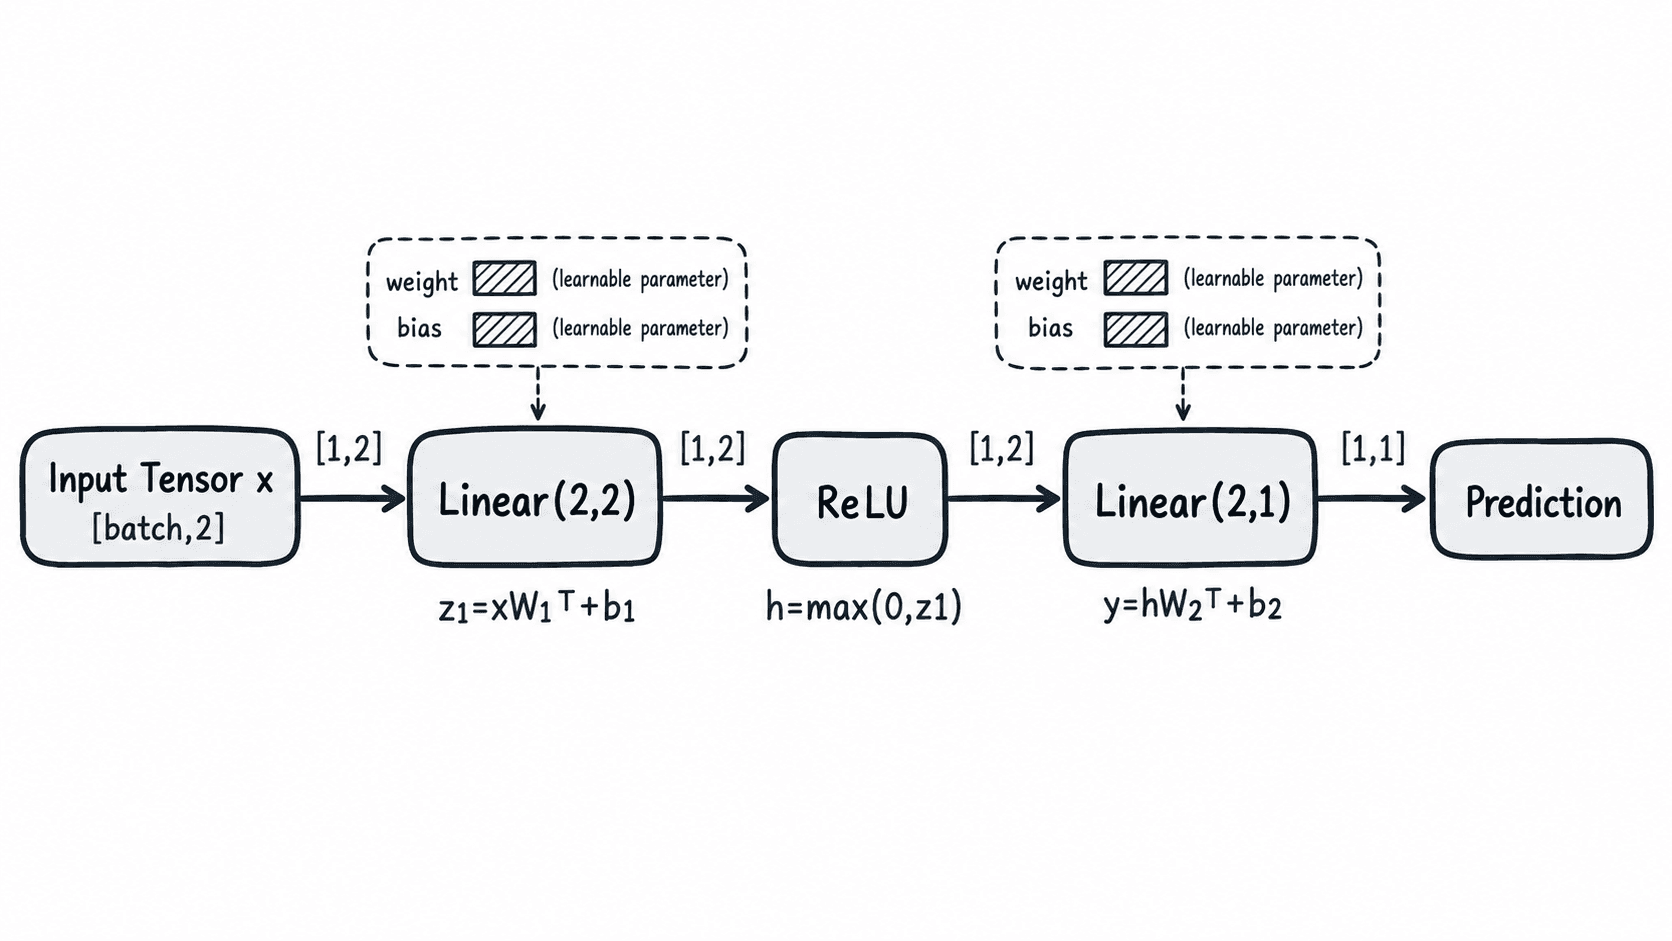
以两层全连接网络为例,输入 先经过第一层线性变换得到 ,再经过 ReLU 得到 ,最后计算 。前向传播只负责得到当前参数下的预测,不会在这一步自动修改权重。
若批大小为 32、输入特征数为 4,第一层 Linear(4, 8) 的输入形状是 [32, 4],输出形状是 [32, 8];第二层 Linear(8, 1) 再把它变为 [32, 1]。批大小始终保留在第 0 维。
用固定参数跑通一次
下面用固定权重消除随机因素。nn.Linear 的权重形状是 [out_features, in_features],因此第一层权重是 [2, 2],第二层是 [1, 2]。
import torch
from torch import nn

class TinyNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.hidden = nn.Linear(2, 2)
        self.output = nn.Linear(2, 1)

        # 固定参数,便于核对每一步数值。
        with torch.no_grad():
            self.hidden.weight.copy_(torch.tensor([[0.5, -1.0], [1.0, 0.5]]))
            self.hidden.bias.copy_(torch.tensor([0.0, 0.5]))
            self.output.weight.copy_(torch.tensor([[1.0, -0.5]]))
            self.output.bias.copy_(torch.tensor([0.25]))

    def forward(self, x):
        # forward 描述模型从输入到预测的计算路径。
        h = torch.relu(self.hidden(x))
        return self.output(h)

model = TinyNet()
x = torch.tensor([[2.0, -1.0]])
print(f"{model(x).item():.2f}")
预期输出
1.25这组参数下,第一层线性输出为 [2.0, 2.0],ReLU 后仍是 [2.0, 2.0],第二层得到 。实际训练时权重来自初始化并由优化器更新,但计算顺序不变。
forward 与 model(x) 的关系
自定义模型通常在 forward() 中声明前向计算,但调用时应使用 model(x),而不是直接写 model.forward(x)。nn.Module.__call__ 会在执行 forward() 前后处理已注册的 hooks 等 Module 机制,直接调用 forward() 会绕开这些逻辑。
检查某一层的形状时,可以临时打印 x.shape、h.shape 和最终输出形状。例如输入 [16, 2] 经过本例模型后,应依次得到 [16, 2]、[16, 2]、[16, 1]。
先检查形状,再检查数值
前向传播最常见的错误不是公式本身,而是维度不匹配。若层定义为 nn.Linear(2, 4),最后一维必须是 2;传入 [32, 3] 会触发矩阵乘法错误。排查时先确认输入最后一维,再逐层确认 in_features 与上一层输出一致。
另一个常见问题是把分类任务的最终输出过早变成概率。例如与 nn.CrossEntropyLoss 配合时,模型最后一层通常直接输出 logits,不要在 forward() 末尾额外调用 softmax。前向传播负责产生模型需要的输出表示,具体是否转成概率要由损失函数和推理场景决定。