
机器学习与深度学习 / 系统课时
匹配预训练输入规范
匹配预训练输入规范
预训练权重只在输入遵循相同图像语义和数值尺度时才能稳定复用。本课以 torchvision 的 ResNet-18 为例,把尺寸、RGB 通道、张量布局和归一化参数逐项对齐,并用固定像素图像直接检查预处理后的数值。
学习目标
- 从预训练权重对象读取并复用官方输入预处理,而不是手工猜参数。
- 将图像稳定转换为
float32、3×224×224、ImageNet 归一化后的张量。 - 排查 BGR、灰度图、重复归一化和缺少 batch 维度等常见错配。
以权重自带预处理为准
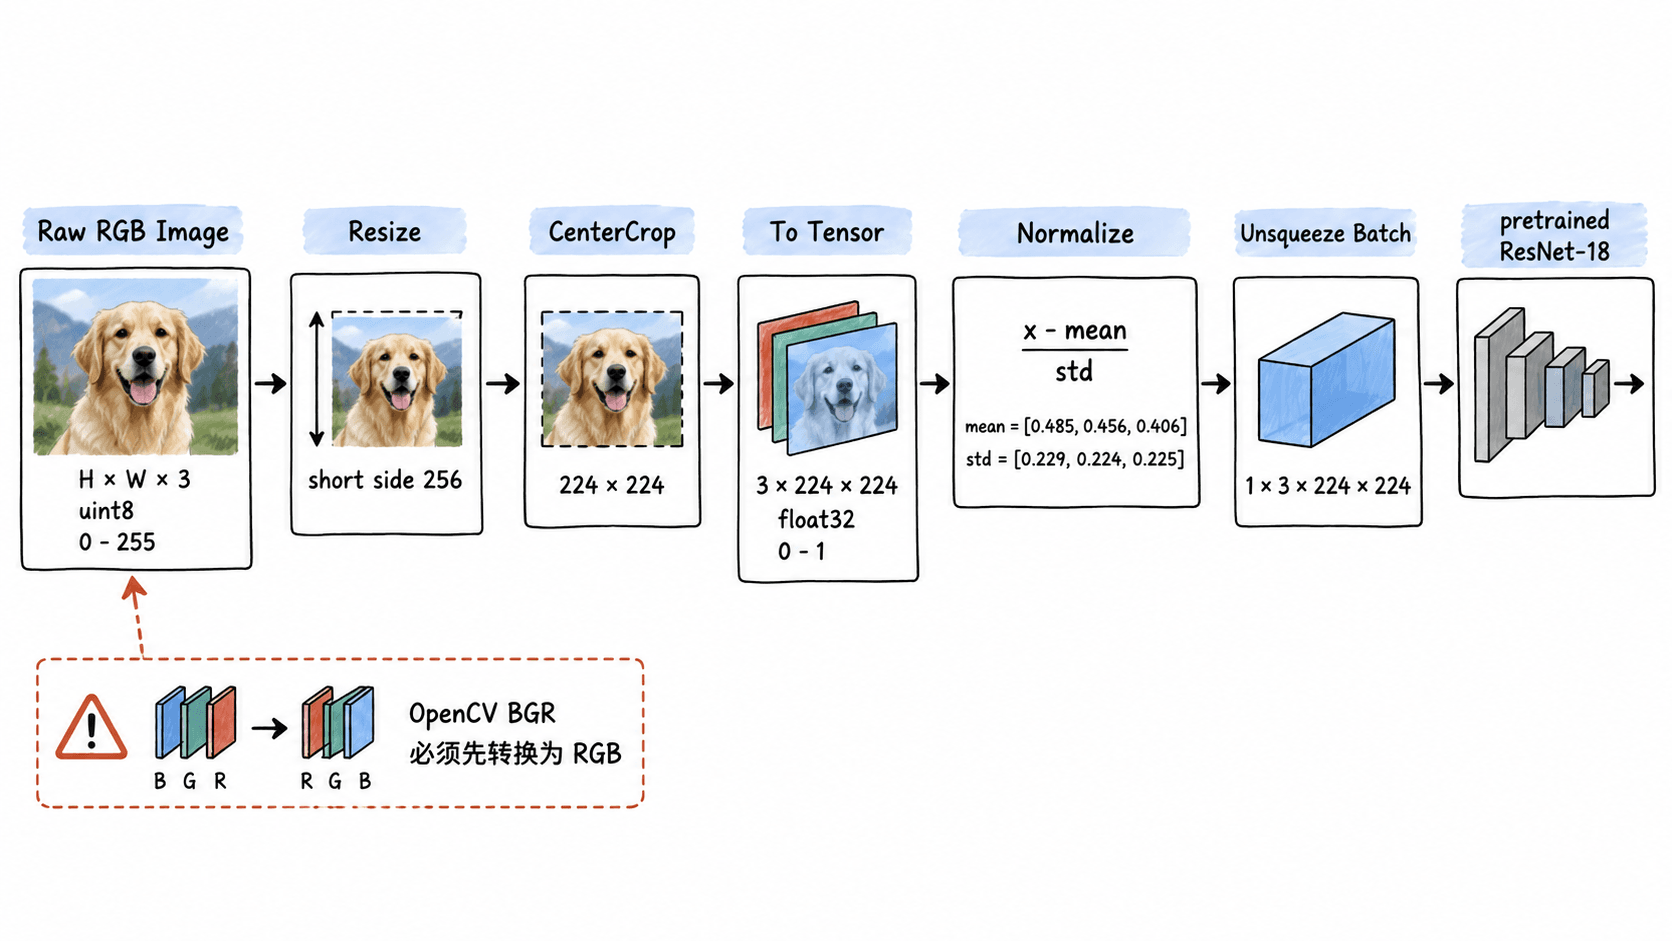
现代 torchvision 应优先使用权重枚举的 transforms()。以 ResNet18_Weights.DEFAULT 为例,验证和推理预处理会把短边缩放到 256,再中心裁剪为 224×224,转换为浮点张量并按 ImageNet 统计量归一化。weights= API 适用于 torchvision 0.13 及之后版本,并替代旧式的 pretrained=True。
| 项目 | ResNet-18 默认权重输入规范 |
|---|---|
| 通道语义 | RGB,3 通道 |
| 缩放 | 短边调整到 256 |
| 裁剪 | CenterCrop 224×224 |
| 张量布局 | C×H×W |
| 数值类型 | torch.float32 |
| 归一化均值 | [0.485, 0.456, 0.406] |
| 归一化标准差 | [0.229, 0.224, 0.225] |
不要仅因为模型接受形状为 224×224 的张量,就认为输入已经匹配。把 BGR 当 RGB、把 0~255 直接送入归一化,或者再执行一次 Normalize,都会改变预训练特征看到的数值分布。
看清从图像到模型张量的处理链
同一张图在进入模型前会依次经历空间变换、数值缩放、通道归一化和 batch 组装。特别是 OpenCV 默认读取 BGR,而 Pillow 与 torchvision 的常见预训练流程使用 RGB,这一步错位不会触发形状错误,却会直接改变颜色特征。
用可运行样例核对张量
下面使用一张 300×300 的纯色 RGB 图像,因此缩放和裁剪不会改变像素值,可以直接验证归一化结果。这个示例不需要下载模型权重文件,因为这里只读取权重对应的预处理配置。
from PIL import Image
import torch
from torchvision.models import ResNet18_Weights


def main():
    weights = ResNet18_Weights.DEFAULT
    preprocess = weights.transforms()

    # 固定 RGB 像素让归一化后的三个通道值可重复验证。
    image = Image.new("RGB", (300, 300), color=(128, 64, 32))
    x = preprocess(image)

    print(x.shape)
    print(x.dtype)
    print([round(v, 4) for v in x[:, 0, 0].tolist()])

    batch = x.unsqueeze(0)
    print(batch.shape)


if __name__ == "__main__":
    main()
预期输出:
torch.Size([3, 224, 224])
torch.float32
[0.0741, -0.9153, -1.2467]
torch.Size([1, 3, 224, 224])
归一化后的数值出现负数是正常现象。最后的 unsqueeze(0) 增加 batch 维度,单张图因此从 3×224×224 变为 1×3×224×224,可以直接传给 ResNet-18。
训练增强可以变,归一化规范不要变
训练集通常不必完全照搬中心裁剪。自然图像分类可以使用 RandomResizedCrop(224, scale=(0.8, 1.0)) 和 RandomHorizontalFlip(p=0.5) 增加变化,但最终仍应得到 RGB、3×224×224,并继续使用与预训练权重一致的均值和标准差。验证集和推理输入则应使用确定性的 weights.transforms(),避免随机增强让指标抖动。
如果类别与方向有关,例如左右箭头、文字或道路方向标志,不应机械加入水平翻转。此时保留随机裁剪或轻微颜色增强,比把标签语义一起翻转更安全。
发现错配时按张量值排查
遇到迁移后准确率异常低,先检查输入,而不是立刻改学习率。灰度图先执行 image.convert("RGB");OpenCV 图像在转成 PIL 或张量前使用 cv2.cvtColor(image, cv2.COLOR_BGR2RGB);已经经过 weights.transforms() 的张量不要再次执行同一组 Normalize。
还应在首个 batch 打印 images.shape、images.dtype 以及最小值和最大值。正确形状通常是 N×3×224×224,类型为 torch.float32;归一化后数值不再限制在 0~1。只要尺寸、通道语义和数值处理三项都与预训练权重一致,模型看到的输入分布才真正完成对齐。