
机器学习与深度学习 / 系统课时
规划综合图像分类项目
规划综合图像分类项目
综合项目先要把“训练一个模型”改写成可验收的工程任务。下面以 5 类商品图片分类为例,把数据门槛、切分规则、评价指标和交付物一次定清,避免训练结束后才发现指标口径、测试集或部署输入不一致。
学习目标
- 把 5 类图像分类任务写成带数据量、切分和质量门槛的验收标准。
- 用 Accuracy 与 Macro-F1 建立可执行的模型准入条件。
- 明确权重、标签映射、预处理规范和评估报告等最终交付物。
把需求写成可验收任务
一个可执行的项目目标至少要回答“分什么、数据从哪来、怎样算合格、最终交什么”。本例把输入限定为 RGB 商品图,目标类别数为 5,每类至少 400 张可用图片;任何损坏文件、错标样本和跨集合重复图片都必须在训练前处理。
| 项目项 | 本例约束 | 验收方式 |
|---|---|---|
| 类别 | 5 类,标签固定为 0~4 | labels.json 中恰好 5 个类别 |
| 数据量 | 每类至少 400 张有效图片 | 数据检查脚本按类别计数 |
| 输入 | RGB,训练输入 224×224 | 随机抽取一个 batch 检查形状 |
| 切分 | train/val/test = 70%/15%/15% | 三个索引集合无交集 |
| 主指标 | Macro-F1 ≥ 0.85 | 只在冻结测试集上最终计算 |
| 辅指标 | Accuracy ≥ 0.88 | 与 Macro-F1 同时达标才通过 |
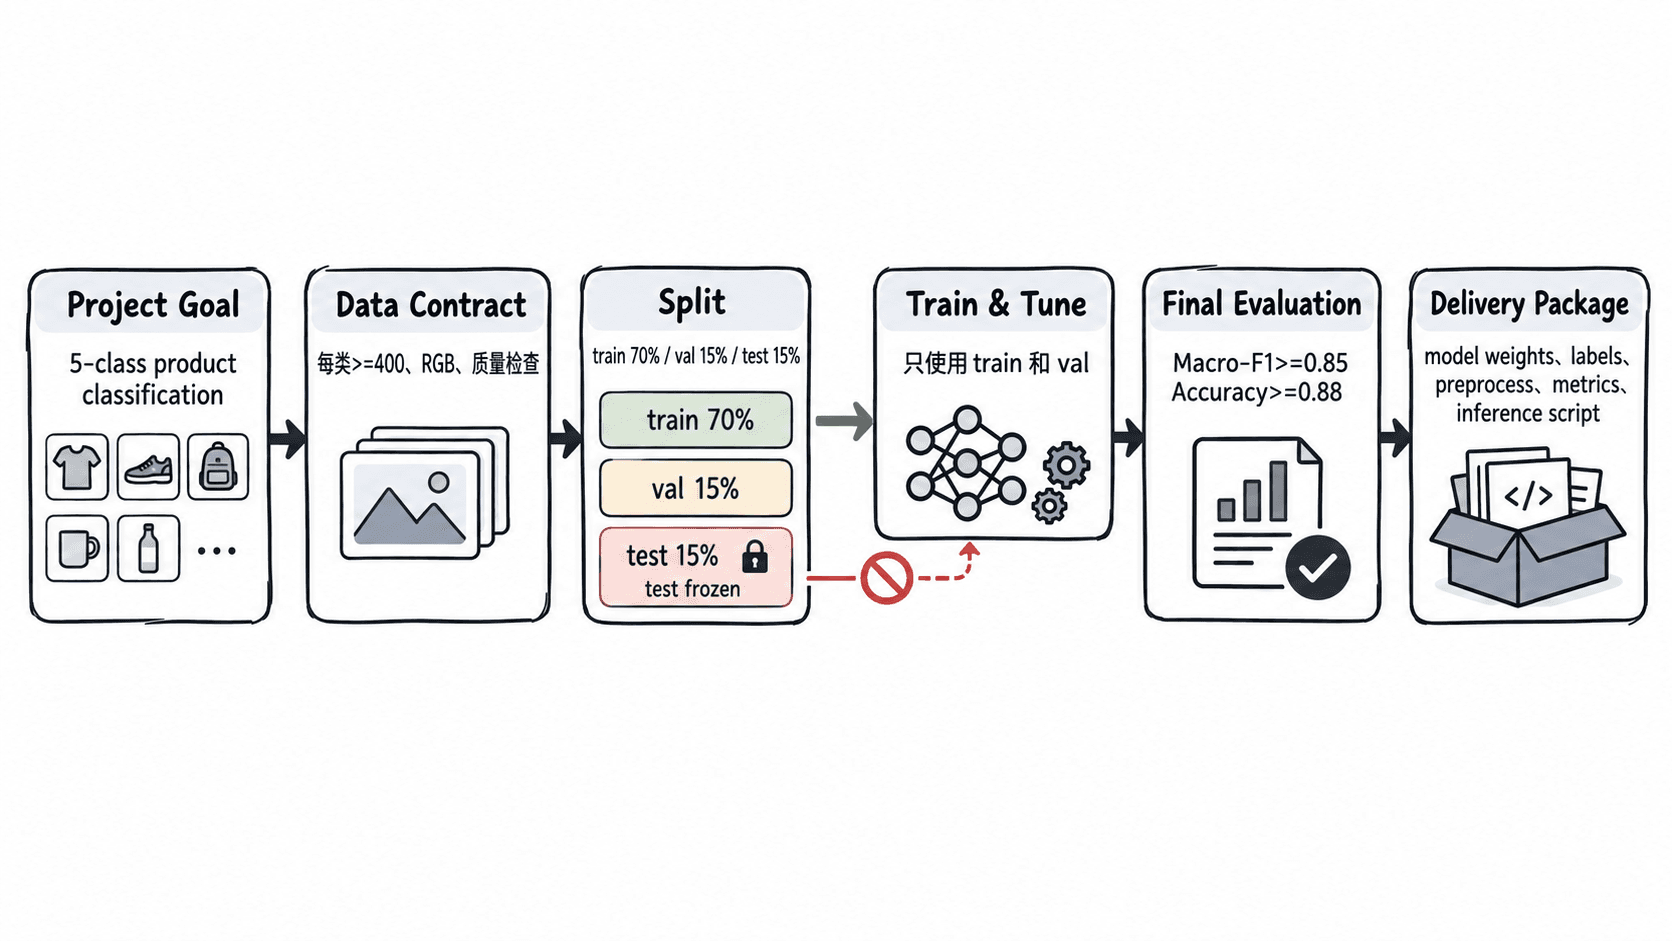
如果同一商品存在连拍图、同一视频抽帧或同一 SKU 的近重复图片,不能先随机打散再切分。应先按 product_id 或拍摄批次分组,再把整组分配到某一个集合,否则几乎相同的图会同时出现在训练集和测试集,测试分数会虚高。
固定评估口径
类别样本不完全均衡时,单看 Accuracy 容易掩盖小类问题,因此本例把 Macro-F1 设为主指标。模型选择只看验证集;测试集在项目开始时冻结,训练方案、增强强度和学习率都确定后才做一次最终验收。
下面用 PyTorch 直接从预测标签计算混淆矩阵、Accuracy 和 Macro-F1,阈值与项目验收表保持一致。
import torch

y_true = torch.tensor([0, 0, 1, 1, 2, 2, 3, 3, 4, 4])
y_pred = torch.tensor([0, 0, 1, 1, 2, 2, 3, 3, 4, 1])
num_classes = 5

cm = torch.zeros((num_classes, num_classes), dtype=torch.int64)
for target, pred in zip(y_true, y_pred):
    cm[target, pred] += 1

tp = cm.diag().float()
precision = tp / cm.sum(dim=0).clamp_min(1).float()
recall = tp / cm.sum(dim=1).clamp_min(1).float()
f1 = 2 * precision * recall / (precision + recall).clamp_min(1e-12)

accuracy = (tp.sum() / cm.sum()).item()
macro_f1 = f1.mean().item()
accepted = accuracy >= 0.88 and macro_f1 >= 0.85

print(f"accuracy={accuracy:.3f}")
print(f"macro_f1={macro_f1:.3f}")
print(f"accept={accepted}")
预期输出:
accuracy=0.900
macro_f1=0.893
accept=True
这个小程序只验证指标口径,不代替正式评估脚本。正式项目还应保存完整混淆矩阵和每类 precision、recall、F1,便于定位“总体合格但某个类别明显偏弱”的情况。
固定数据与实验边界
建议在第一次训练前写下不可随意变化的实验约束:随机种子固定为 2026,训练集只负责参数学习,验证集负责模型选择,测试集禁止参与阈值调整和超参数搜索。若后续新增数据,应重新生成一个带版本号的数据清单,例如 dataset-v2.csv,而不是偷偷替换原测试样本。
训练记录至少包含数据版本、模型名称、预训练权重版本、输入尺寸、batch size、优化器、初始学习率、epoch 数和最佳验证指标。一个实际可复现的基线可以先定为:输入 224×224、batch size 32、AdamW、初始学习率 3e-4、最多 30 个 epoch,并以验证集 Macro-F1 保存最佳权重;这些数值是起点,不是必须追求的最终最优值。
定义交付包
项目验收不应只收到一个 .pt 文件。最低交付包可以固定为以下 6 项,并在发布前逐项检查。
| 文件 | 必须包含的内容 |
|---|---|
model_state_dict.pt |
最佳模型参数 |
labels.json |
类别索引与类别名一一对应 |
preprocess.json |
输入尺寸、归一化 mean/std、颜色空间 |
metrics.json |
测试集 Accuracy、Macro-F1、数据版本 |
infer.py |
单张图片推理入口 |
README.md |
环境版本、运行命令、输入输出示例 |
最终验收应同时检查“指标达标”和“别人能复现”。如果同一份图片在训练脚本和推理脚本里采用不同的 resize、crop 或 normalization,即使权重本身正确,也应判为交付失败。