
机器学习与深度学习 / 系统课时
理解卷积运算
理解卷积运算
卷积层通过一个小尺寸卷积核在图像上滑动,把局部像素组合成新的特征图。本篇用可计算的例子说明卷积核、步长和填充如何决定每个输出值与输出尺寸,并用 PyTorch Conv2d 验证计算结果。
学习目标
- 理解卷积核在输入特征图上的滑动与局部加权过程。
- 根据 kernel size、stride 和 padding 计算输出特征图尺寸。
- 读懂
nn.Conv2d的输入通道、输出通道与权重形状。
卷积核如何生成一个输出值
假设输入是一张 4 × 4 的单通道特征图,卷积核为 2 × 2,四个权重都等于 1,stride=1、padding=0。卷积核覆盖左上角四个数 1、2、5、6 时,第一个输出值就是 1+2+5+6=14。
卷积核向右移动一格后覆盖 2、3、6、7,得到 18;继续按相同步长扫描整张输入,最终得到 3 × 3 的输出特征图。PyTorch 的 Conv2d 实际执行的是交叉相关运算,即卷积核不会先做数学定义中的 180° 翻转,但深度学习中仍习惯称它为卷积层。
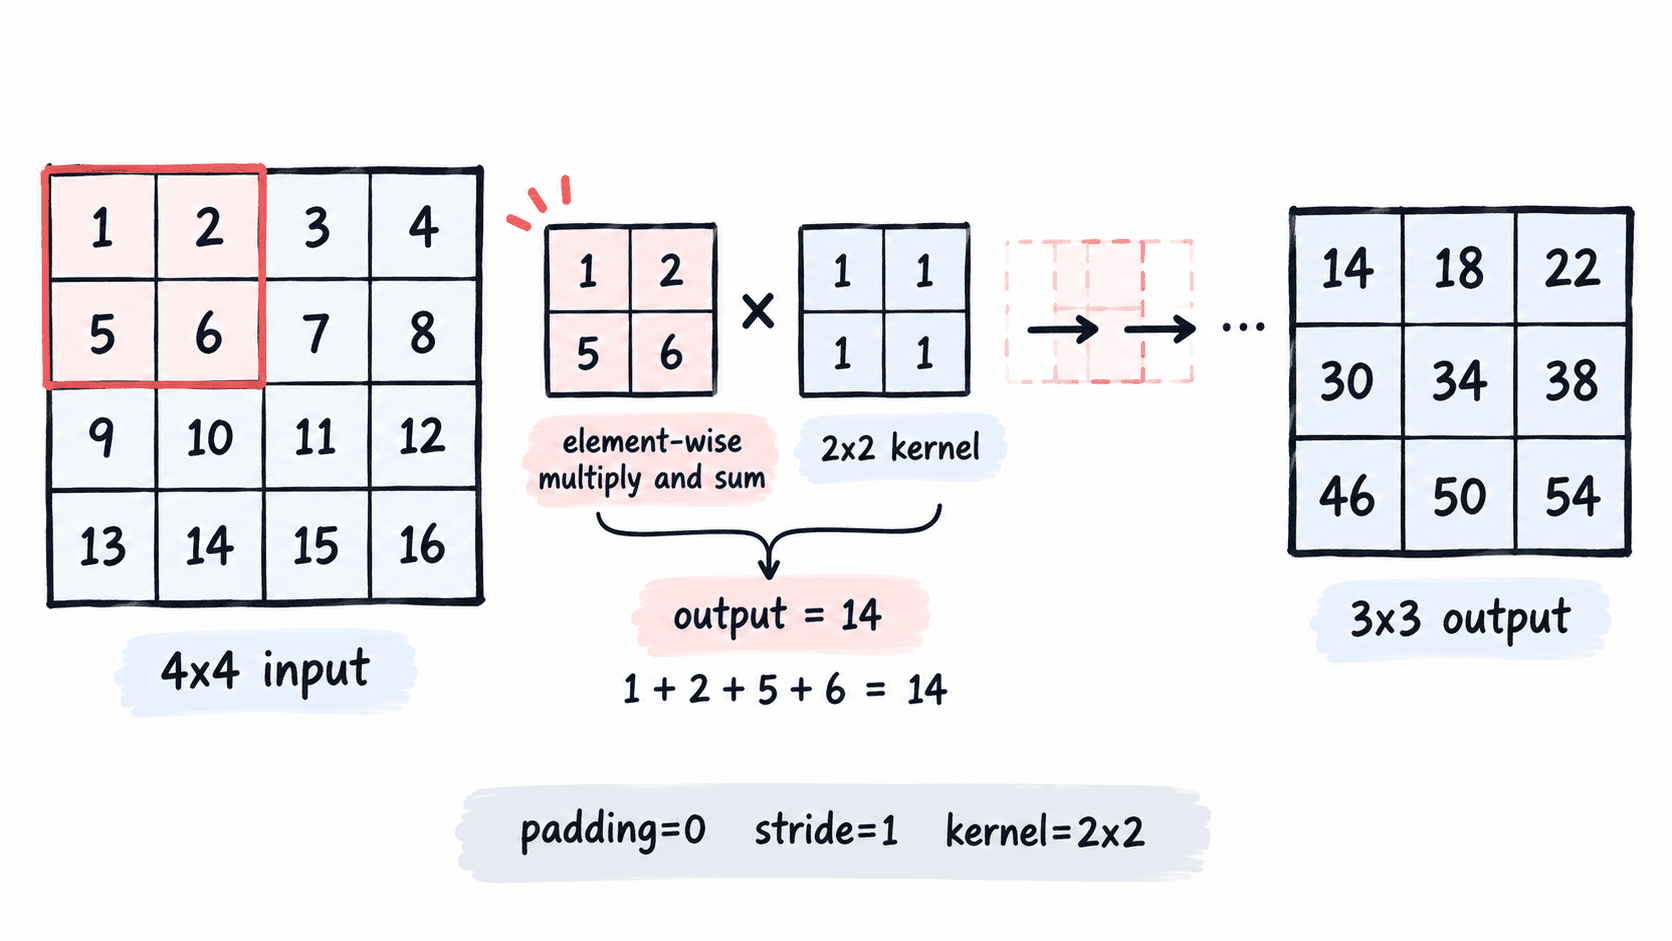
计算输出空间尺寸
当 dilation 为默认值 1 时,单个空间维度的输出尺寸可以按下面的规则计算:
其中 H 是输入高度,K 是卷积核尺寸,P 是 padding,S 是 stride。宽度使用同样的计算方法。
例如输入高度为 32,使用 kernel_size=3、stride=2、padding=1:先得到 32 + 2 × 1 - 3 = 31,再用 31 除以 2 并向下取整得到 15,最后加 1,因此输出高度为 16。宽度同为 32 时,最终输出空间尺寸就是 16 × 16。
一个常用组合是 kernel_size=3、stride=1、padding=1。对于高度和宽度都大于 1 的普通图像,它会保持空间尺寸不变;把 stride 改为 2,则常用于下采样。
用 Conv2d 复现滑动计算
下面把卷积层权重固定为 1,并关闭 bias,使程序结果与前面的手算完全对应。
import torch
from torch import nn

x = torch.arange(1, 17, dtype=torch.float32).reshape(1, 1, 4, 4)
conv = nn.Conv2d(1, 1, kernel_size=2, stride=1, padding=0, bias=False)

with torch.no_grad():
    conv.weight.fill_(1.0)

y = conv(x)
print(y.shape)
print(y[0, 0])
预期输出:
torch.Size([1, 1, 3, 3])
tensor([[14., 18., 22.],
        [30., 34., 38.],
        [46., 50., 54.]], grad_fn=<SelectBackward0>)
这里输入形状是 [N, C, H, W] = [1, 1, 4, 4],输出仍保留 batch 和 channel 两个维度,因此完整输出形状为 [1, 1, 3, 3]。
通道与卷积核数量
对 RGB 图像,in_channels=3 意味着每个输出卷积核都同时覆盖 R、G、B 三个输入通道。若使用 nn.Conv2d(3, 16, kernel_size=3),权重张量形状就是 [16, 3, 3, 3]:16 代表输出通道数量,每个输出通道都有一组覆盖 3 个输入通道的 3 × 3 权重。
这层共有 16 × 3 × 3 × 3 = 432 个权重;默认 bias=True 时再增加 16 个偏置,因此总参数量是 448。输出通道数由卷积核组数决定,不等于输入图像原本有多少个颜色通道。
选择 stride 与 padding
stride=1 适合在较密集的位置提取特征;stride=2 会减少输出的空间分辨率,也相应减少后续计算量。padding=1 配合 3 × 3、stride 1 常用于保持高宽,而 padding=0 会让输出逐层缩小。
实际建模时,先根据任务决定是否需要下采样,再计算每层输出尺寸并打印真实 shape 验证,可以避免在后续全连接层或残差连接处才暴露尺寸不匹配。