
机器学习与深度学习 / 系统课时
读取与清零梯度
读取与清零梯度
PyTorch 的参数梯度不会在每次反向传播后自动清空,而是累积到 .grad 中。这个行为既支持梯度累积,也很容易让普通训练多算一倍。本课用固定数值观察梯度从 None 到 8、再累积到 16,并用 zero_grad 恢复正确训练顺序。
学习目标
- 读取参数
.grad并区分None、零张量和非零梯度 - 验证连续两次
backward()会产生梯度累积 - 使用
optimizer.zero_grad(set_to_none=True)在训练迭代之间清理梯度
用固定算例读取梯度
下面创建一个无偏置线性层,权重固定为 1.0。输入 x=2、目标 y=0 时,预测值为 2,平方损失为 4,对权重的梯度为 8。脚本连续执行两轮反向传播,再清零并重新计算一次。
import torch
from torch import nn

model = nn.Linear(1, 1, bias=False)
with torch.no_grad():
    model.weight.fill_(1.0)

optimizer = torch.optim.SGD(model.parameters(), lr=0.1)
x = torch.tensor([[2.0]])
target = torch.tensor([[0.0]])

print("before backward:", model.weight.grad)

loss = (model(x) - target).pow(2).mean()
loss.backward()
print(f"after first backward: {model.weight.grad.item():.1f}")

loss = (model(x) - target).pow(2).mean()
loss.backward()
print(f"after second backward: {model.weight.grad.item():.1f}")

optimizer.zero_grad(set_to_none=True)
print("after zero_grad:", model.weight.grad)

loss = (model(x) - target).pow(2).mean()
loss.backward()
print(f"after new backward: {model.weight.grad.item():.1f}")
预期输出
before backward: None
after first backward: 8.0
after second backward: 16.0
after zero_grad: None
after new backward: 8.0
看懂 None、8 和 16
第一次 backward() 后得到 8,说明当前批次已把梯度写入参数。第二次重新前向并反向后变成 16,因为 .backward() 默认执行累加,相当于旧梯度 8 加上新梯度 8,并不会自动覆盖。
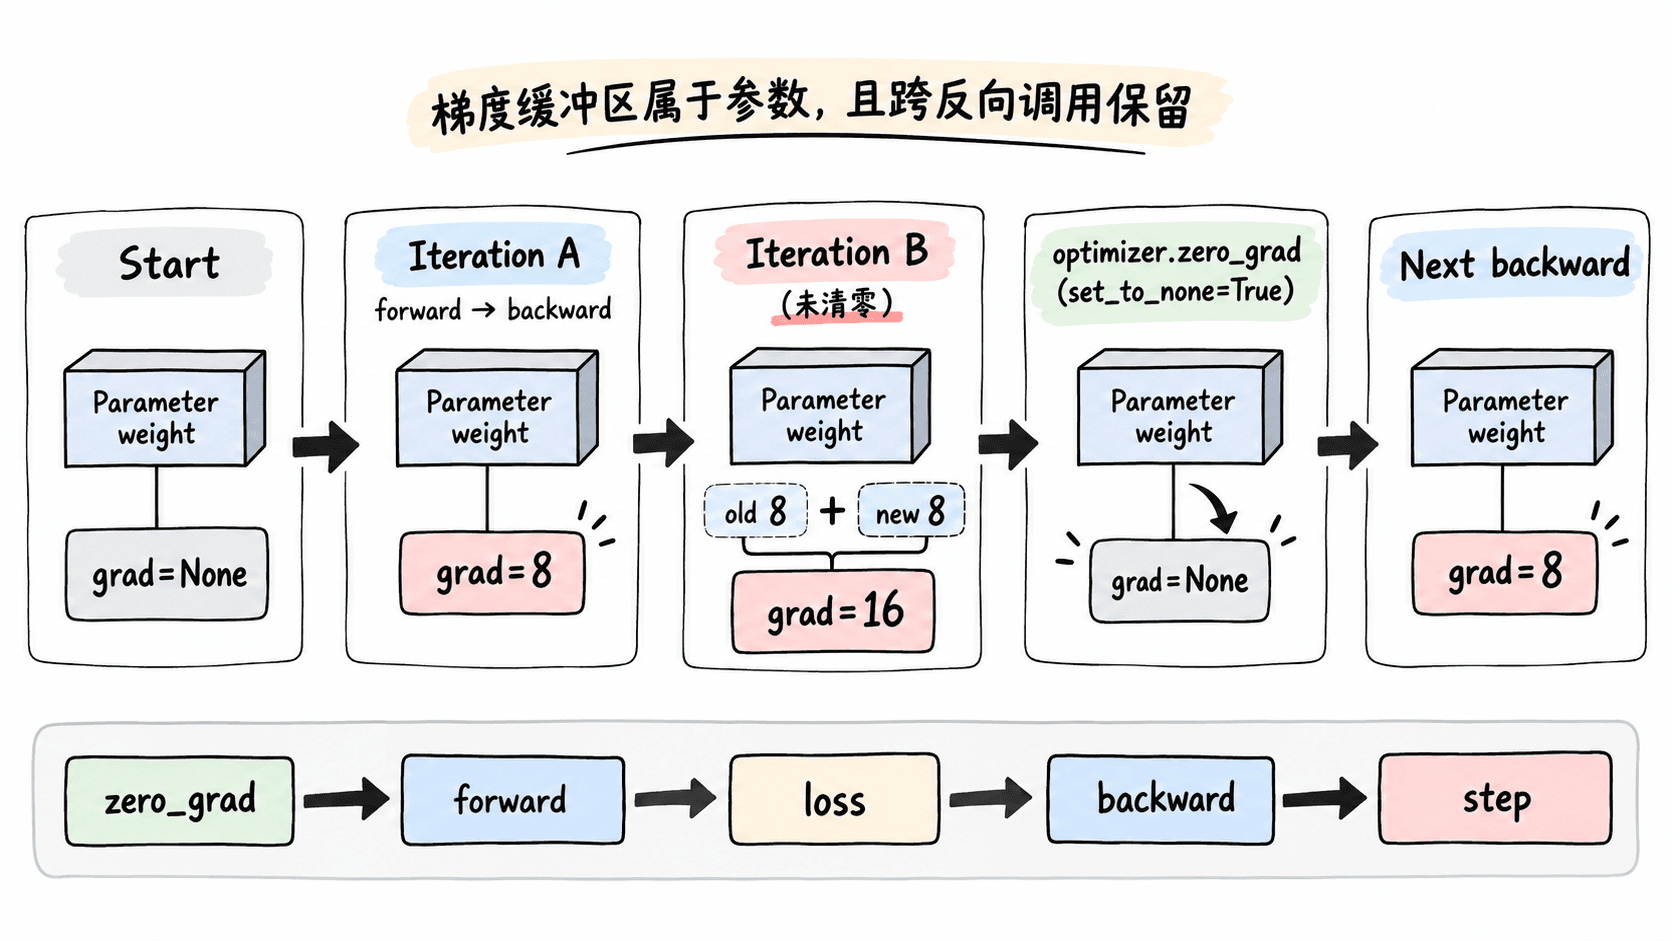
读取梯度时,parameter.grad is None 表示当前没有梯度张量;全零张量则表示梯度缓冲区存在,但数值全为零。调试训练时可先打印 name、param.grad is None 和梯度范数,快速发现某层是否根本没有参与损失计算。
选择怎样清零
推荐通过优化器清理它所管理参数的梯度。optimizer.zero_grad(set_to_none=True) 会把梯度设为 None;set_to_none=False 则把已有梯度写成零张量。两种方式都能阻止上一轮数值继续累积。
set_to_none=True 通常能减少写零操作,也让“本轮没有收到梯度”和“本轮梯度恰好为零”更容易区分。需要手工处理单个张量时,也可以在确认 .grad 不为 None 后调用 param.grad.zero_(),但常规模型训练优先使用优化器的 zero_grad。
训练循环里的正确顺序
普通“一批数据更新一次参数”的训练固定采用:清零旧梯度、前向计算、计算损失、反向传播、更新参数。检查代码时,确认每个 optimizer.step() 前都有一次对应的 loss.backward(),并且下一轮开始前执行 optimizer.zero_grad(...)。
真正做梯度累积时才故意跳过若干次清零。例如累计 4 个 micro-batch,可将每个 micro-batch 的损失除以 4 后执行 backward(),第 4 次再 step() 并清零。这样累积是显式设计,而不是无意把上一批的 .grad 带进下一批。