
机器学习与深度学习 / 系统课时
自定义网络类
自定义网络类
当网络不再是单纯的层顺序堆叠时,应继承 nn.Module,把子模块注册在 __init__ 中,并在 forward 中明确张量如何流动。本课用一个带残差分支的分类网络说明模块注册、前向计算和结构验收。
学习目标
- 能继承
nn.Module定义包含多个子模块的网络。 - 能在
forward中组织残差连接并判断各阶段张量形状。 - 能用参数量、子模块和输出形状检查自定义网络是否注册正确。
用 nn.Module 注册网络组件
nn.Module 会跟踪挂在实例属性上的子模块和参数,因此线性层、归一化层等应在 __init__ 中创建。下面的 ResidualBlock 保持 16 维特征不变,主干计算后与输入相加;Classifier 再把 8 维输入映射到 3 个类别。
import torch
from torch import nn
import torch.nn.functional as F

class ResidualBlock(nn.Module):
    def __init__(self, width: int) -> None:
        super().__init__()
        self.fc1 = nn.Linear(width, width)
        self.fc2 = nn.Linear(width, width)
        self.norm = nn.LayerNorm(width)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        # shortcut 与主分支必须保持相同形状,才能逐元素相加。
        shortcut = x
        x = F.relu(self.fc1(x))
        x = self.fc2(x)
        return self.norm(x + shortcut)

class Classifier(nn.Module):
    def __init__(self) -> None:
        super().__init__()
        self.stem = nn.Linear(8, 16)
        self.block = ResidualBlock(16)
        self.head = nn.Linear(16, 3)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        # stem 先统一特征宽度,再进入可复用的残差块。
        x = F.relu(self.stem(x))
        x = self.block(x)
        return self.head(x)

torch.manual_seed(7)
model = Classifier()
batch = torch.randn(4, 8)
# 调用 model(batch) 而不是直接调用 model.forward(batch)。
logits = model(batch)

print("shape:", logits.shape)
print("parameters:", sum(p.numel() for p in model.parameters()))
print("children:", list(dict(model.named_children()).keys()))
预期输出
shape: torch.Size([4, 3])
parameters: 771
children: ['stem', 'block', 'head']
这里的 771 个可训练参数来自 stem、残差块中的两层线性层与 LayerNorm、以及 head。如果某个子层没有出现在 model.parameters()、named_modules() 或 state_dict() 中,应先检查它是否真的注册成了 nn.Module 属性。
看清 forward 中的数据流
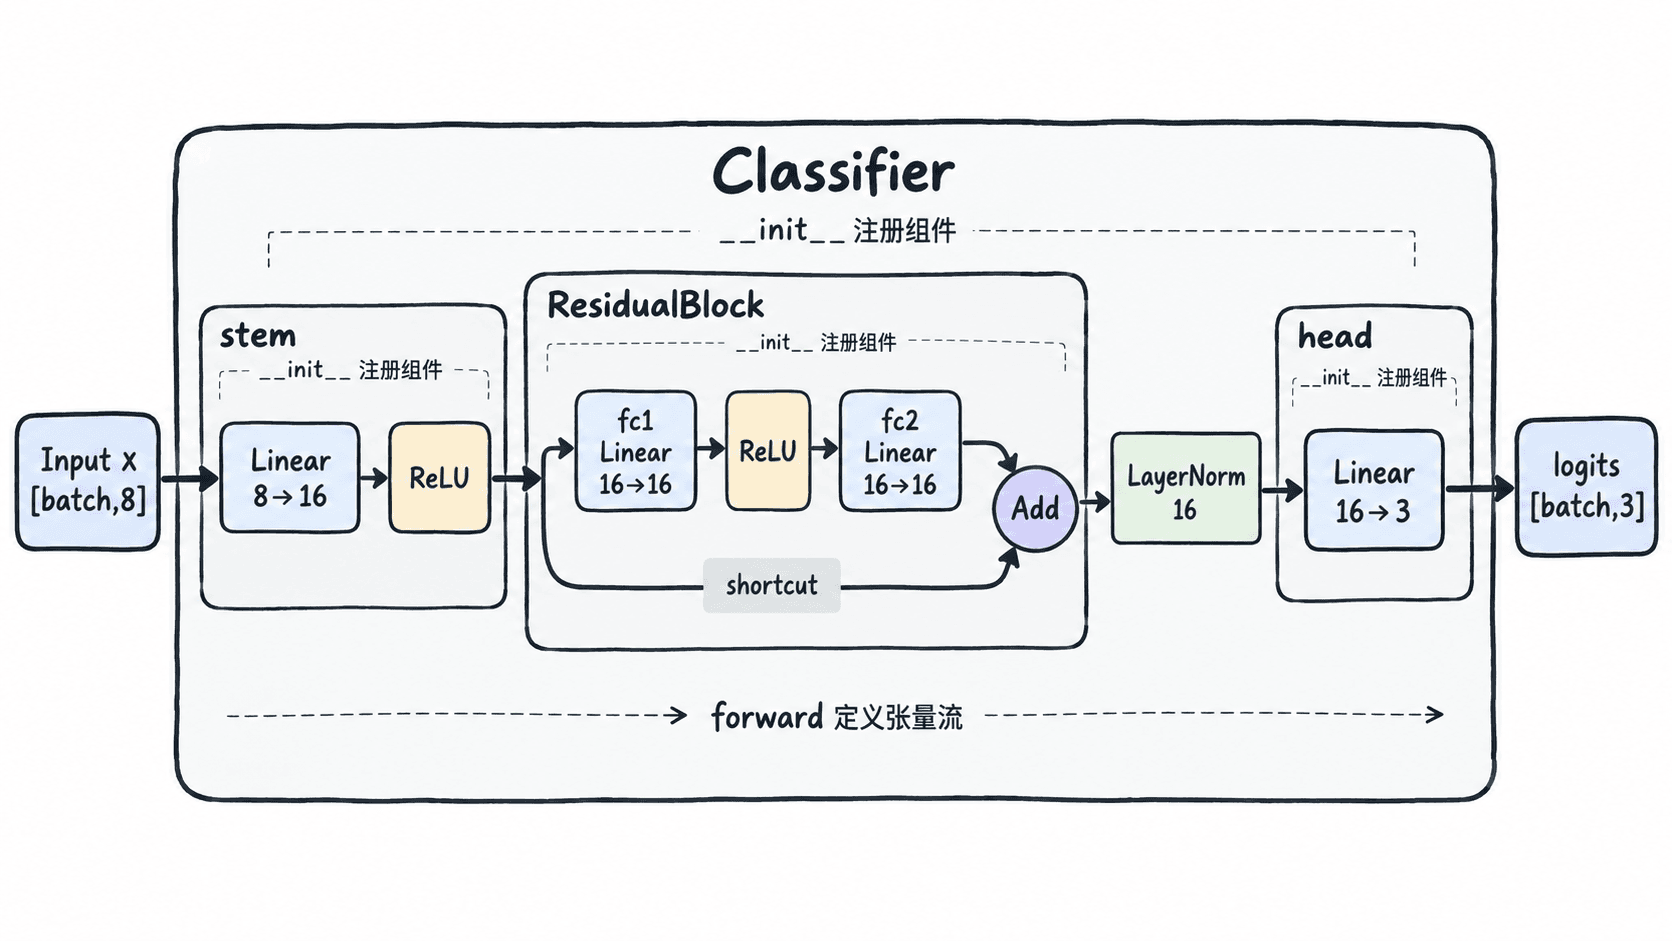
这个结构中,输入形状依次为 [4,8]、[4,16]、[4,16]、[4,3]。残差相加要求两路张量形状一致,所以 ResidualBlock(16) 的输入和输出都保持最后一维为 16;若把 fc2 改成 nn.Linear(16, 32),执行 x + shortcut 就会因 32 与 16 不匹配而报错。
用 ModuleList 管理可变数量的层
当层数由参数决定时,不要把子模块只放进普通 Python list。普通列表本身不会向父模块注册其中的层;应使用 nn.ModuleList,例如 self.layers = nn.ModuleList([nn.Linear(16, 16) for _ in range(3)]),再在 forward 中逐层调用。
可直接用两个检查判断是否正确:len(list(model.parameters())) 应大于 0;保存 model.state_dict() 时,所有需要训练和恢复的层都应出现对应键。类似地,按名称管理分支时使用 nn.ModuleDict,而不是普通 dict。
调用模型而不是直接调用 forward
训练和推理时应写 model(x),不要写 model.forward(x)。nn.Module.__call__ 会在调用 forward 前后处理 hooks 等机制,直接调用 forward 会绕过这些逻辑。切换模式则使用 model.train() 和 model.eval();如果网络中含 Dropout 或 BatchNorm,这两个模式会直接改变前向行为。
需要随模型保存并跟随设备移动、但又不参与梯度更新的张量,可用 register_buffer 注册,例如 self.register_buffer("threshold", torch.tensor(0.5))。这样执行 model.to("cuda") 或保存 state_dict() 时,缓冲区会与模型一起处理,而不会被优化器当成可训练参数。