
机器学习与深度学习 / 系统课时
理解序列数据
理解序列数据
序列数据的关键不只是“有很多元素”,而是元素的位置和前后关系会影响含义,而且不同样本往往长度不同。掌握这两点后,你才能正确理解文本、传感器记录等数据为什么需要位置、填充和掩码。
学习目标
- 判断一组数据是否具有顺序依赖,而不是普通固定长度特征。
- 解释变长序列在批处理时为什么需要填充、长度或掩码。
- 看懂 PyTorch 中常见的批次形状
[B, T]与[B, T, D]。
顺序为什么会改变含义
文本中“狗追猫”和“猫追狗”包含相同的三个词,但主客体关系完全不同;时间序列 [70, 72, 130] 与 [130, 72, 70] 也包含相同数值,却分别可能表示指标突然升高和持续回落。若把它们只当作无序集合,模型会丢失决定含义的位置信息。
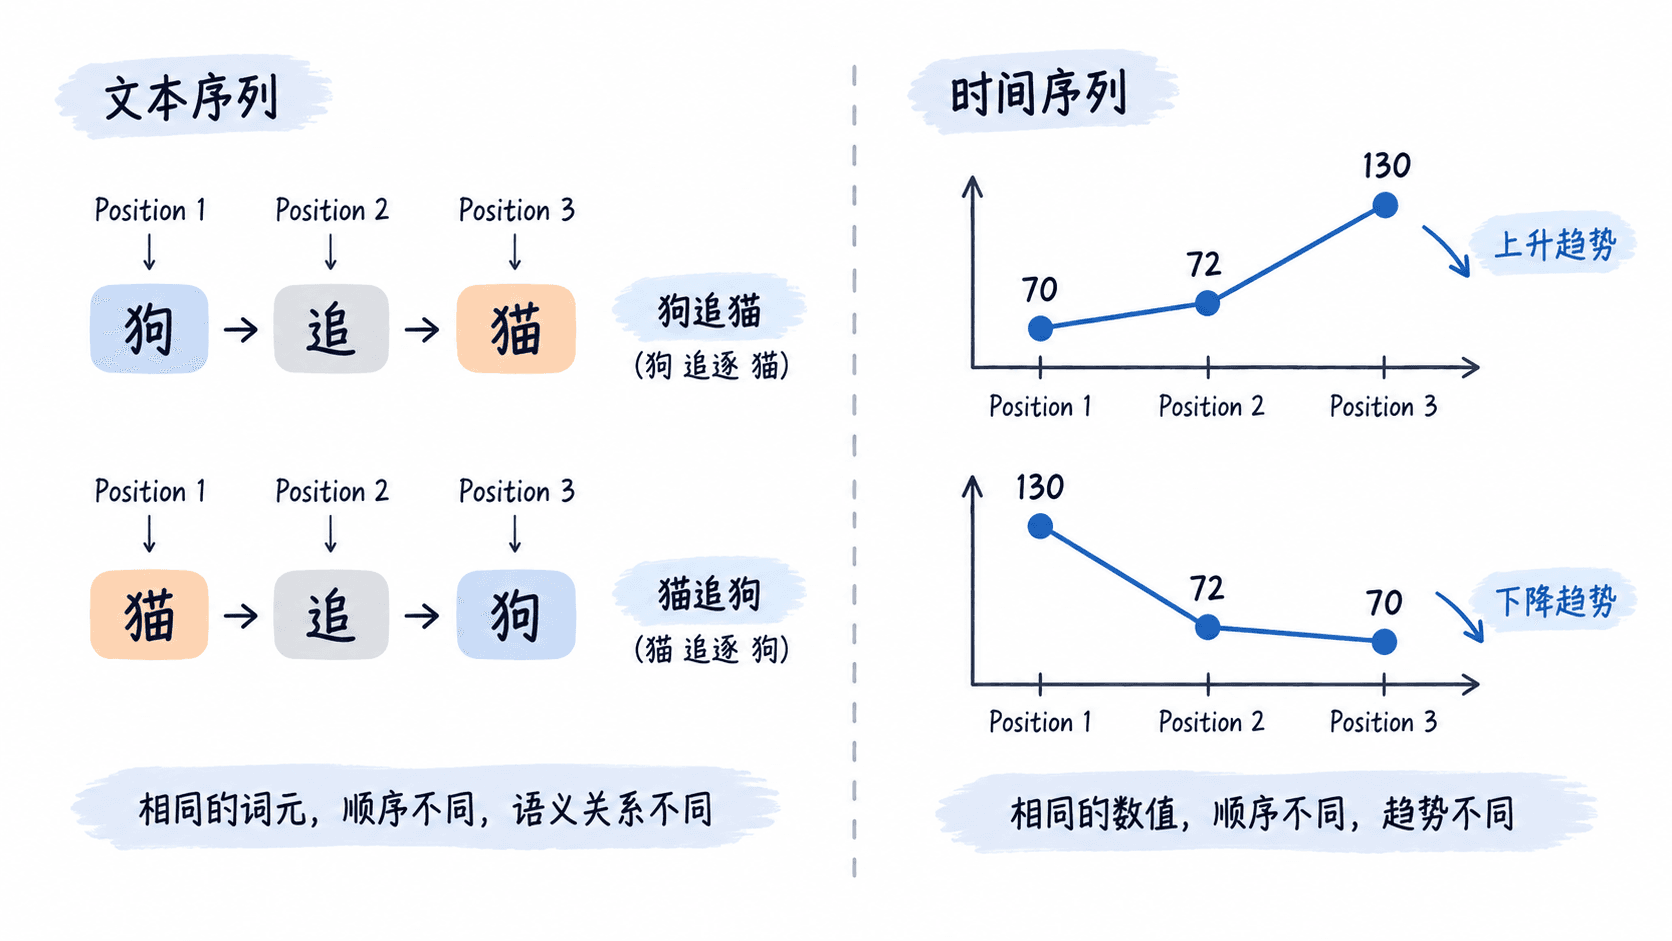
对序列模型来说,第 t 个元素通常要结合它之前、之后或整个序列的上下文解释。RNN 通过递归状态传递历史信息;Transformer 则依赖位置编码和注意力来区分“谁在第几个位置”。
变长序列如何组成批次
假设三个样本已经被编码成整数序列,长度分别为 4、2、3。一个批次必须形成规则张量,因此可以把短序列补到本批最大长度 4,并同时保留真实长度与有效位置掩码。
import torch
from torch.nn.utils.rnn import pad_sequence

sequences = [
    torch.tensor([11, 5, 8, 3]),
    torch.tensor([4, 9]),
    torch.tensor([7, 6, 2]),
]

padded = pad_sequence(sequences, batch_first=True, padding_value=0)
lengths = torch.tensor([len(x) for x in sequences])
mask = torch.arange(padded.size(1)).unsqueeze(0) < lengths.unsqueeze(1)

print(padded)
print(lengths)
print(mask)
预期输出
tensor([[11,  5,  8,  3],
        [ 4,  9,  0,  0],
        [ 7,  6,  2,  0]])
tensor([4, 2, 3])
tensor([[ True,  True,  True,  True],
        [ True,  True, False, False],
        [ True,  True,  True, False]])
这里的 0 只是填充值,不代表真实词元。lengths 记录每条序列的真实长度;布尔 mask 中的 False 可用于屏蔽补齐位置。实际项目里通常把 <pad> 固定到词表中的某个索引,再让后续模型按该索引生成掩码。
批次形状要和模型约定一致
未经过嵌入时,文本索引批次常见形状是 [B, T]:B 为批大小,T 为本批最大序列长度。经过 nn.Embedding 后通常变成 [B, T, D],其中 D 是每个词元的向量维度。例如 B=32、T=128、D=256 时,嵌入输出形状就是 [32, 128, 256]。
RNN 场景可以使用真实长度配合打包序列;Transformer 场景更常使用 padding mask。无论采用哪种模型,先把“真实数据”和“为了批处理而补出来的位置”分开,是处理变长序列最重要的边界。
判断一份数据是否真的需要按序列处理
先检查三个问题:交换元素顺序后含义是否改变;相邻或远距离位置之间是否存在依赖;样本长度是否会变化。三个问题中前两项只要有一项明显成立,就不应简单把数据压成无序统计量。对文本、点击流、日志事件和传感器采样,保留顺序后再决定截断、填充与掩码策略,通常比先固定长度再补救更可靠。