
机器学习与深度学习 / 系统课时
认识过拟合与欠拟合
认识过拟合与欠拟合
模型在训练集上表现好,并不代表它遇到新数据也能做对。判断模型是否真正学到了可泛化规律,需要同时观察训练集和验证集:两边都差通常是欠拟合,训练很好而验证明显变差则通常是过拟合。本篇用具体曲线和数值建立判断方法。
学习目标
- 根据训练损失和验证损失识别欠拟合、正常拟合与过拟合
- 使用泛化差距和最佳验证轮次判断训练是否应该继续
- 针对两类问题选择可验证的调整措施,而不是盲目增加训练轮数
同时看训练集和验证集
训练集用于更新参数,验证集只用于评估泛化表现。判断模型状态时至少要同时记录 train_loss 与 val_loss,分类任务还可以记录准确率等指标。
| 状态 | 训练表现 | 验证表现 | 典型判断 |
|---|---|---|---|
| 欠拟合 | 损失高、准确率低 | 同样较差 | 模型尚未把训练数据学好 |
| 合理拟合 | 训练较好 | 略差于训练但稳定 | 存在正常泛化差距 |
| 过拟合 | 持续改善 | 先改善后恶化 | 模型越来越依赖训练数据细节 |
例如训练准确率只有 68%,验证准确率为 66%,两边都低,首先应怀疑欠拟合;如果训练准确率达到 98%,验证准确率只有 84%,泛化差距达到 14 个百分点,就应重点检查过拟合。
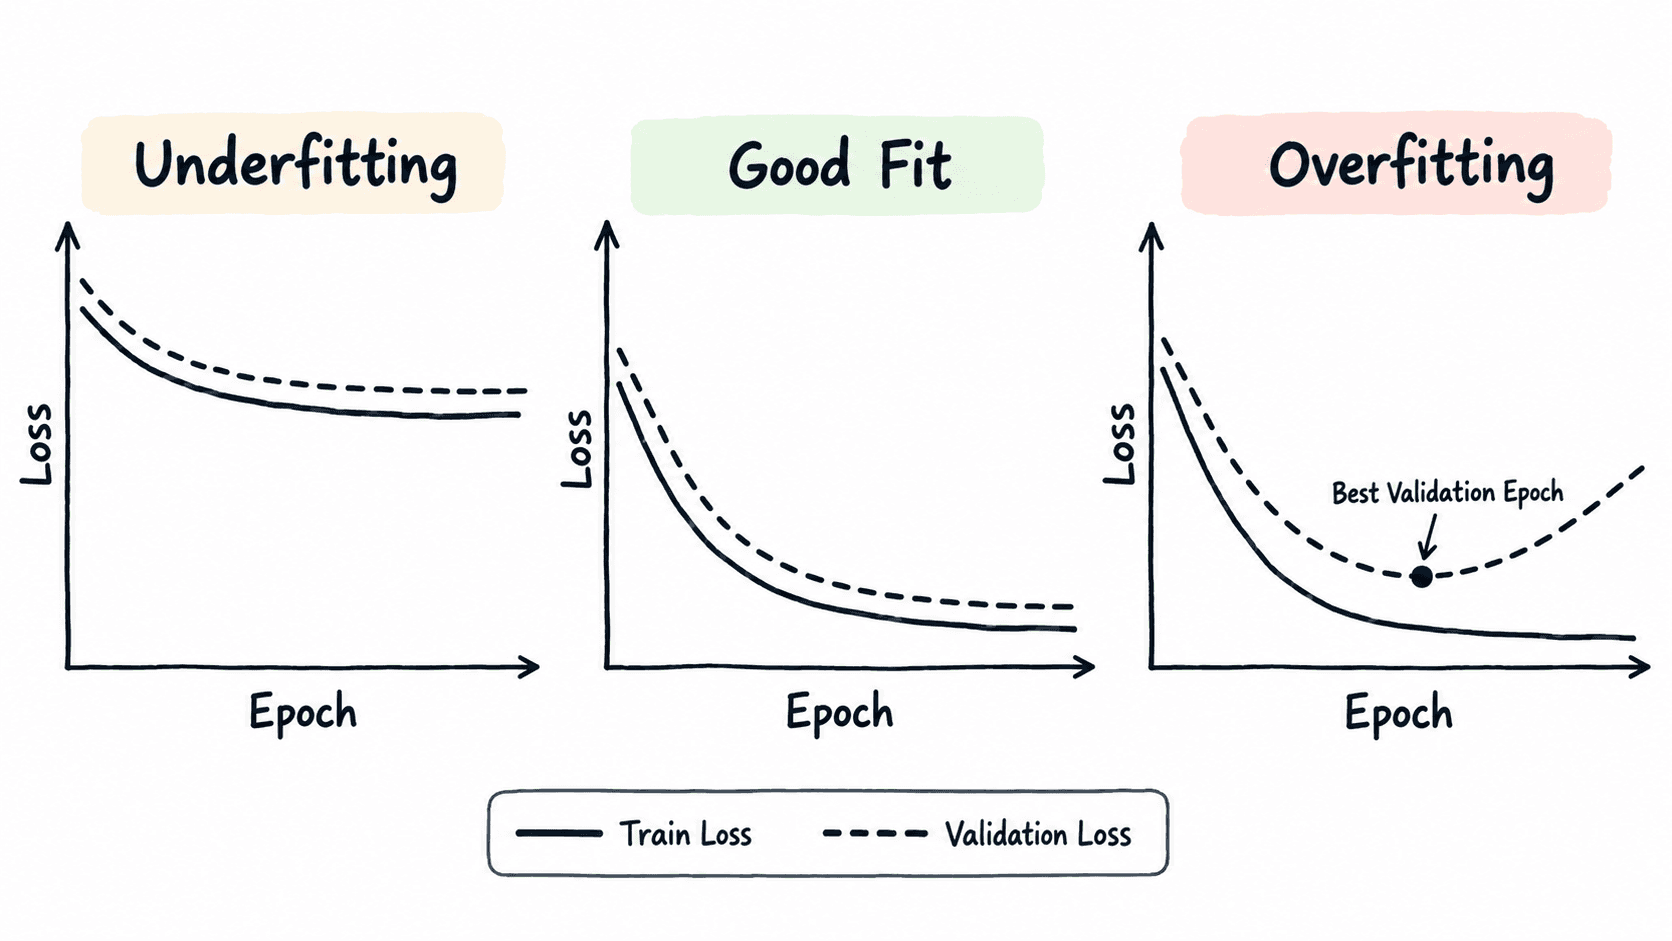
欠拟合意味着训练数据都没学好
欠拟合时,优先解决训练集表现,而不是先加更多正则化。假设一个图像分类器训练 5 个 epoch 后,训练准确率只有 61%,验证准确率 59%,两者只差 2 个百分点,但都明显低于业务要求的 90%,这属于典型欠拟合。
可按一次只改一个变量的顺序处理:
- 先把训练轮数从 5 增加到 20 或 30,观察训练损失是否仍明显下降。
- 如果训练损失很早就停在高位,再增加模型容量,例如把隐藏层宽度从 32 提高到 128。
- 如果使用了较强正则化,可将
weight_decay从1e-2降到1e-4做对照实验。 - 检查输入与标签本身,确认归一化、类别编号和损失函数搭配正确。
如果增加训练轮数后训练准确率从 61% 提升到 92%,而验证准确率同步达到 89%,说明原问题主要是训练不足,而不是模型结构必须重做。
过拟合意味着泛化开始退化
过拟合通常不是“验证指标完全不涨”,而是验证指标先改善,随后训练集继续变好、验证集却开始变差。下面是一组常见训练记录:
| Epoch | Train Loss | Val Loss | Train Accuracy | Val Accuracy |
|---|---|---|---|---|
| 1 | 0.82 | 0.88 | 65% | 63% |
| 5 | 0.43 | 0.50 | 83% | 80% |
| 10 | 0.27 | 0.38 | 91% | 87% |
| 15 | 0.18 | 0.46 | 96% | 85% |
| 20 | 0.12 | 0.61 | 98% | 81% |
这里第 10 个 epoch 的验证损失最低,之后训练损失继续下降,但验证损失从 0.38 升到 0.61。继续训练到第 20 个 epoch 并没有得到更好的模型,因此模型检查点应优先保留第 10 个 epoch 左右的权重。
常用修正包括把 Dropout 设为 p=0.2~0.5 做实验、给 AdamW 设置例如 weight_decay=1e-4、增加训练数据或只对训练集执行数据增强,以及使用 early stopping。若采用 early stopping,可从 patience=5 开始:验证指标连续 5 个 epoch 没有刷新最佳值时停止训练。
排除数据与评估流程造成的假象
看到训练与验证差距后,不要立即修改模型。数据泄漏、验证阶段仍启用训练行为、训练集与验证集分布差异过大,都可能制造类似过拟合的现象。
一个可执行的检查顺序是:
- 先按样本主体划分数据,例如 70% 训练、15% 验证、15% 测试;同一用户、同一患者或同一视频切出的相邻帧不要跨集合。
- 数据增强只作用于训练集。验证集应使用确定性的 resize、归一化等预处理,不能随机裁剪到每次结果都不同。
- 验证前调用
model.eval(),保证 Dropout 关闭且 BatchNorm 使用已统计的运行均值;验证完成后再切回model.train()。 - 最终测试集不要参与学习率选择、epoch 选择或结构调参,只在方案确定后用于一次独立评估。
如果训练准确率 98%、验证准确率 84%,但检查后发现训练集和验证集来自完全不同的数据采集设备,那么这 14 个百分点的差距不能简单归因于模型容量。先修正数据划分或明确跨域评估目标,再决定是否增加正则化。