
机器学习与深度学习 / 系统课时
认识人工智能与深度学习
认识人工智能与深度学习
人工智能、机器学习和深度学习经常被混用,但三者解决问题的方式和工程成本并不相同。本篇用层级关系、一个图像分类算例和可检查的选型条件,把三个概念放到同一套判断框架中。
学习目标
- 说清人工智能、机器学习与深度学习的包含关系
- 用训练数据、模型和损失函数解释一次典型学习过程
- 根据数据规模、可解释性和算力判断是否适合采用深度学习
三个概念的关系
人工智能是最大的范围,目标是让机器完成通常需要智能判断的任务;机器学习是其中一种实现方式,让模型从数据中学习规律;深度学习又是机器学习的一类,主要使用多层神经网络自动学习特征。
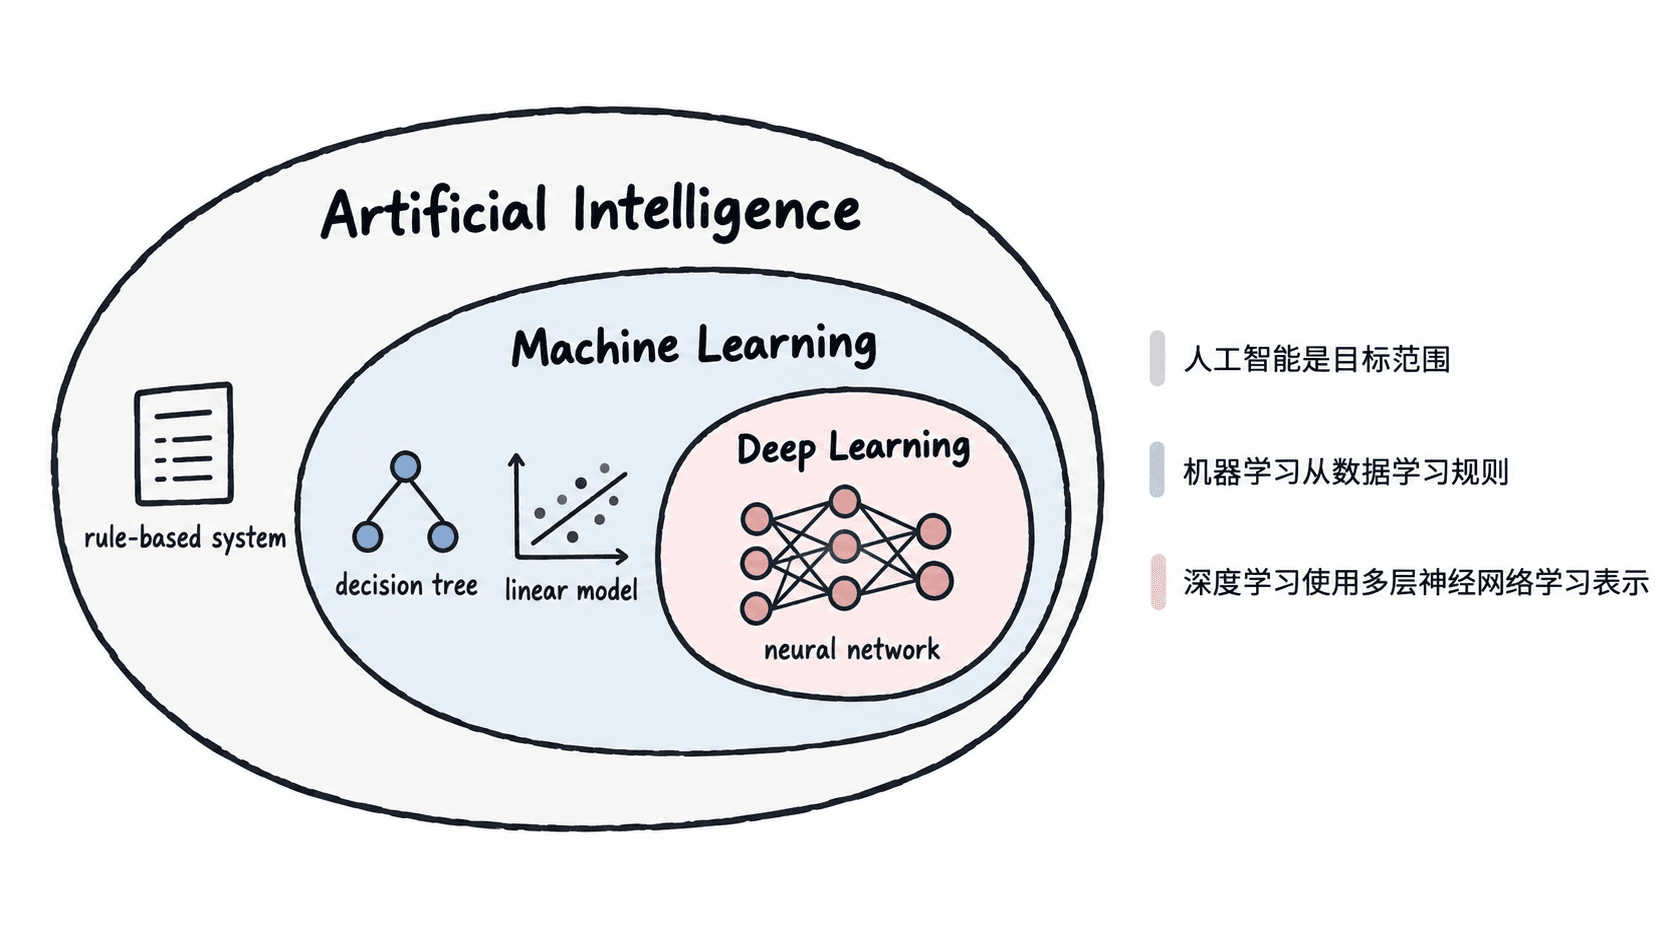
例如,一个完全由程序员编写规则的国际象棋程序属于人工智能,但不一定属于机器学习;使用历史房价训练线性回归模型属于机器学习;使用卷积神经网络识别猫狗图片则同时属于机器学习和深度学习。
用分类任务理解模型怎样学习
假设有 10000 张猫狗图片,可以先按 8:1:1 划分为 8000 张训练集、1000 张验证集和 1000 张测试集。训练阶段把图片输入神经网络,模型输出“猫”和“狗”的概率,再根据预测与真实标签之间的误差调整参数。
一次训练通常重复多个 epoch。例如训练 20 个 epoch 时,同一张训练图片最多会参与 20 轮参数更新;验证集用于选择模型和观察过拟合,测试集只在最终评估时使用,不能反复参与调参。
如果训练准确率达到 99%,而验证准确率只有 82%,这不是“模型已经很好”,而是明显的泛化差距。此时应优先检查数据规模、类别分布、数据增强和模型复杂度,而不是继续追求更高训练准确率。
判断问题是否值得使用深度学习
可以先检查三个条件。第一,输入是否复杂,例如图片、语音、自然语言或高维传感器数据;第二,是否有足够的训练样本或可用预训练模型;第三,业务是否允许较高的训练和推理成本。
例如,只有 500 行、20 个结构化字段的客户流失数据,先尝试逻辑回归、随机森林或梯度提升树通常更合适。相反,拥有 10 万张商品图片并需要自动识别数百种视觉模式时,卷积网络或视觉 Transformer 更有优势。
常见任务怎样对应输入与输出
| 任务 | 典型输入 | 模型输出 | 常用评估指标 |
|---|---|---|---|
| 图像分类 | 224×224 RGB 图片 | 每个类别的概率 | Accuracy、F1 |
| 目标检测 | 图片 | 边界框、类别、置信度 | mAP |
| 文本分类 | Token 序列 | 类别概率 | Accuracy、F1 |
| 回归预测 | 数值特征 | 连续数值 | MAE、RMSE |
判断一个深度学习项目是否真正完成,不能只看“模型能运行”。至少应明确输入格式、目标输出、独立测试集和量化指标,例如要求测试集 F1 不低于 0.90,这样训练结果才有可验收的标准。