
机器学习与深度学习 / 系统课时
认识神经元与网络层
认识神经元与网络层
神经网络并不是一组神秘的黑盒节点。单个神经元先对输入做加权求和并加上偏置,再经过激活函数;网络层只是把许多这样的计算并行组织起来。掌握输入形状、权重形状和参数量后,就能在搭建 PyTorch 模型时快速判断每一层是否连接正确。
学习目标
- 能根据输入、权重和偏置计算一个神经元的输出
- 能说明激活函数为什么让网络具备非线性表达能力
- 能根据相邻层宽度判断权重矩阵形状和参数数量
单个神经元如何计算
一个包含两个输入的神经元可以写成:
其中 是输入, 是权重, 是偏置, 是激活函数。设 、、、、,则加权和为 。
如果使用 ReLU,即 ,最终输出仍为 1.35。若把偏置从 0.1 改成 -1.5,新的 ,经过 ReLU 后输出变为 0。偏置因此可以理解为整体移动神经元响应阈值的可学习参数,而不是可有可无的常数。
激活函数提供非线性
如果连续多层都只做线性变换,那么无论叠多少层,整体仍等价于一次线性变换。加入非线性激活后,网络才可以表示弯曲的决策边界和复杂函数。
| 激活函数 | 表达式或范围 | 常见使用位置 |
|---|---|---|
| ReLU | 隐藏层的常见默认选择 | |
| Sigmoid | 输出范围 | 二分类概率或门控结构 |
| Tanh | 输出范围 | 需要零中心有界输出的结构 |
例如输入 时,ReLU 输出 0;输入 时输出 3。这种分段行为使一组神经元能够组合出非线性函数。实际分类模型中,隐藏层常用 ReLU,而最终输出层是否使用激活函数要由损失函数决定;例如多分类训练配合交叉熵损失时,通常直接提供未归一化的 logits,而不是先对每个输出做 ReLU。
从神经元组成网络层
全连接层会让每个输出神经元读取上一层的全部输入。假设一条样本有 4 个特征,隐藏层包含 8 个神经元,那么这一层需要一个 的权重矩阵和 8 个偏置;对于批量大小为 32 的输入,数据形状从 变为 。
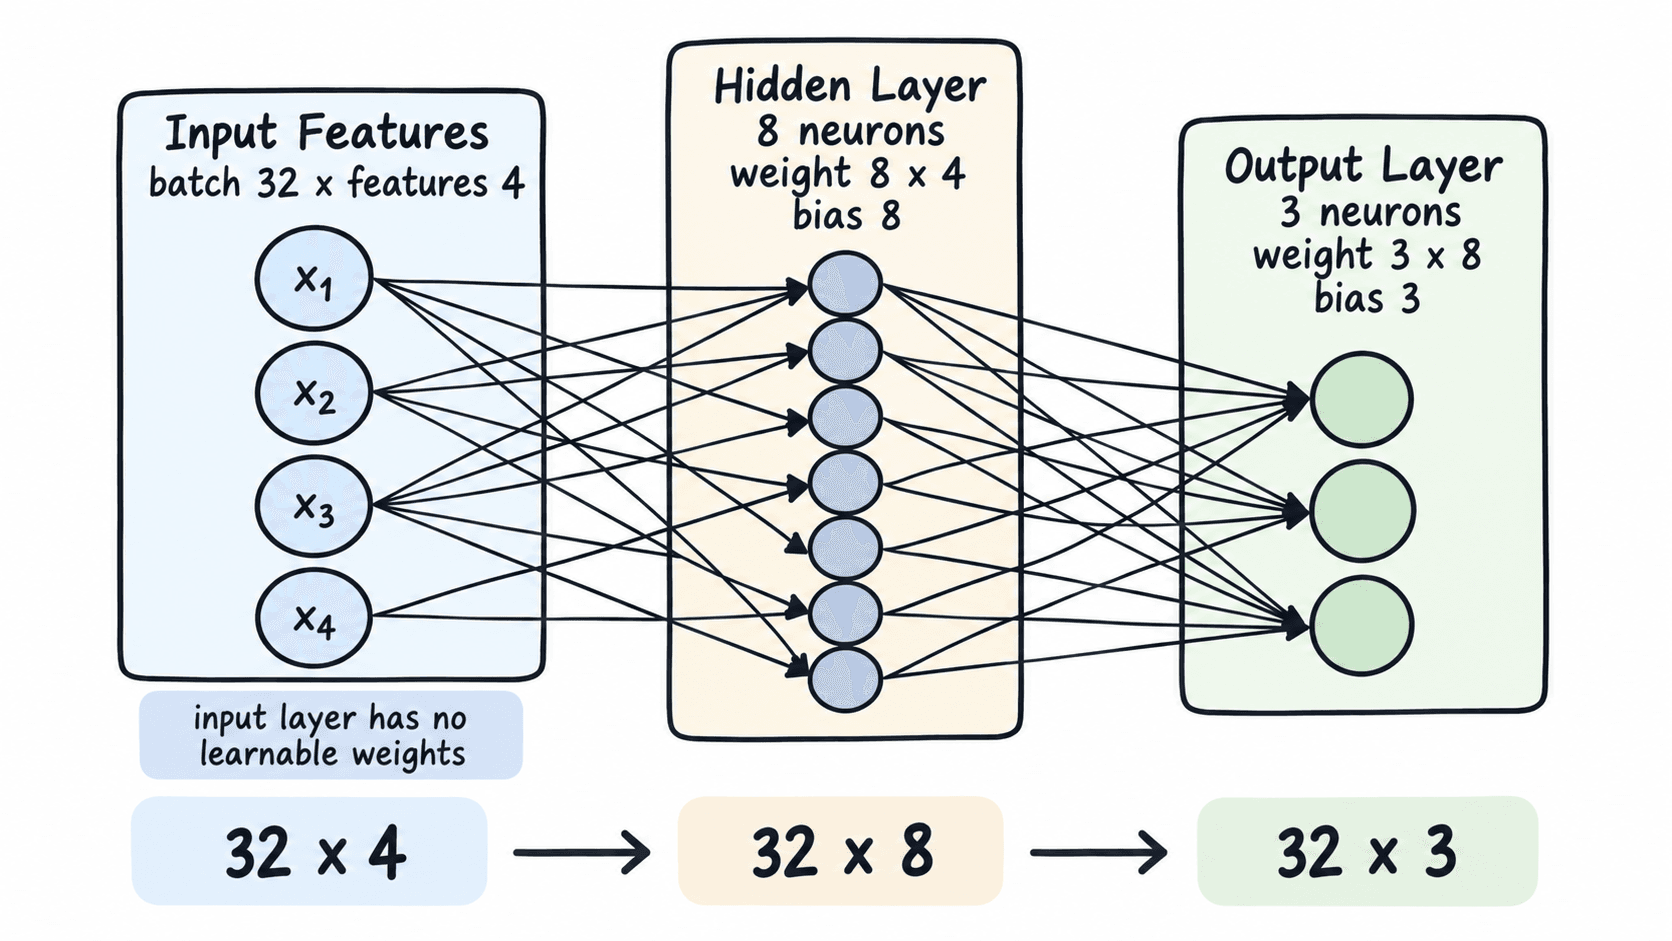
如果输出层有 3 个神经元,下一层权重形状就是 ,批量输出形状为 。这里的 32 是一次送入网络的样本数,不参与单个神经元权重数量的计算。
网络还可以按功能区分输入、隐藏和输出位置。输入端只是承载特征,不会因为有 4 个输入特征就自动产生 4 组可学习参数;真正的参数属于把上一层映射到下一层的权重和偏置。
用形状和参数量检查连接
层之间最容易出现的错误是把输入特征数和输出神经元数写反。对于从 4 个输入映射到 8 个输出的全连接层,参数量应为 ;从 8 个隐藏单元映射到 3 个输出时,参数量为 ,两层合计 67 个可学习参数。
可以用三个数字快速检查设计:上一层输出宽度必须等于下一层输入宽度;权重参数量等于输入宽度乘输出宽度;若启用偏置,还要再加上输出宽度。对于形状 的批量输入,经过宽度为 8 和 3 的两层后,应依次得到 和 。如果中间出现 直接与需要 8 个输入特征的层相连,就说明网络维度没有对齐。