
机器学习与深度学习 / 系统课时
理解梯度下降
理解梯度下降
训练神经网络时,模型不会直接知道哪组参数最好,而是先计算当前参数让损失变化得有多快,再沿降低损失的方向移动一小步。理解梯度、学习率和参数更新之间的关系,就能看懂 PyTorch 训练循环中 backward() 与参数更新到底在做什么。
学习目标
- 根据梯度的正负判断参数应该向哪个方向更新
- 使用梯度下降公式手算一次参数更新,并用 PyTorch 验证
- 判断学习率过小、合适或过大时的典型表现
从损失函数判断更新方向
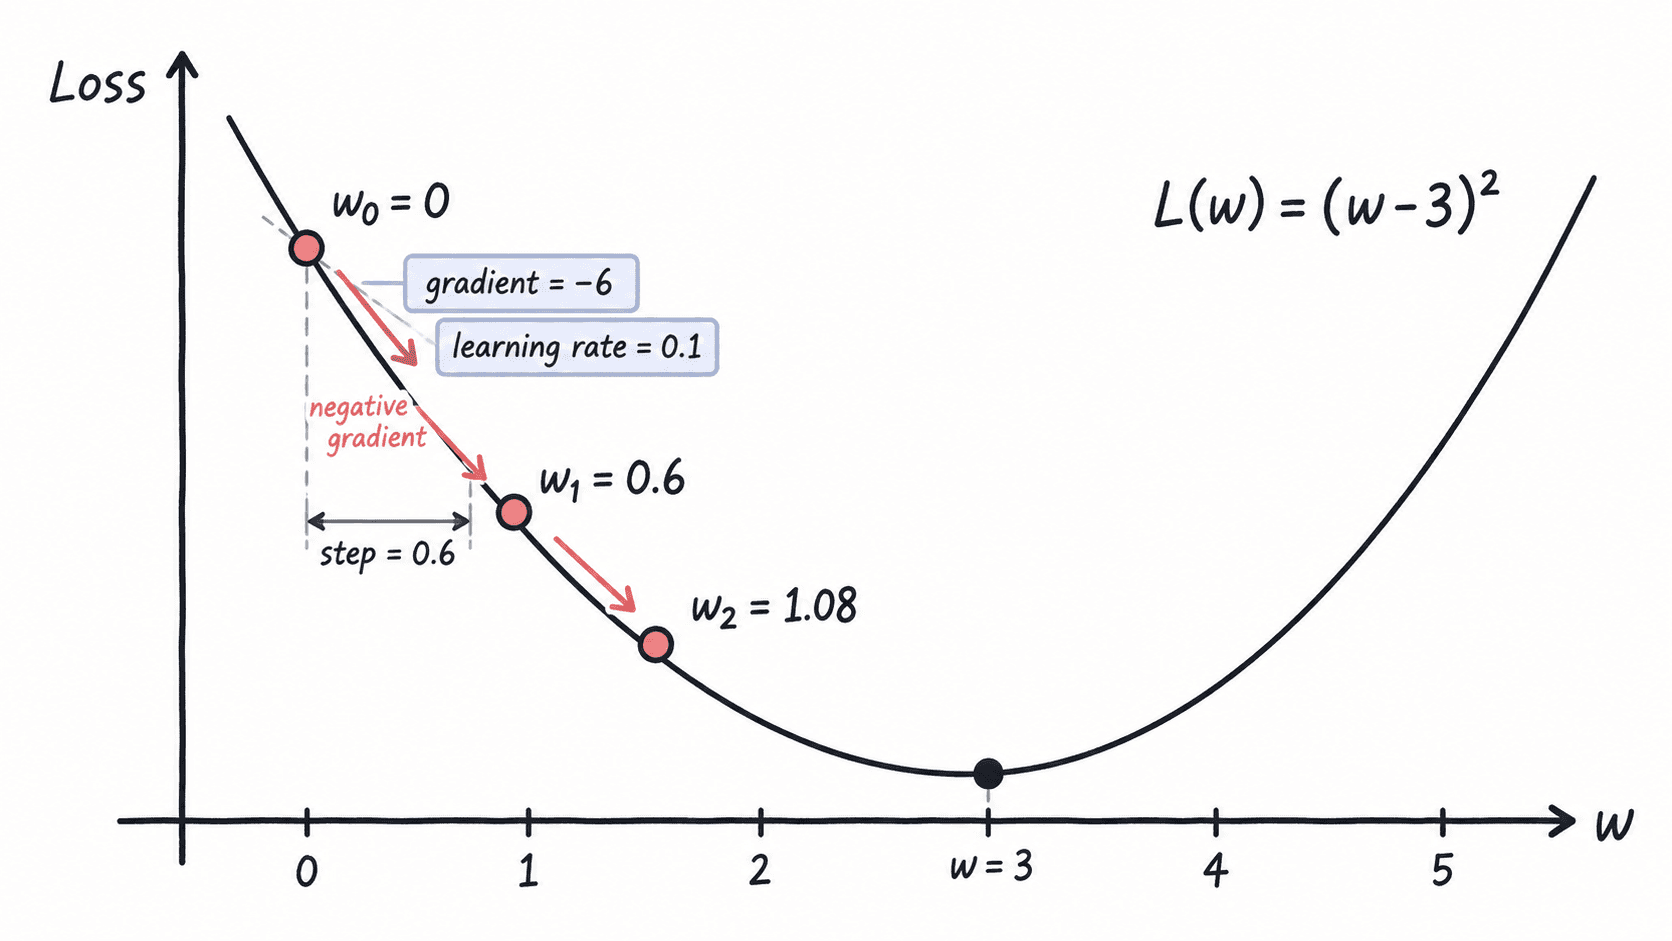
先看只有一个参数的模型。假设目标参数是 3,损失函数为 。当 时,损失为 9,此处梯度 。梯度是负数,表示增大 会让损失下降,因此更新时要向正方向移动。
若学习率为 0.1,一次更新就是 ,新损失变成 。损失从 9 降到 5.76,说明这一步方向正确。
用 PyTorch 执行参数更新
下面把同一个算例写成可运行的 PyTorch 程序。requires_grad=True 让 PyTorch 跟踪关于 w 的运算,loss.backward() 计算梯度,更新参数时使用 torch.no_grad(),避免把优化步骤本身记录进自动微分图。
import torch

w = torch.tensor([0.0], requires_grad=True)
learning_rate = 0.1

for step in range(4):
    loss = (w - 3).pow(2).sum()
    loss.backward()

    # 参数更新不属于需要求导的前向计算。
    with torch.no_grad():
        w -= learning_rate * w.grad
        new_loss = (w - 3).pow(2).sum()

    # PyTorch 默认累积梯度,每轮更新后必须清理旧梯度。
    w.grad.zero_()
    print(f'step={step + 1} w={w.item():.4f} loss={new_loss.item():.4f}')
预期输出:
step=1 w=0.6000 loss=5.7600
step=2 w=1.0800 loss=3.6864
step=3 w=1.4640 loss=2.3593
step=4 w=1.7712 loss=1.5099
每一步都重新计算当前损失与梯度,因此参数逐渐靠近 3。实际神经网络虽然可能有数百万个参数,过程仍然相同:先前向计算损失,再反向传播得到每个参数的梯度,最后执行一次参数更新。
学习率决定每一步走多远
梯度下降常写成 ,其中 是当前梯度, 是学习率。学习率不改变梯度指向,但会直接决定参数一次移动多远。
仍以 、初始值 为例,可以比较不同学习率的行为:
| 学习率 | 第一次更新后的 w | 典型表现 |
|---|---|---|
| 0.01 | 0.06 | 方向正确,但收敛较慢 |
| 0.10 | 0.60 | 稳定接近最小值 |
| 0.90 | 5.40 | 在最小值两侧来回跳动,但幅度逐渐缩小 |
| 1.10 | 6.60 | 跳动幅度不断增大,最终发散 |
如果训练损失几十个 step 几乎不下降,可以先检查学习率是否过小;如果损失突然变成极大值、持续振荡甚至出现 nan,学习率过大是优先排查项。实践中可先从 1e-3 作为 Adam/AdamW 的试验起点,使用 SGD 时常从 1e-2 或 1e-1 量级试验,再根据损失曲线调整,而不是把某个数值当作所有模型的固定答案。
小批量训练中的梯度下降
真实训练通常不会用整个数据集计算一次梯度,而是采用 mini-batch。例如有 3200 个训练样本,batch_size=32 时,一个 epoch 包含 100 个参数更新 step。每个 step 的梯度只由当前 32 个样本估计,因此损失会有波动,但计算成本远低于每一步都遍历全部数据。
PyTorch 训练循环通常遵循固定顺序:先清梯度,再计算预测与损失,然后反向传播,最后更新参数。使用优化器时对应 optimizer.zero_grad()、loss.backward() 和 optimizer.step()。如果忘记清梯度,本轮梯度会与之前的梯度累加,实际更新方向和步长都会发生变化。