
机器学习与深度学习 / 系统课时
恢复中断训练
恢复中断训练
断点续训的关键不是“把权重读回来”,而是恢复模型、优化器和训练计数后,从正确的下一轮继续执行。本课用一个完整脚本模拟训练在第 2 个 epoch 中断,再创建全新的模型与优化器并恢复到第 3 个 epoch。
学习目标
- 能按正确顺序创建对象并加载 checkpoint
- 能用
epoch + 1避免重复训练已经完成的轮次 - 能验证 Adam 的内部步数确实随 checkpoint 一起恢复
按固定顺序恢复训练状态
恢复时先创建与保存时一致的模型,再用这些参数创建优化器,然后读取 checkpoint 并分别调用 load_state_dict()。如果保存的是“已完整完成的 epoch”,例如 epoch=2,下一轮就应从 3 开始,而不是再次执行第 2 轮。
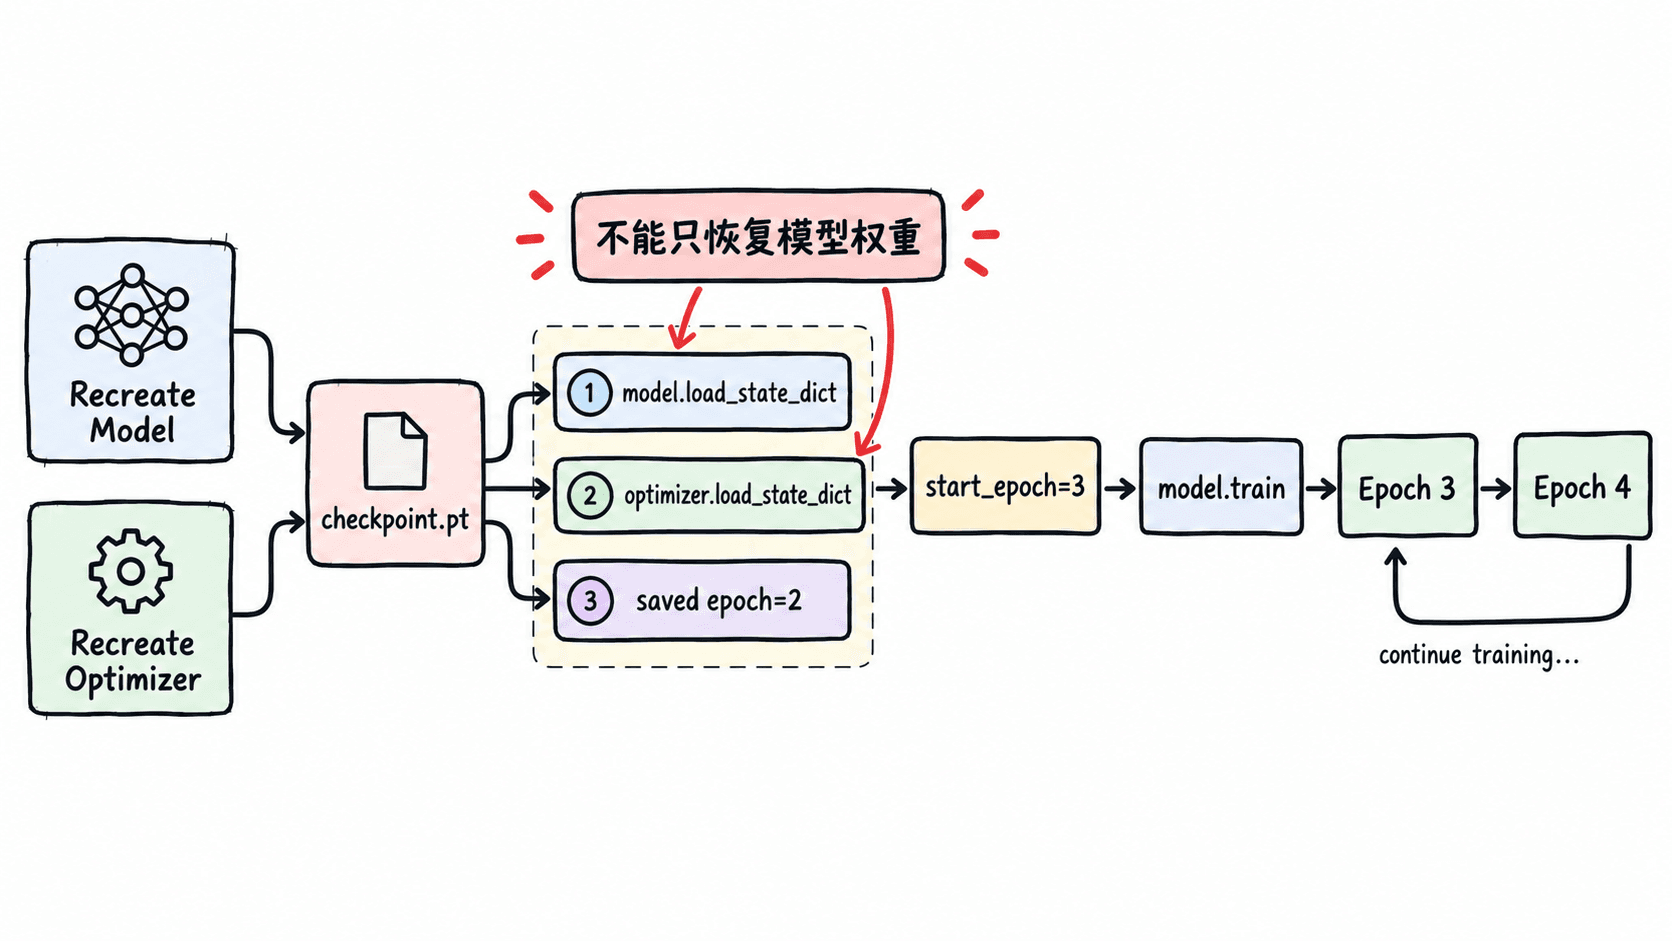
若训练环境从 GPU 切到 CPU,可以在 torch.load() 中传入 map_location="cpu";反过来恢复到 GPU 时,则应把 checkpoint 映射到目标设备,并确保模型、输入和优化器状态最终位于一致的设备上。
运行一个可复现的断点续训
下面的脚本不依赖上一课文件。它先训练 2 个 epoch 并保存 resume-demo.pt,随后故意新建模型和 Adam 优化器,再从 checkpoint 恢复并继续到第 4 个 epoch。每个 epoch 只执行一次优化器更新,因此 Adam 的 step 计数可以直接用于验证。
from pathlib import Path

import torch
from torch import nn

torch.manual_seed(7)

def build_model():
    return nn.Sequential(nn.Linear(2, 4), nn.Tanh(), nn.Linear(4, 1))

def train_epoch(model, optimizer, x, target):
    model.train()
    optimizer.zero_grad()
    loss = nn.functional.mse_loss(model(x), target)
    loss.backward()
    optimizer.step()
    return float(loss.detach())

x = torch.tensor([[0.0, 1.0], [1.0, 2.0], [2.0, 3.0]])
target = torch.tensor([[1.0], [3.0], [5.0]])

model = build_model()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-2)

for epoch in range(1, 3):
    train_epoch(model, optimizer, x, target)

path = Path("checkpoints/resume-demo.pt")
path.parent.mkdir(parents=True, exist_ok=True)
torch.save(
    {
        "epoch": 2,
        "model_state_dict": model.state_dict(),
        "optimizer_state_dict": optimizer.state_dict(),
    },
    path,
)

# 模拟进程重启:重新创建对象,而不是继续使用内存中的旧对象。
resumed_model = build_model()
resumed_optimizer = torch.optim.Adam(resumed_model.parameters(), lr=1e-2)

checkpoint = torch.load(path, map_location="cpu", weights_only=True)
resumed_model.load_state_dict(checkpoint["model_state_dict"])
resumed_optimizer.load_state_dict(checkpoint["optimizer_state_dict"])

start_epoch = checkpoint["epoch"] + 1
first_state = next(iter(resumed_optimizer.state.values()))
step_at_resume = int(first_state["step"].item())

for epoch in range(start_epoch, 5):
    train_epoch(resumed_model, resumed_optimizer, x, target)

first_state = next(iter(resumed_optimizer.state.values()))
step_after_training = int(first_state["step"].item())

print(f"saved_epoch: {checkpoint['epoch']}")
print(f"resume_from_epoch: {start_epoch}")
print(f"optimizer_step_at_resume: {step_at_resume}")
print("final_epoch: 4")
print(f"optimizer_step_after_training: {step_after_training}")
预期输出
saved_epoch: 2
resume_from_epoch: 3
optimizer_step_at_resume: 2
final_epoch: 4
optimizer_step_after_training: 4
optimizer_step_at_resume: 2 是关键证据:如果只加载模型权重而重新使用空的 Adam 状态,这个步数不会从 2 接着走,动量估计也会重新开始。
把调度器和训练模式一起恢复
如果训练使用 LRScheduler,应在 checkpoint 中额外保存 scheduler.state_dict()。恢复时先创建模型、优化器和调度器,再加载调度器状态,最后加载优化器状态,避免调度器初始化覆盖已经保存的学习率。恢复完成后调用 model.train() 再进入训练循环;只有做验证或推理时才切换到 model.eval()。
按 epoch 保存时,epoch + 1 足以确定下一轮位置;如果要求在一个 epoch 中间精确恢复,例如每 1000 step 保存一次,还需要额外记录 global_step,并为数据采样顺序设计可恢复状态,否则即使模型和优化器完全一致,也可能从不同批次继续。
处理最常见的恢复失败
load_state_dict() 报尺寸不匹配时,先核对模型构造参数,而不是直接设置 strict=False。例如保存时第一层是 Linear(2, 4),恢复时改成 Linear(2, 8),旧权重本来就无法完整装入新结构。
如果恢复后学习率突然回到初始化值,检查是否漏存调度器状态,或者恢复顺序是否让新建调度器覆盖了 checkpoint 中的参数组学习率。如果从 CUDA checkpoint 在无 GPU 机器上加载时报设备错误,则明确使用 map_location="cpu"。
验收断点续训至少看三项:起始 epoch 是否为已完成轮次加一;优化器内部 step 是否延续;恢复后的首个训练 step 能否正常反向传播并更新参数。三项都通过,才说明恢复的是训练状态,而不只是模型文件。