
机器学习与深度学习 / 系统课时
使用自动混合精度
使用自动混合精度
自动混合精度(AMP)让部分算子以 float16 或 bfloat16 执行,同时把对数值范围更敏感的算子保留在更高精度,从而减少显存占用,并在支持 Tensor Core 等硬件的 GPU 上提高吞吐。正确用法不是把整个模型手动 .half(),而是让 autocast 选择算子精度,并在 float16 训练时配合 GradScaler 防止梯度下溢。
学习目标
- 使用当前 PyTorch 2.x 的
torch.autocast与torch.amp.GradScaler组织训练步骤。 - 理解 autocast、loss scaling、反向传播和 optimizer step 的执行顺序。
- 判断 AMP 是否真的带来显存或速度收益,并处理梯度裁剪与数值溢出。
AMP 的训练链路
在 CUDA float16 训练中,一次典型 step 包含六个动作:清空旧梯度、在 autocast 区域执行前向与 loss、放大 loss 后反向传播、必要时还原梯度、执行 optimizer step、更新缩放因子。GradScaler 会检查梯度中的 inf/nan;出现溢出时可跳过这次参数更新并调整 scale。
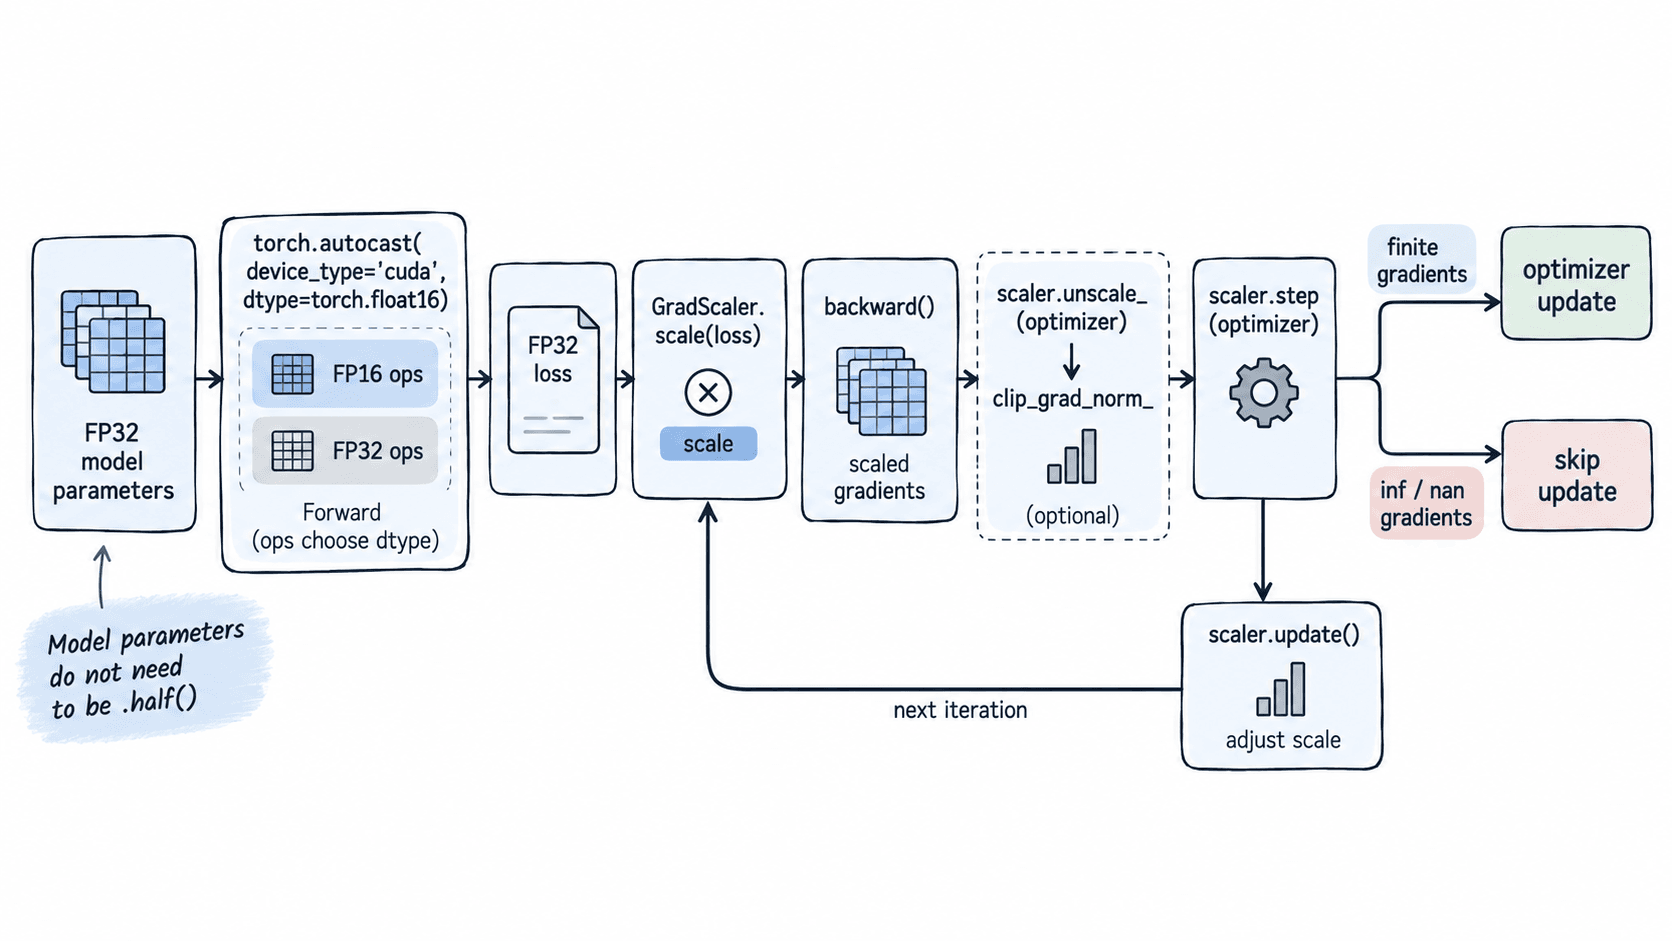
autocast 只影响上下文中的算子执行精度,不会永久把模型参数改成半精度。以 CUDA 为例,矩阵乘等适合低精度的算子可进入 float16,而某些归约或损失计算会保留或提升到 float32,具体由 PyTorch 的 autocast 规则决定。
写出一轮可运行的 AMP 训练
下面示例适用于带 CUDA 的 PyTorch 2.x 环境,使用当前推荐的 torch.autocast 和 torch.amp.GradScaler。如果机器没有 CUDA,脚本会明确退出,而不是悄悄假装已经进行 GPU 混合精度训练。
import torch
import torch.nn.functional as F
from torch import nn

if not torch.cuda.is_available():
    print("CUDA unavailable; run this example on a CUDA GPU.")
    raise SystemExit(0)

device = torch.device("cuda")
torch.manual_seed(0)

model = nn.Sequential(
    nn.Linear(1024, 2048),
    nn.ReLU(),
    nn.Linear(2048, 10),
).to(device)

optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)
scaler = torch.amp.GradScaler("cuda")

inputs = torch.randn(64, 1024, device=device)
targets = torch.randint(0, 10, (64,), device=device)

optimizer.zero_grad(set_to_none=True)

with torch.autocast(device_type="cuda", dtype=torch.float16):
    logits = model(inputs)
    loss = F.cross_entropy(logits, targets)

scaler.scale(loss).backward()
scaler.step(optimizer)
scaler.update()

print(f"device={device.type}")
print(f"logits_dtype={logits.dtype}")
print(f"loss_dtype={loss.dtype}")
print("amp_step_finished=True")
在常见 CUDA 环境下,预期输出为:
device=cuda
logits_dtype=torch.float16
loss_dtype=torch.float32
amp_step_finished=True
如果没有 CUDA,预期输出为:
CUDA unavailable; run this example on a CUDA GPU.这里没有打印 loss 数值,因为随机输入、CUDA 实现和硬件可能让最后几位不同。真正需要检查的是 autocast 是否生效、loss 是否保持有限值,以及训练 step 能否持续执行。
选择 float16 还是 bfloat16
在支持良好的 NVIDIA GPU 上,float16 通常能明显降低激活显存并提升矩阵计算吞吐,但指数范围较窄,所以训练时一般配合 GradScaler。bfloat16 的指数范围接近 float32,通常不需要 loss scaling;是否支持可用 torch.cuda.is_bf16_supported() 检查。
不要只凭 dtype 判断收益。对小模型、数据加载成为瓶颈的任务,AMP 可能几乎不提速。验收时至少比较同一 batch size 下的三个指标:每 step 时间、torch.cuda.max_memory_allocated() 峰值显存、验证集指标。建议先预热 20~50 个 step,再统计后续 100 个 step 的平均耗时,避免把 CUDA 初始化开销算进去。
与梯度裁剪一起使用
如果训练还需要 clip_grad_norm_,必须先把缩放后的梯度恢复到真实尺度。顺序应为:scaler.scale(loss).backward() → scaler.unscale_(optimizer) → clip_grad_norm_ → scaler.step(optimizer) → scaler.update()。否则裁剪的是被 scale 放大的梯度,阈值会失去原本含义。
scaler.unscale_(optimizer) 对同一个 optimizer 每个 step 只调用一次,而且应在该 optimizer 的所有梯度都累积完成后调用。多 optimizer 场景中可以分别 unscale 和 step,但 scaler.update() 通常放在本轮所有 optimizer 都完成 step 之后。
验证速度、显存与数值稳定性
AMP 上线前应做 A/B 对照:固定随机种子、数据顺序、batch size 和训练步数,比较 FP32 与 AMP 的 loss 曲线和验证指标。分类任务如果最终准确率差异只在正常随机波动内,同时显存下降、吞吐提升,才说明切换有效。
若出现 loss 很快变成 nan,先确认是否使用了 GradScaler、是否把模型整体 .half()、是否存在自定义算子不适合 float16。如果某段计算必须保持高精度,可退出 autocast 区域或为该局部禁用 autocast,而不是关闭整个训练的 AMP。