
机器学习与深度学习 / 系统课时
理解迁移学习
理解迁移学习
迁移学习把大数据集上已经学到的视觉特征复用到新任务中,常见做法是保留预训练主干,只重新训练分类头,或再以更小学习率微调部分主干。本篇用图像分类场景说明知识如何迁移,以及什么时候值得用、什么时候容易失效。
学习目标
- 解释预训练主干、分类头与目标任务之间的关系。
- 根据数据规模和领域相似度选择冻结或微调策略。
- 识别学习率、领域偏移和 BatchNorm 统计量带来的常见问题。
迁移学习解决什么问题
假设目标任务只有 2,000 张商品图片、5 个类别,从随机初始化开始训练卷积网络,很容易出现训练集准确率持续上升、验证集停滞的过拟合。若改用在 ImageNet 约 128 万张、1,000 类图像上训练过的网络,前部卷积层已经能提取边缘、纹理、局部形状等通用特征,目标任务只需学习如何重新组合这些特征。
迁移学习最直接的收益是减少目标任务需要学习的参数数量和数据量。它并不保证一定优于从头训练:目标数据与预训练数据越相似,收益通常越明显;若目标是医学灰度影像、遥感多光谱等分布差异很大的数据,则需要更谨慎地微调甚至改用更合适的预训练源。
知识怎样从源任务迁到新任务
典型视觉模型可以拆成两部分:前面的 backbone 负责提取特征,最后的 classifier head 把特征映射为类别分数。迁移时通常保留 backbone 的预训练参数,把原来的 1,000 类分类头替换成目标任务需要的输出维度,例如 5 类。
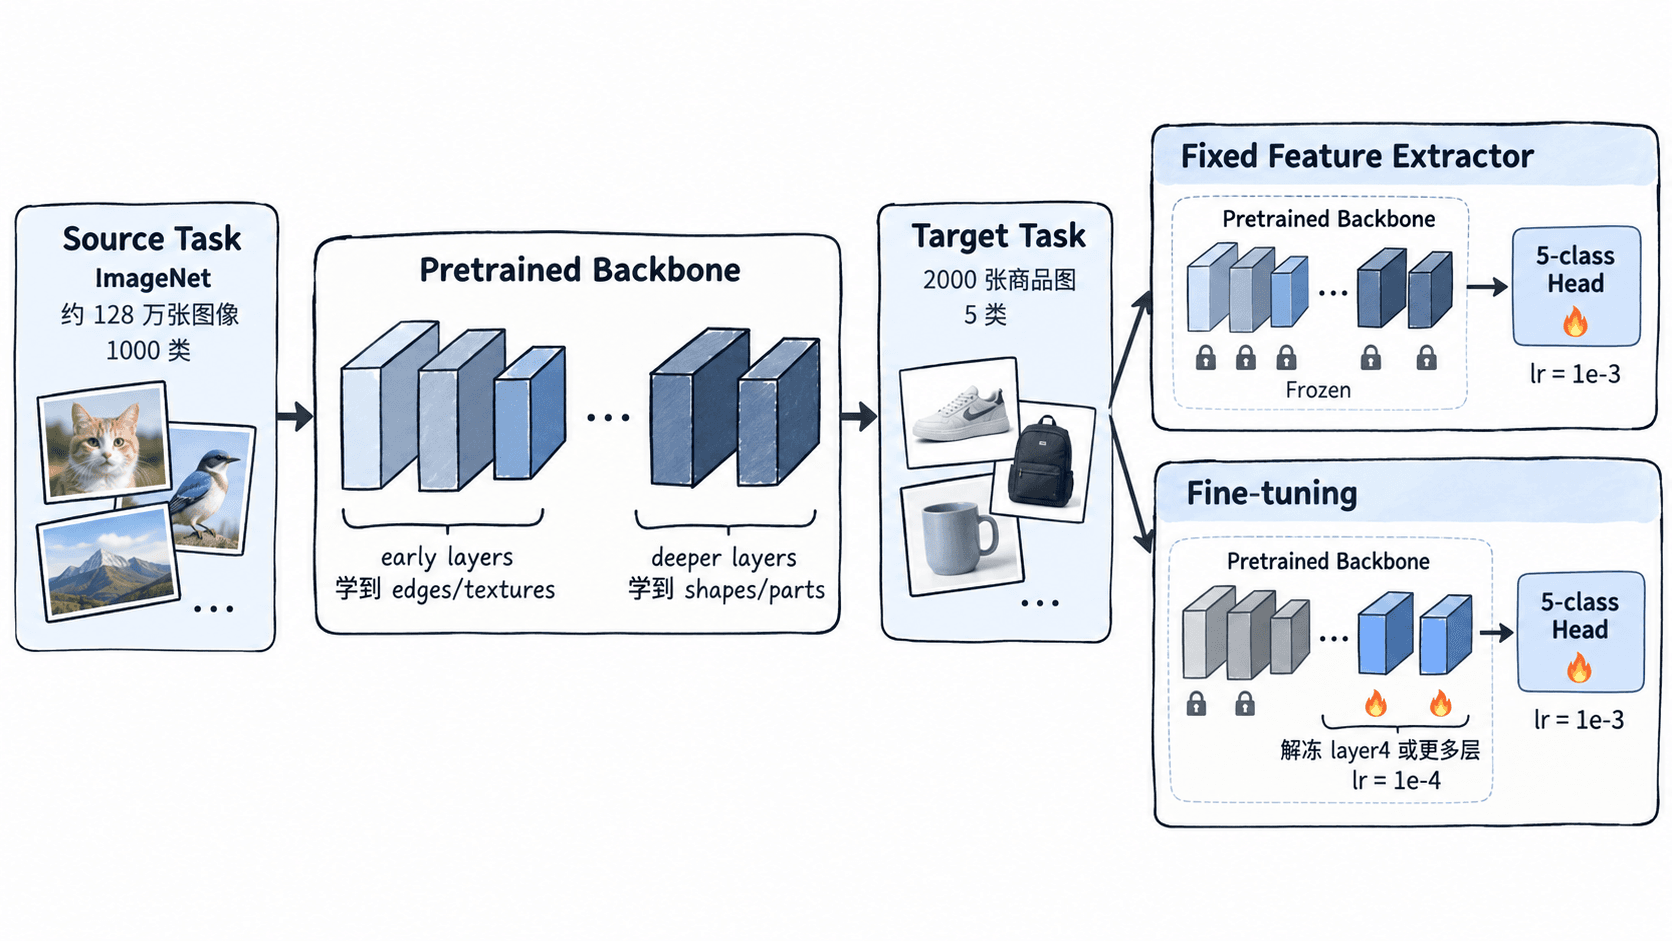
固定特征提取时,backbone 参数保持不变,只训练新分类头;微调时则让部分或全部 backbone 继续更新。两者的差异不是“是否使用预训练”,而是“预训练参数在目标任务上还能否继续变化”。
冻结还是微调
可以先按下面的起始方案做小规模实验,再根据验证集结果调整。学习率不是固定规则,但不同参数组通常要拉开一个数量级,避免刚加载的预训练特征被大步更新破坏。
| 场景 | 建议起点 | 可训练部分 | 学习率示例 |
|---|---|---|---|
| 2,000 张、目标与自然图像相似 | 先固定特征 | 新分类头 | 1e-3 |
| 10,000 张、领域相近 | 解冻最后一个 stage | 分类头 + 最后 stage | head 1e-3,backbone 1e-4 |
| 50,000 张以上、领域有差异 | 逐步解冻更多层 | 大部分或全部网络 | backbone 可从 1e-5~1e-4 起试 |
固定特征提取适合先建立可靠基线;若验证集准确率很快到平台,而训练集仍有提升空间,可以解冻靠后的层继续微调。反过来,如果解冻后验证损失明显变差,先把 backbone 学习率降低 5~10 倍,而不是直接放弃预训练。
判断任务是否适合迁移
可以用三个问题快速判断。第一,目标数据是否偏少;几百到几千张图像时,预训练通常比随机初始化更值得优先尝试。第二,输入结构是否兼容,例如常见预训练视觉模型通常期望 3 通道图像。第三,目标领域与预训练领域是否共享可复用的视觉模式。
一个可操作的验收方式是做两条基线:A 使用预训练并冻结 backbone,B 使用相同网络结构但随机初始化。保持训练轮数、数据增强和评估集一致;若 A 在前 3~5 个 epoch 已明显领先,说明预训练特征确实提供了有效迁移。
常见失败与修正
最常见的问题是微调学习率过大。分类头从随机初始化开始,可以承受 1e-3 左右的学习率,而预训练 backbone 往往应从 1e-4 或更低开始。若两者共用同一较大学习率,模型可能在几个 batch 内破坏原有特征。
另一个容易忽略的问题是 BatchNorm。即使参数的 requires_grad 已关闭,模型处于训练模式时,BatchNorm 的运行均值和方差仍可能更新。若你把 backbone 当作完全固定的特征提取器,应同时检查这些统计量是否需要保持不变;否则“参数冻结”与“行为冻结”并不是同一件事。
当目标领域与 ImageNet 差异很大时,不要只看训练准确率。至少保留独立验证集,并比较固定特征、局部微调和随机初始化三条基线;迁移学习是否有效,应由目标任务上的验证指标决定。