
机器学习与深度学习 / 系统课时
保存模型检查点
保存模型检查点
训练跑到一半时,只有模型权重并不足以继续原来的优化轨迹。本课把模型参数、优化器状态、已完成轮次和关键训练指标一起写入 checkpoint,并在保存后立即回读验证,得到一个可以用于断点续训的 .pt 文件。
学习目标
- 能用
state_dict()组织模型与优化器的可恢复状态 - 能用
torch.save()保存包含轮次和训练指标的检查点 - 能在训练过程中设置可追踪的命名与验证规则
检查点应该保存什么
用于续训的 checkpoint 至少要包含模型和优化器的 state_dict。例如已完成第 4 个 epoch,可把 epoch=4、global_step=1280 和当前最佳验证损失 best_val_loss=0.1234 一起保存。这样恢复时既知道参数是什么,也知道训练应从哪里继续。
| 字段 | 示例值 | 用途 |
|---|---|---|
model_state_dict |
model.state_dict() |
恢复权重与注册缓冲区 |
optimizer_state_dict |
optimizer.state_dict() |
恢复 Adam 动量、步数和参数组 |
epoch |
4 |
标记已经完整训练到第几个 epoch |
global_step |
1280 |
恢复按 step 计数的日志或调度逻辑 |
best_val_loss |
0.1234 |
继续判断最佳模型是否被刷新 |
如果训练还使用学习率调度器或 AMP 梯度缩放器,也应分别保存它们的 state_dict();不要只保存一个 model.state_dict() 后就认为可以无缝续训。
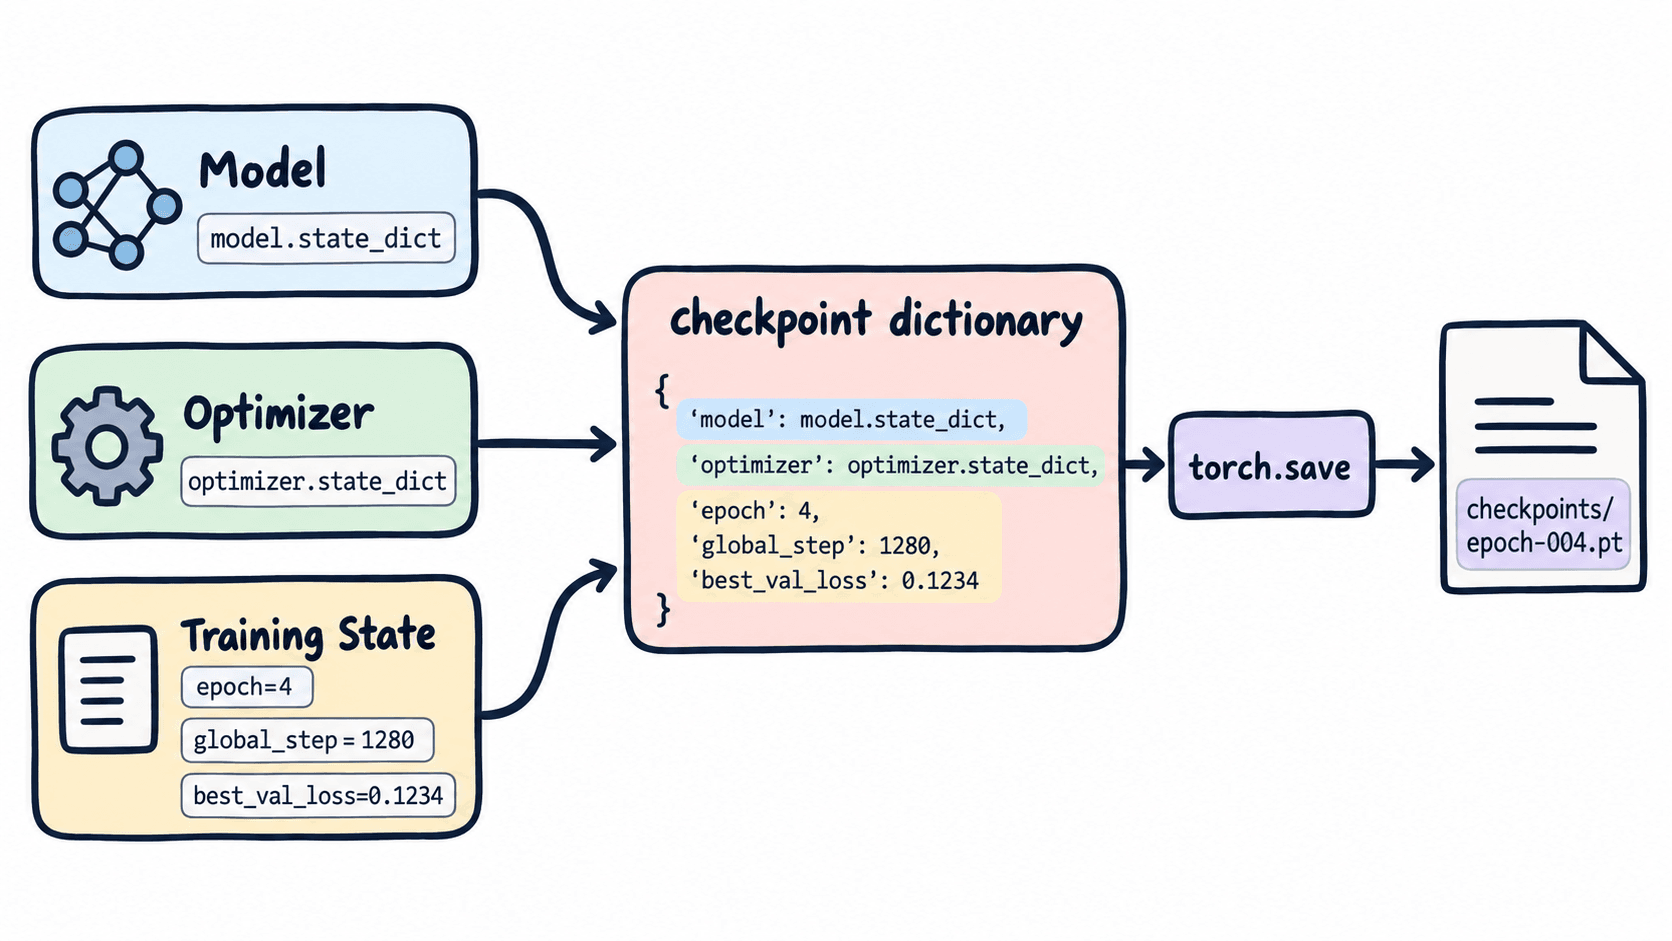
写出并回读一个检查点
下面的脚本先做一次 Adam 更新,让优化器内部状态真实产生,再保存 checkpoint。随后立即用 torch.load(..., weights_only=True) 回读并检查关键字段;示例可直接以 Python 脚本运行。
from pathlib import Path

import torch
from torch import nn

torch.manual_seed(0)

model = nn.Sequential(
    nn.Linear(4, 8),
    nn.ReLU(),
    nn.Linear(8, 1),
)
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

# 先完成一次真实更新,使 Adam 的一阶、二阶矩状态被创建。
x = torch.ones(2, 4)
target = torch.zeros(2, 1)
loss = nn.functional.mse_loss(model(x), target)
optimizer.zero_grad()
loss.backward()
optimizer.step()

checkpoint = {
    "epoch": 4,
    "global_step": 1280,
    "best_val_loss": 0.1234,
    "model_state_dict": model.state_dict(),
    "optimizer_state_dict": optimizer.state_dict(),
}

path = Path("checkpoints/epoch-004.pt")
path.parent.mkdir(parents=True, exist_ok=True)
torch.save(checkpoint, path)

loaded = torch.load(path, map_location="cpu", weights_only=True)
print(f"saved: {path}")
print(f"epoch: {loaded['epoch']}")
print(f"global_step: {loaded['global_step']}")
print(f"optimizer_has_state: {bool(loaded['optimizer_state_dict']['state'])}")
预期输出
saved: checkpoints/epoch-004.pt
epoch: 4
global_step: 1280
optimizer_has_state: True
这个验证比只检查文件是否存在更可靠:如果 optimizer_has_state 为 False,通常说明保存前还没有执行过优化器更新,或者保存的不是期望中的优化器状态。
设计保存频率和文件命名
真实训练建议同时保留“最新”“最佳”和低频历史检查点。以 100 个 epoch 的任务为例,可以每个 epoch 覆盖 latest.pt,验证损失刷新时覆盖 best.pt,每 10 个 epoch 额外保留 epoch-010.pt、epoch-020.pt 等历史文件。
写 latest.pt 时不要在进程可能被终止的场景里直接覆盖旧文件。更稳妥的做法是先保存到同一目录的临时文件,例如 latest.tmp,保存完成后再用原子替换更新 latest.pt。这样突然断电或作业被抢占时,上一份完整 checkpoint 仍有机会保留。
保存后做可恢复性检查
检查点真正合格的标准不是“能 torch.load”,而是能装回同结构的模型和优化器。恢复端应先重新创建相同网络结构,再调用 model.load_state_dict(...);模型层名或形状发生变化时,默认的严格加载会直接报出缺失键或尺寸不匹配。
发布或长期训练前至少检查三件事:checkpoint 能从 CPU 环境用 map_location="cpu" 打开;epoch 与日志中的最后完成轮次一致;重新创建的模型和优化器都能成功加载对应 state_dict。此外只加载可信来源的 checkpoint,不要把未知文件当作普通数据文件执行反序列化。