
机器学习与深度学习 / 系统课时
使用 LSTM 与 GRU
使用 LSTM 与 GRU
普通 RNN 在长序列上容易让早期信息逐步衰减。LSTM 和 GRU 都通过门控保留或更新状态。本课直接比较两者的状态结构、PyTorch 接口和参数量,并给出同一输入上的可运行对照,便于为文本分类选择合适的循环层。
学习目标
- 区分 LSTM 的隐藏状态、细胞状态与 GRU 的单一隐藏状态。
- 能用
nn.LSTM和nn.GRU处理batch_first=True的批量序列。 - 根据参数量、速度和任务表现选择门控结构,并避开多层与双向配置的常见误区。
门控如何缓解长期依赖
LSTM 每个时间步同时维护隐藏状态 h_t 和细胞状态 c_t。PyTorch 的 LSTM 内部计算输入门 i_t、遗忘门 f_t、候选状态 g_t 和输出门 o_t;其中 c_t 通过“保留旧状态 + 写入新信息”的加法路径向后传递,因此比普通 RNN 更容易保存较早的信息。
GRU 把长期状态压缩到 h_t 中,内部使用重置门 r_t、更新门 z_t 和候选状态 n_t。更新门直接控制旧状态与新候选状态的混合比例,结构比 LSTM 少一组门控参数。两者都只能缓解长期依赖问题,并不能保证任意长序列都不会遗忘。
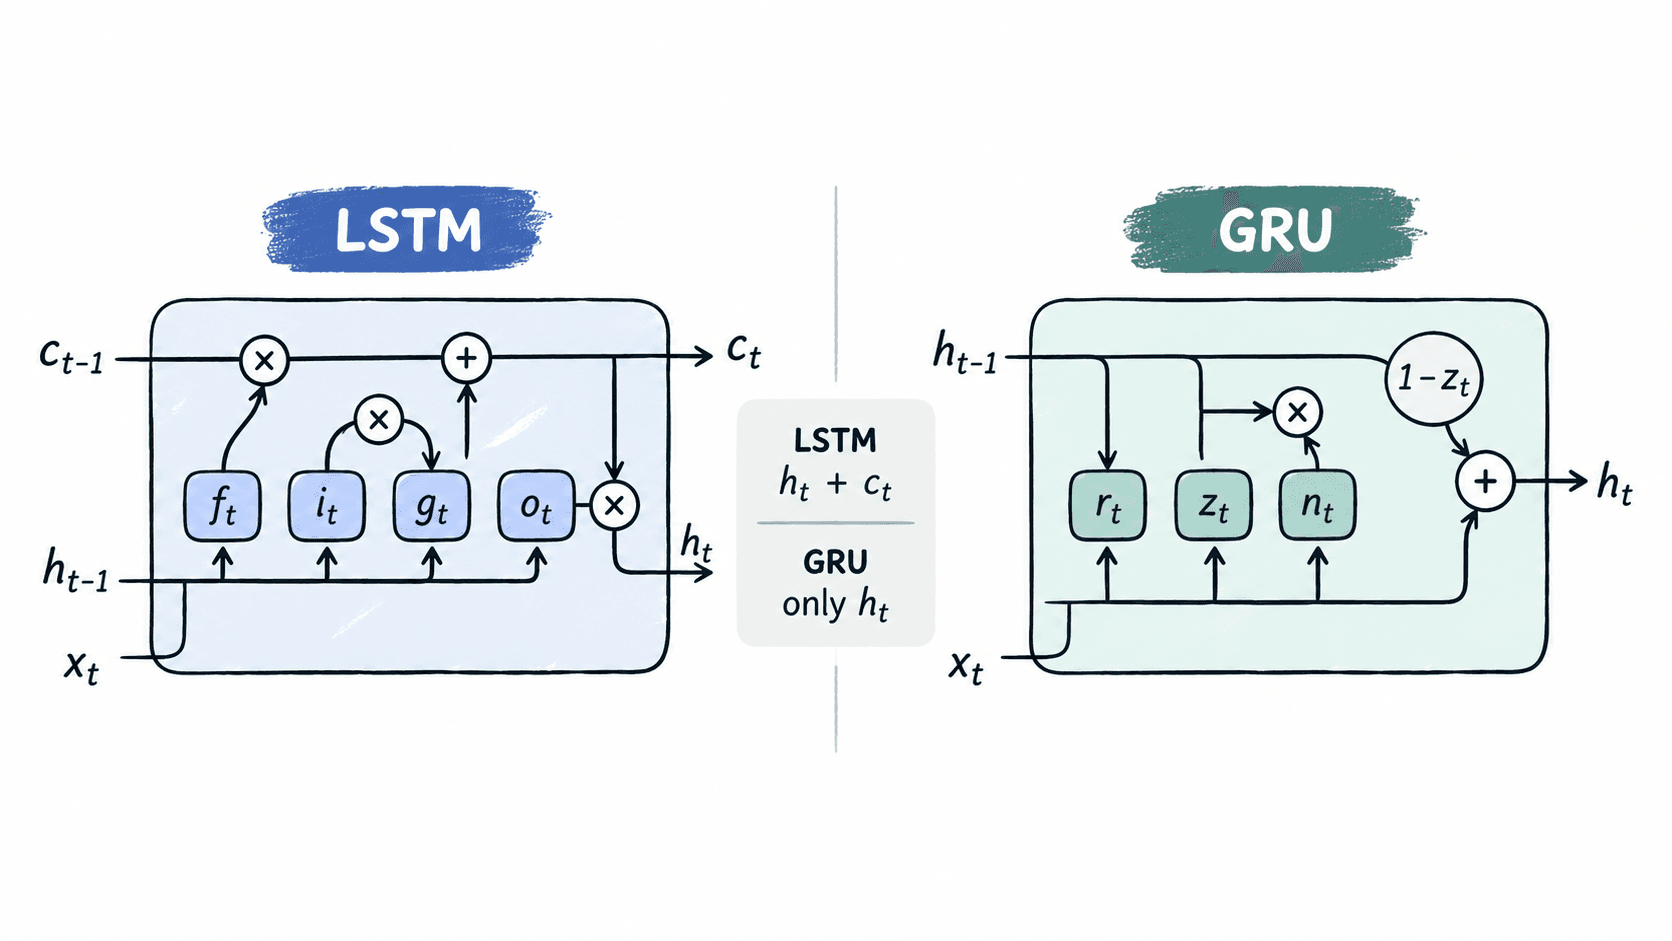
以单层、单向结构为例,input_size=8、hidden_size=6 时,LSTM 有 384 个参数,GRU 有 288 个参数,GRU 少 25%。参数差异来自 LSTM 每层有 4 组输入到隐藏和隐藏到隐藏权重,而 GRU 有 3 组。
在 PyTorch 中对照两种接口
两种模块都接受形状为 (N, L, H_in) 的输入,只要设置 batch_first=True。但 batch_first 不改变最终状态的维度:单层单向时,LSTM 的 h_n、c_n 都是 (1, N, H),GRU 的 h_n 是 (1, N, H)。
| 项目 | nn.LSTM |
nn.GRU |
|---|---|---|
| 返回值 | output, (h_n, c_n) |
output, h_n |
| 单层状态 | 隐藏状态 + 细胞状态 | 隐藏状态 |
| 单层权重组数 | 4 组 | 3 组 |
| 双向输出宽度 | 2 * hidden_size |
2 * hidden_size |
下面把相同的 (2, 5, 8) 输入分别送进 LSTM 与 GRU,并打印输出形状和参数量。
import torch
from torch import nn

torch.manual_seed(0)

x = torch.randn(2, 5, 8)

lstm = nn.LSTM(input_size=8, hidden_size=6, batch_first=True)
gru = nn.GRU(input_size=8, hidden_size=6, batch_first=True)

lstm_out, (lstm_h, lstm_c) = lstm(x)
gru_out, gru_h = gru(x)

print("LSTM output:", tuple(lstm_out.shape))
print("LSTM h_n:", tuple(lstm_h.shape))
print("LSTM c_n:", tuple(lstm_c.shape))
print("GRU output:", tuple(gru_out.shape))
print("GRU h_n:", tuple(gru_h.shape))
print("LSTM params:", sum(p.numel() for p in lstm.parameters()))
print("GRU params:", sum(p.numel() for p in gru.parameters()))
预期输出:
LSTM output: (2, 5, 6)
LSTM h_n: (1, 2, 6)
LSTM c_n: (1, 2, 6)
GRU output: (2, 5, 6)
GRU h_n: (1, 2, 6)
LSTM params: 384
GRU params: 288
若启用 bidirectional=True,output 的最后一维会变为 2 * hidden_size,最终状态第一维也会乘以方向数。若设置 dropout>0,PyTorch 只在多层循环网络的层与层之间应用 dropout;num_layers=1 时不要把这个参数当作有效的单层输出正则化。
选择 LSTM 还是 GRU
文本分类可以先用 GRU 建基线:相同 input_size 和 hidden_size 下参数更少,训练和推理通常也更轻。若任务需要更细地控制长期记忆,或验证集上 LSTM 明显更好,再保留 LSTM。不要只根据结构复杂度下结论,应固定词嵌入、隐藏维度、批大小和训练轮数后比较验证集指标。
例如把 hidden_size=256、单层单向模型作为起点时,先分别训练 5 个 epoch,记录验证集准确率与每秒样本数;若两者准确率相差不到 0.5 个百分点,而 GRU 吞吐明显更高,可优先 GRU。若 LSTM 在长文本样本上稳定提高 1~2 个百分点,则增加的状态和参数可能值得保留。