
机器学习与深度学习 / 系统课时
构建模型推理服务
构建模型推理服务
模型文件能够本地推理后,还需要把“输入校验、预处理、模型调用、后处理、错误返回”封装成稳定接口。本课用 FastAPI 和 ONNX Runtime 搭建一个可直接运行的 /predict 服务,并用固定输入验收返回结果。
学习目标
- 在服务启动阶段一次性加载 ONNX Runtime 会话
- 对 HTTP 输入做 shape 与 dtype 校验后再送入模型
- 返回可序列化预测结果,并区分客户端输入错误与服务端推理错误
把推理链路拆成稳定边界
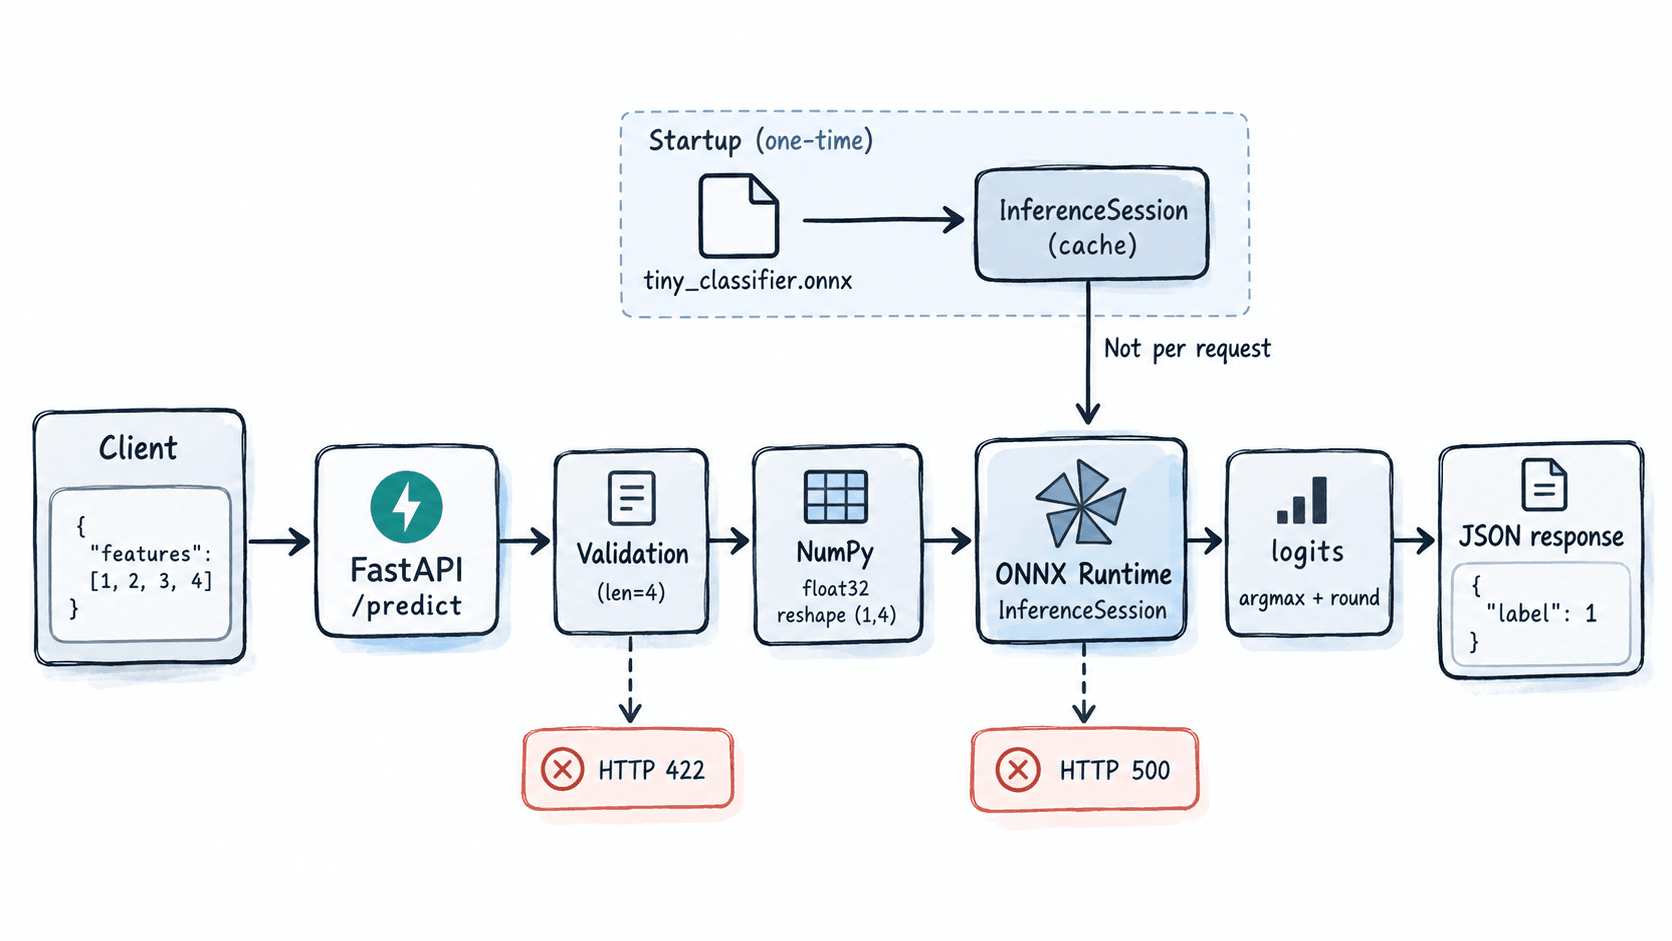
请求处理顺序应固定为:JSON 请求进入接口层,校验 4 个数值特征,转换为 float32 的 (1, 4) 数组,调用 ONNX Runtime,再把 logits 与类别索引转换成普通 JSON。模型会话在进程启动时创建一次,不要在每个请求里重复 InferenceSession(),否则模型加载会直接进入请求延迟。
实现可运行的 FastAPI 服务
示例面向 Python 3.10+,依赖 fastapi、uvicorn、numpy、onnxruntime、torch、onnx 与 onnxscript。为了让本课独立可运行,首次启动时会生成一个固定权重的演示 ONNX 文件;生产环境应删除自动导出逻辑,只加载 CI/CD 发布的模型产物。
from pathlib import Path
import numpy as np
import onnxruntime as ort
import torch
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
from torch import nn
MODEL_PATH = Path("service_tiny_classifier.onnx")
class TinyClassifier(nn.Module):
    # 教学模型使用固定权重,便于接口结果验收。
    def __init__(self):
        super().__init__()
        self.fc = nn.Linear(4, 3)
        with torch.no_grad():
            self.fc.weight.copy_(torch.tensor([
                [1.0, 0.0, 0.0, 0.0],
                [0.0, 1.0, 0.0, 0.0],
                [0.0, 0.0, 1.0, 0.0],
            ]))
            self.fc.bias.copy_(torch.tensor([0.1, 0.2, 0.3]))
    def forward(self, x):
        return self.fc(x)
def ensure_demo_model():
    # 仅为让本课独立运行;生产环境应直接加载发布物。
    if MODEL_PATH.exists():
        return
    model = TinyClassifier().eval()
    example = torch.tensor([[1.0, 2.0, 3.0, 4.0]])
    torch.onnx.export(
        model,
        (example,),
        str(MODEL_PATH),
        input_names=["features"],
        output_names=["logits"],
        opset_version=18,
        dynamo=True,
    )
ensure_demo_model()
# 会话在进程启动时只创建一次,后续请求复用。
session = ort.InferenceSession(
    str(MODEL_PATH),
    providers=["CPUExecutionProvider"],
)
input_name = session.get_inputs()[0].name
app = FastAPI()
class PredictRequest(BaseModel):
    features: list[float]
@app.get("/health")
def health():
    return {"status": "ok"}
@app.post("/predict")
def predict(payload: PredictRequest):
    # 先拒绝错误 shape,再进入 Runtime。
    if len(payload.features) != 4:
        raise HTTPException(status_code=422, detail="features must contain 4 numbers")
    x = np.asarray(payload.features, dtype=np.float32).reshape(1, 4)
    try:
        logits = session.run(["logits"], {input_name: x})[0]
    except Exception as exc:
        raise HTTPException(status_code=500, detail="inference failed") from exc
    rounded = [round(float(value), 4) for value in logits[0]]
    return {
        "logits": rounded,
        "prediction": int(np.argmax(logits[0])),
    }
预期结果:把代码保存为 app.py,执行 uvicorn app:app --host 127.0.0.1 --port 8000 后,服务完成启动。
INFO:     Application startup complete.
INFO:     Uvicorn running on http://127.0.0.1:8000
调用接口并核对返回
服务启动后发送一个预测请求。这里的输入与演示模型权重对应,因此可以得到确定结果;真实项目应把特征归一化、图像 resize 或文本分词等预处理写成与训练阶段完全一致的函数。
curl -s -X POST http://127.0.0.1:8000/predict -H "Content-Type: application/json" -d '{"features":[1,2,3,4]}'预期输出:
{"logits":[1.1,2.2,3.3],"prediction":2}如果发送 {"features":[1,2]},接口应返回 HTTP 422;这属于客户端输入错误,不应进入模型执行。模型文件缺失、Runtime 初始化失败或推理异常则属于服务端问题,应记录异常并返回 5xx。
上线前检查性能与可观测性
CPU 服务可先固定 CPUExecutionProvider,再用真实流量样本测 P50、P95 延迟和单实例 QPS;GPU 环境则必须确认部署包包含对应的 ONNX Runtime GPU 版本和可用 provider。无论后端如何,启动阶段都应校验模型输入名、shape、dtype,并让 /health 只报告进程和模型会话是否可用,不在健康检查里执行昂贵推理。
生产接口还应设置请求体大小限制、超时和并发上限,并避免直接把底层异常文本返回给客户端。验收时至少覆盖三类请求:一个正常样本、一个 shape 错误样本、一个边界数值样本;只有三类都符合约定状态码和响应结构,服务才算真正可部署。