
机器学习与深度学习 / 系统课时
构建文本分类模型
构建文本分类模型
文本分类模型要把一批不等长的词元序列压缩成固定长度表示,再输出类别 logits。本篇用 Embedding + 双向 GRU + Linear 组成一个可训练的三分类模型,同时正确处理 PAD,最后完成一次反向传播,适合情感分类或主题分类的最小实现。
学习目标
- 能说明词元 ID、嵌入向量、循环层隐藏状态和分类 logits 的形状变化。
- 能用
nn.Embedding、nn.GRU与nn.Linear写出可训练文本分类器。 - 能用真实序列长度绕过右侧
PAD,避免短样本的最终状态被填充位置污染。
从词元 ID 到分类 logits
假设一个 batch 有 N 条文本,最长补到 T 个词元,词表把 PAD 固定为 ID 0。输入张量形状是 N×T;嵌入维度取 E=8,双向 GRU 隐藏维度取 H=12,三分类类别数为 C=3。
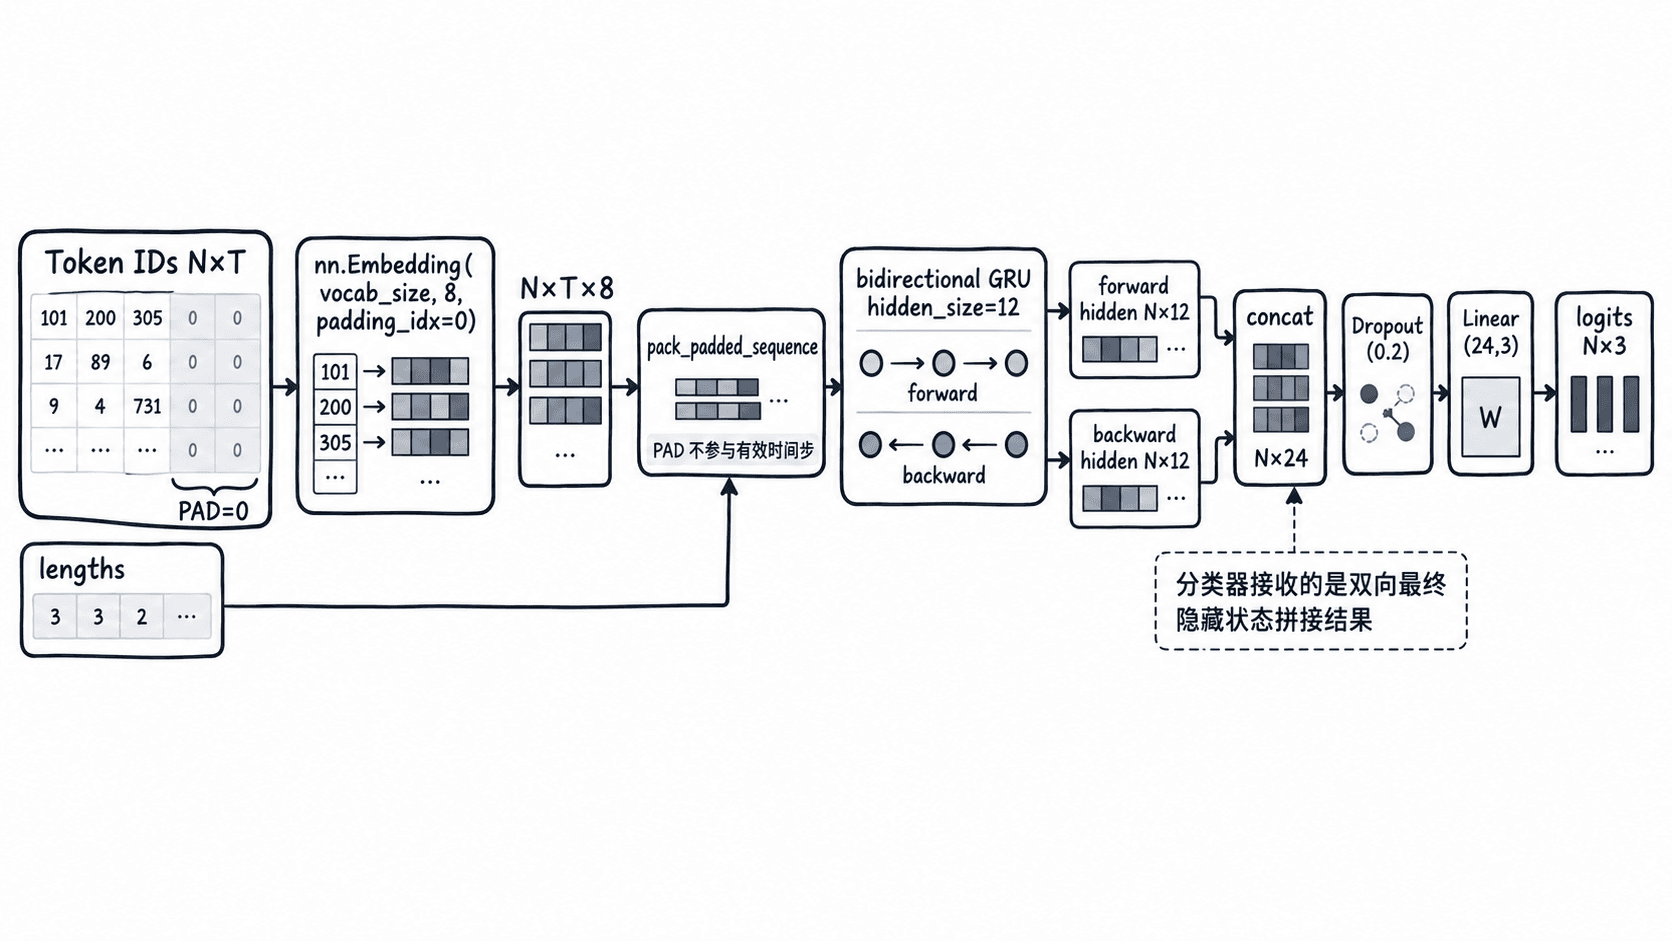
| 阶段 | 形状 | 本例参数 |
|---|---|---|
| 词元 ID | N×T |
3×5 |
| Embedding | N×T×E |
3×5×8 |
| 双向 GRU 最终隐藏状态 | 2×N×H |
2×3×12 |
| 前后向拼接 | N×2H |
3×24 |
| Linear 输出 | N×C |
3×3 |
写出可训练模型
pack_padded_sequence 会让循环层只处理每条样本的真实长度。下面示例包含模型、三条补零后的序列、标签、交叉熵损失和一次 Adam 更新,可直接运行;lengths 放到 CPU 是为了兼容该 API 对长度张量的要求。
import torch
from torch import nn
from torch.nn.utils.rnn import pack_padded_sequence

class TextClassifier(nn.Module):
    def __init__(self, vocab_size=20, emb_dim=8, hidden_size=12, num_classes=3):
        super().__init__()
        self.embedding = nn.Embedding(vocab_size, emb_dim, padding_idx=0)
        self.rnn = nn.GRU(
            input_size=emb_dim,
            hidden_size=hidden_size,
            batch_first=True,
            bidirectional=True,
        )
        self.dropout = nn.Dropout(0.2)
        self.classifier = nn.Linear(hidden_size * 2, num_classes)

    def forward(self, tokens, lengths):
        embedded = self.embedding(tokens)
        packed = pack_padded_sequence(
            embedded,
            lengths.cpu(),
            batch_first=True,
            enforce_sorted=False,
        )
        _, hidden = self.rnn(packed)
        # 最后一层前向和后向隐藏状态各占 hidden 的一行。
        features = torch.cat([hidden[-2], hidden[-1]], dim=1)
        return self.classifier(self.dropout(features))

torch.manual_seed(7)
model = TextClassifier()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

# 0 是 PAD;lengths 记录每行真正参与循环计算的词元数量。
tokens = torch.tensor([
    [1, 4, 7, 9, 0],
    [2, 5, 3, 0, 0],
    [6, 8, 1, 4, 2],
], dtype=torch.long)
lengths = torch.tensor([4, 3, 5])
labels = torch.tensor([0, 2, 1])

model.train()
logits = model(tokens, lengths)
loss = nn.functional.cross_entropy(logits, labels)

optimizer.zero_grad()
loss.backward()
optimizer.step()

print("logits shape:", tuple(logits.shape))
print("pred shape:", tuple(logits.argmax(dim=1).shape))
print("loss is finite:", bool(torch.isfinite(loss)))
预期输出
logits shape: (3, 3)
pred shape: (3,)
loss is finite: True
这里不打印具体 loss 数值,因为参数初始化和底层实现可能让小数略有差异;形状和有限性才是这个构建阶段需要固定验证的接口契约。
正确处理 PAD 与最终隐藏状态
padding_idx=0 会让嵌入层的第 0 行不参与梯度更新,但这并不等价于“循环层自动忽略 PAD”。如果把右侧补零直接送进 GRU,再取最后时间步,短序列仍会额外经过若干个填充位置,GRU 的偏置和门控仍可能改变状态。
因此本例同时传入 [4, 3, 5] 这样的真实长度,并先打包序列。对单层双向 GRU,hidden[-2] 是最后一层前向状态,hidden[-1] 是最后一层后向状态;拼接后维度正好是 2H=24。长度必须大于 0,空文本应在分词阶段插入专用占位词元或单独过滤,不能把 length=0 直接交给打包 API。
让输出层与标签定义一致
多分类时,最后一层直接输出原始 logits,不要先做 softmax 再传给 cross_entropy。标签应是 torch.long,形状为 N,取值范围是 0 到 C-1;本例三分类标签 [0, 2, 1] 与 Linear(24, 3) 一一对应。
如果任务只有正负两类,可以继续使用 num_classes=2 和交叉熵,这样预测仍是 argmax(dim=1)。若改成单个 logit,则损失函数也要改为 BCEWithLogitsLoss,标签通常转成浮点型;不要把“两输出交叉熵”和“单输出二元损失”混在同一模型里。
训练前至少检查三件事:一个 batch 的 logits.shape == (batch_size, num_classes)、loss 为有限标量、执行 backward() 后嵌入层和 GRU 的参数能得到梯度。通过这些接口检查后,再把真实分词器和 DataLoader 接进来,模型结构本身无需改变。