
机器学习与深度学习 / 系统课时
使用卷积层
使用卷积层
nn.Conv2d 把输入图像按局部窗口提取成新的特征图。本课用一个 32×32 RGB 批次配置输入通道、输出通道、卷积核、步长与填充,并用张量形状和参数量检查配置是否符合预期。
学习目标
- 能根据输入张量的通道数填写
in_channels,并用out_channels决定输出特征图数量。 - 能根据
kernel_size、stride、padding和dilation计算卷积后的空间尺寸。 - 能运行
nn.Conv2d并通过输出形状、权重形状和参数量验证配置。
把四个核心参数对应到张量变化
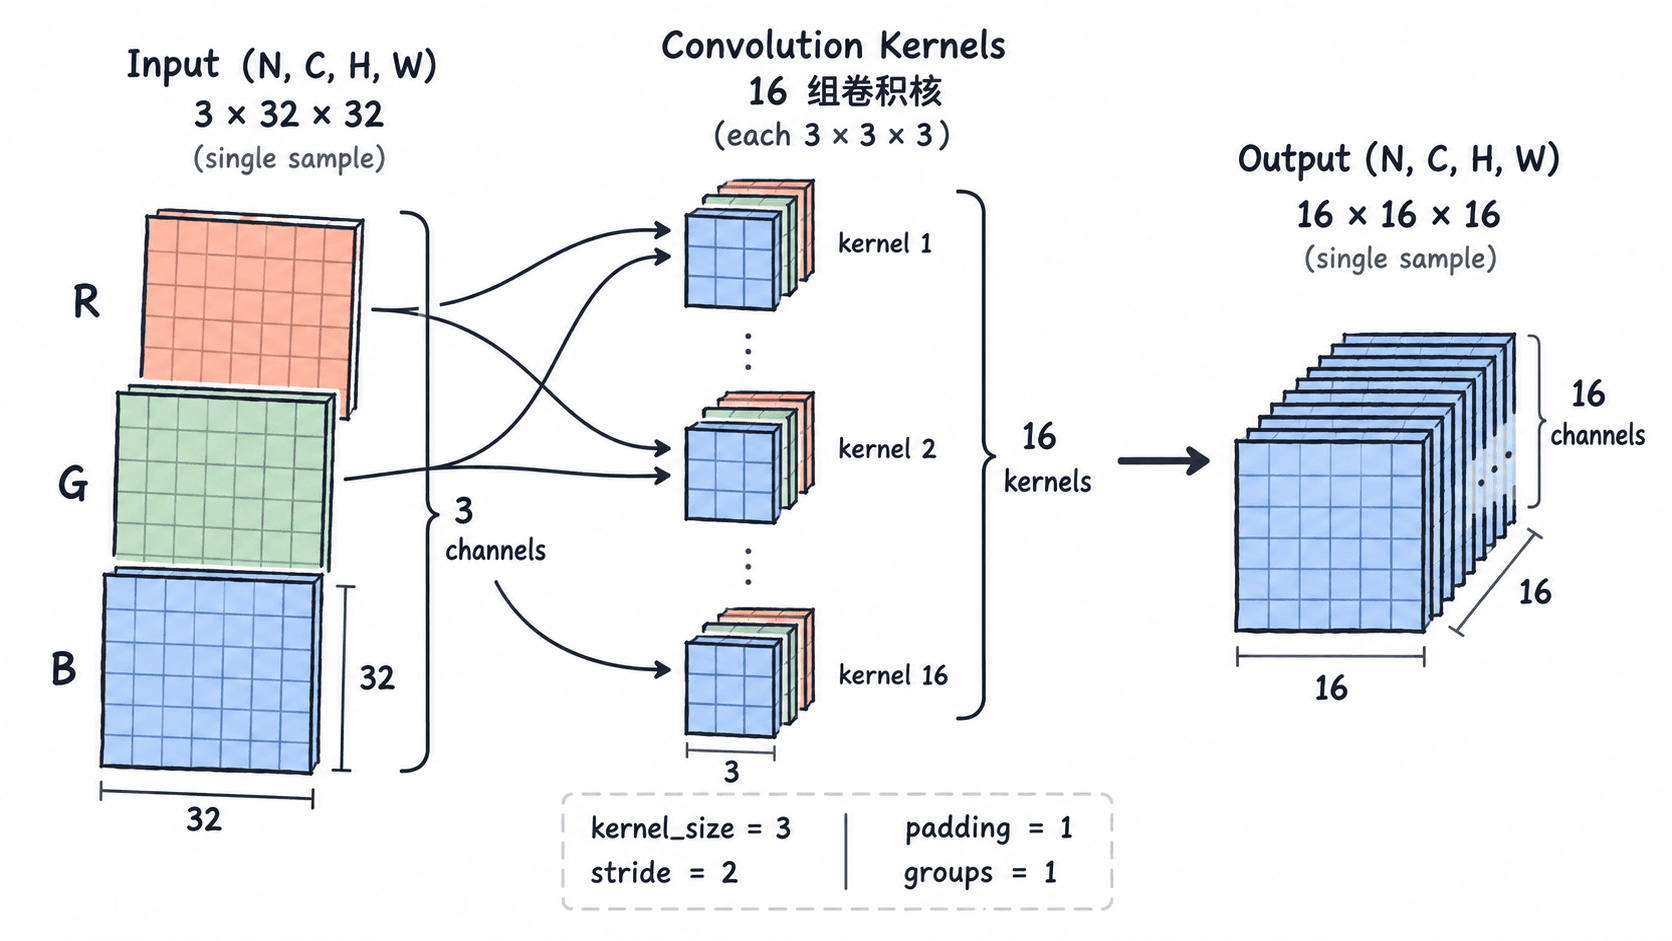
nn.Conv2d(in_channels, out_channels, kernel_size, stride=1, padding=0, dilation=1, groups=1, bias=True) 接收常见的 NCHW 张量。对形状 [N, C, H, W] 而言,in_channels 必须与 C 一致;out_channels 决定输出通道数,空间尺寸则由卷积核、步长、填充和膨胀共同决定。
| 参数 | 示例值 | 直接影响 |
|---|---|---|
in_channels |
3 | 输入必须有 3 个通道,例如 RGB 图像 |
out_channels |
16 | 生成 16 张输出特征图 |
kernel_size |
3 | 每次查看 3×3 的局部区域 |
stride |
2 | 卷积窗口每次移动 2 个像素 |
padding |
1 | 输入四周各补 1 个像素 |
dilation |
1 | 卷积核元素连续采样,不留间隔 |
当 groups=1 时,每个输出通道都会使用全部输入通道。所以上例的权重形状是 [16, 3, 3, 3],不是 [16, 1, 3, 3]。
先算清输出空间尺寸
默认二维卷积每个方向的输出尺寸可以用同一公式计算:
宽度同理。取 H_in=32、K=3、S=2、P=1、D=1,得到 H_out=16,因此 [4, 3, 32, 32] 会变成 [4, 16, 16, 16]。
如果希望 3×3 卷积保持空间尺寸不变,最常见组合是 stride=1、padding=1、dilation=1。若用 padding="same",当前 PyTorch Conv2d 只支持 stride=1,需要下采样时应显式设置整数 padding 与更大的 stride。
跑通一个可验证的卷积层
下面示例只依赖 PyTorch 2.x。随机值本身不重要,因此验证时打印形状与参数量,结果是稳定的。
import torch
from torch import nn

x = torch.randn(4, 3, 32, 32)
conv = nn.Conv2d(
    in_channels=3,
    out_channels=16,
    kernel_size=3,
    stride=2,
    padding=1,
)

y = conv(x)

print("input:", tuple(x.shape))
print("weight:", tuple(conv.weight.shape))
print("output:", tuple(y.shape))
print("params:", sum(p.numel() for p in conv.parameters()))
预期输出:
input: (4, 3, 32, 32)
weight: (16, 3, 3, 3)
output: (4, 16, 16, 16)
params: 448
448 个参数来自 16×3×3×3=432 个权重和 16 个偏置。若设置 bias=False,参数量会变成 432。
避开通道与步长的常见错误
最常见的报错是把 in_channels 写成图像高度或输出通道数。例如输入 [4, 3, 32, 32] 时,第一层应写 in_channels=3;若前一层已经输出 16 个通道,下一层就应从 in_channels=16 开始。
步长也不要只凭“想缩小”来填写。对 32×32 输入,kernel_size=3, stride=2, padding=1 会得到 16×16;若误把 padding 改为 0,输出会变成 15×15。搭网络时先用公式算一遍,再在 forward 后打印 tensor.shape,能在接全连接层之前发现大多数尺寸错误。