
机器学习与深度学习 / 系统课时
编写验证循环
编写验证循环
验证循环的任务不是更新模型,而是用固定参数评估未参与当前更新的数据。正确实现需要同时处理两件事:把模型切到推理行为,并关闭 autograd 的梯度记录;随后按样本数累计损失和指标,避免最后一个小批次把平均值算偏。
学习目标
- 区分
model.eval()与torch.no_grad()各自负责的行为 - 在验证集上正确累计平均损失、正确数和样本数
- 避免验证阶段误更新参数或错误平均批次损失
验证阶段需要关闭什么
验证开始时调用 model.eval(),它会让 Dropout 停止随机丢弃,并让 BatchNorm 使用已有运行统计。它不会关闭梯度记录,因此还需要 torch.no_grad() 或 torch.inference_mode()。
| 控制项 | 推荐写法 | 直接作用 |
|---|---|---|
| 模块运行模式 | model.eval() |
改变 Dropout、BatchNorm 等模块行为 |
| 梯度记录 | with torch.no_grad(): |
不构建反向计算图,降低验证期开销 |
| 参数更新 | 不调用 backward() 和 optimizer.step() |
保持模型参数不变 |
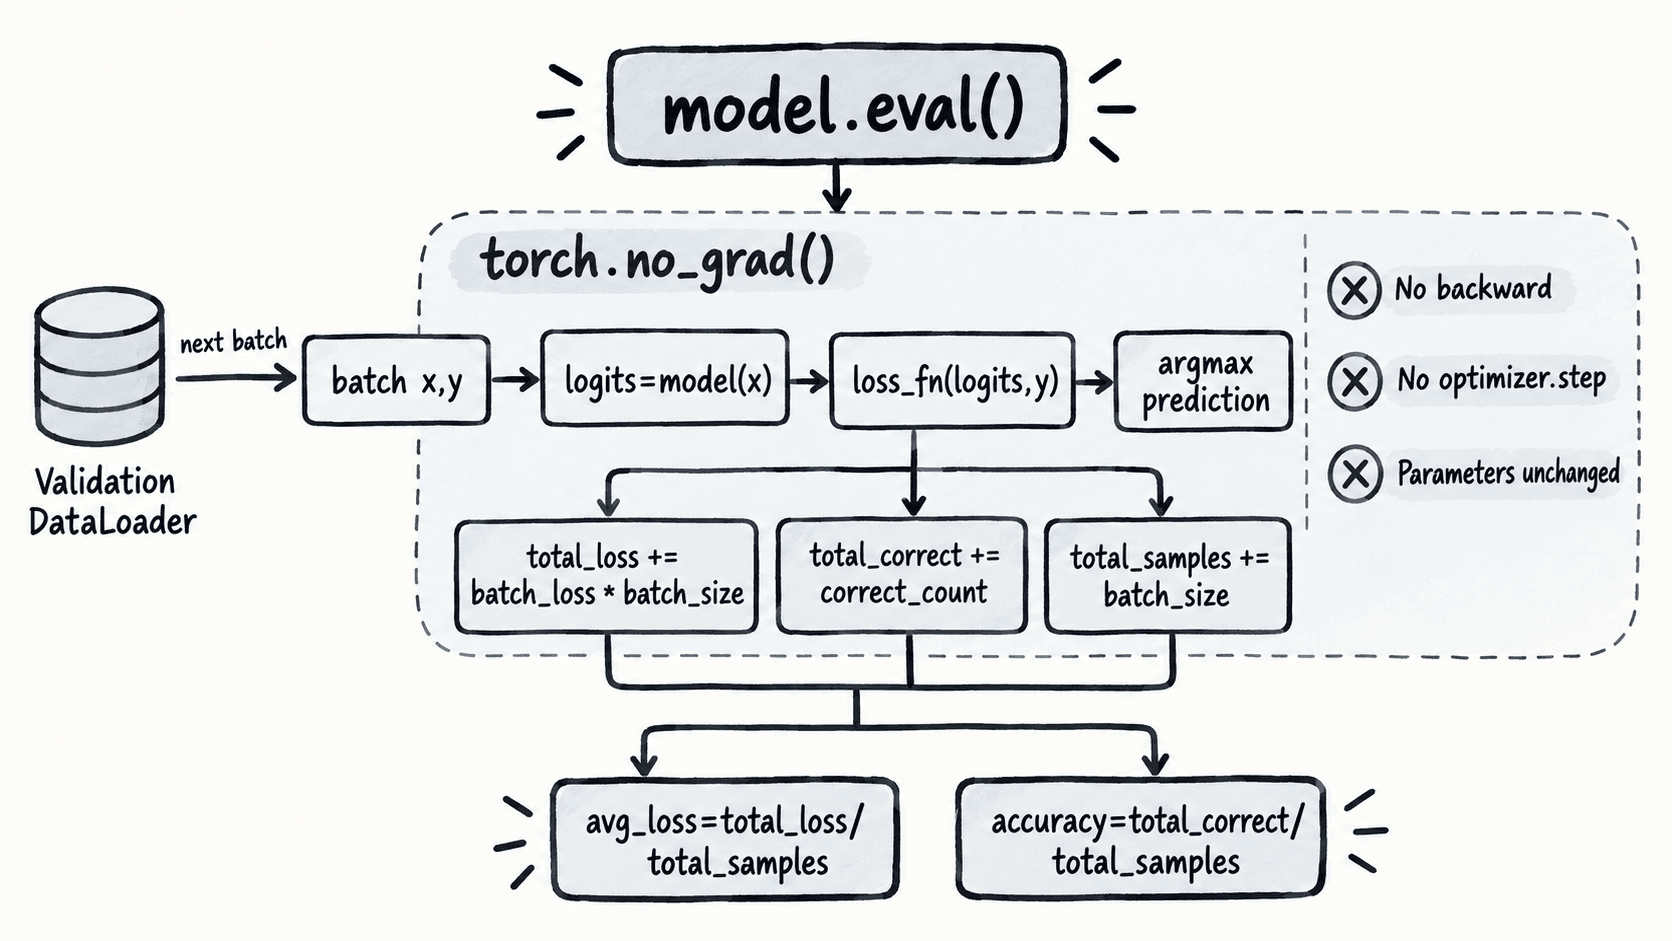
如果只写 model.eval(),前向计算仍可能建立 autograd 图;如果只写 torch.no_grad() 而忘记 eval(),包含 Dropout 或 BatchNorm 的模型会继续表现得像训练阶段。两者解决的是不同问题,不能互相替代。
写出可运行的验证循环
下面固定一个二分类线性模型,使类别 0 更看重第一个输入、类别 1 更看重第二个输入。4 条验证样本都应分类正确。损失函数使用默认的批内平均值,因此累计数据集损失时要乘回 batch_size。
import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

x = torch.tensor([
    [2.0, 0.0],
    [0.0, 2.0],
    [3.0, 1.0],
    [1.0, 3.0],
])
y = torch.tensor([0, 1, 0, 1])

loader = DataLoader(TensorDataset(x, y), batch_size=2, shuffle=False)
model = nn.Linear(2, 2)

with torch.no_grad():
    model.weight.copy_(torch.tensor([
        [1.0, 0.0],
        [0.0, 1.0],
    ]))
    model.bias.zero_()

loss_fn = nn.CrossEntropyLoss()

total_loss = 0.0
total_correct = 0
total_samples = 0
grad_enabled_during_loop = None

model.eval()
with torch.no_grad():
    grad_enabled_during_loop = torch.is_grad_enabled()

    for batch_x, batch_y in loader:
        logits = model(batch_x)
        loss = loss_fn(logits, batch_y)

        batch_size = batch_y.size(0)
        total_loss += loss.item() * batch_size
        total_correct += (logits.argmax(dim=1) == batch_y).sum().item()
        total_samples += batch_size

avg_loss = total_loss / total_samples
accuracy = total_correct / total_samples
all_grads_none = all(p.grad is None for p in model.parameters())

print(f"samples={total_samples}")
print(f"avg_loss={avg_loss:.6f}")
print(f"accuracy={accuracy:.2f}")
print(f"grad_enabled={grad_enabled_during_loop}")
print(f"all_grads_none={all_grads_none}")
预期输出
samples=4
avg_loss=0.126928
accuracy=1.00
grad_enabled=False
all_grads_none=True
这里 accuracy=1.00 说明 4 条样本全部分类正确;all_grads_none=True 则验证了整个评估过程没有执行反向传播。
正确计算数据集级平均值
不能简单把“每个批次的平均损失”再做一次等权平均,除非所有批次大小完全一致。假设验证集有 5 条样本,批大小为 2,三个批次大小分别是 2、2、1;若三个批次平均损失分别为 0.2、0.4、1.0,正确的数据集平均损失是按样本数加权:
若错误地计算 (0.2 + 0.4 + 1.0) / 3,得到约 0.533,最后那个只有 1 条样本的批次被赋予了和前两个批次相同的权重。代码里的 loss.item() * batch_size 正是为了避免这个问题。
防止验证阶段污染训练状态
验证循环不应出现 loss.backward() 或 optimizer.step()。如果训练和验证交替进行,验证结束后下一轮训练开始前要再次执行 model.train();否则 Dropout 会继续关闭,BatchNorm 也不会按训练模式更新运行统计。
实际项目中,建议每轮验证至少记录 avg_loss、核心任务指标和 total_samples。如果样本数突然变少,可以立即发现 DataLoader、过滤条件或分布式采样是否漏数据;比只看一个看似正常的 accuracy 更容易定位验证链路问题。