
机器学习与深度学习 / 系统课时
加入批归一化
加入批归一化
批归一化可以直接插入卷积网络,在训练阶段利用当前批次的统计量规范化各通道特征,同时维护供推理使用的运行均值与方差。本课把 BatchNorm2d 接入一个小型分类器,并验证训练和推理模式确实采用不同的统计方式。
学习目标
- 能正确配置
nn.BatchNorm2d并把它放在卷积层与激活函数之间。 - 能区分训练阶段的批次统计量和推理阶段的运行统计量。
- 能检查 running statistics 是否更新,并避免忘记调用
model.eval()。
明确 BatchNorm2d 处理的维度
对于形状为 [N, C, H, W] 的卷积特征,nn.BatchNorm2d(C) 为每个通道独立计算统计量,训练时统计范围覆盖该通道的 N、H、W 位置。例如卷积输出为 [8, 32, 16, 16],就应创建 nn.BatchNorm2d(32),而不是填写批大小 8 或空间尺寸 16。
常用默认配置是 eps=1e-5、momentum=0.1、affine=True、track_running_stats=True。启用 affine 后,每个通道都有可学习的缩放和偏移参数;启用运行统计后,训练阶段还会更新 running_mean 和 running_var,供 eval 模式使用。
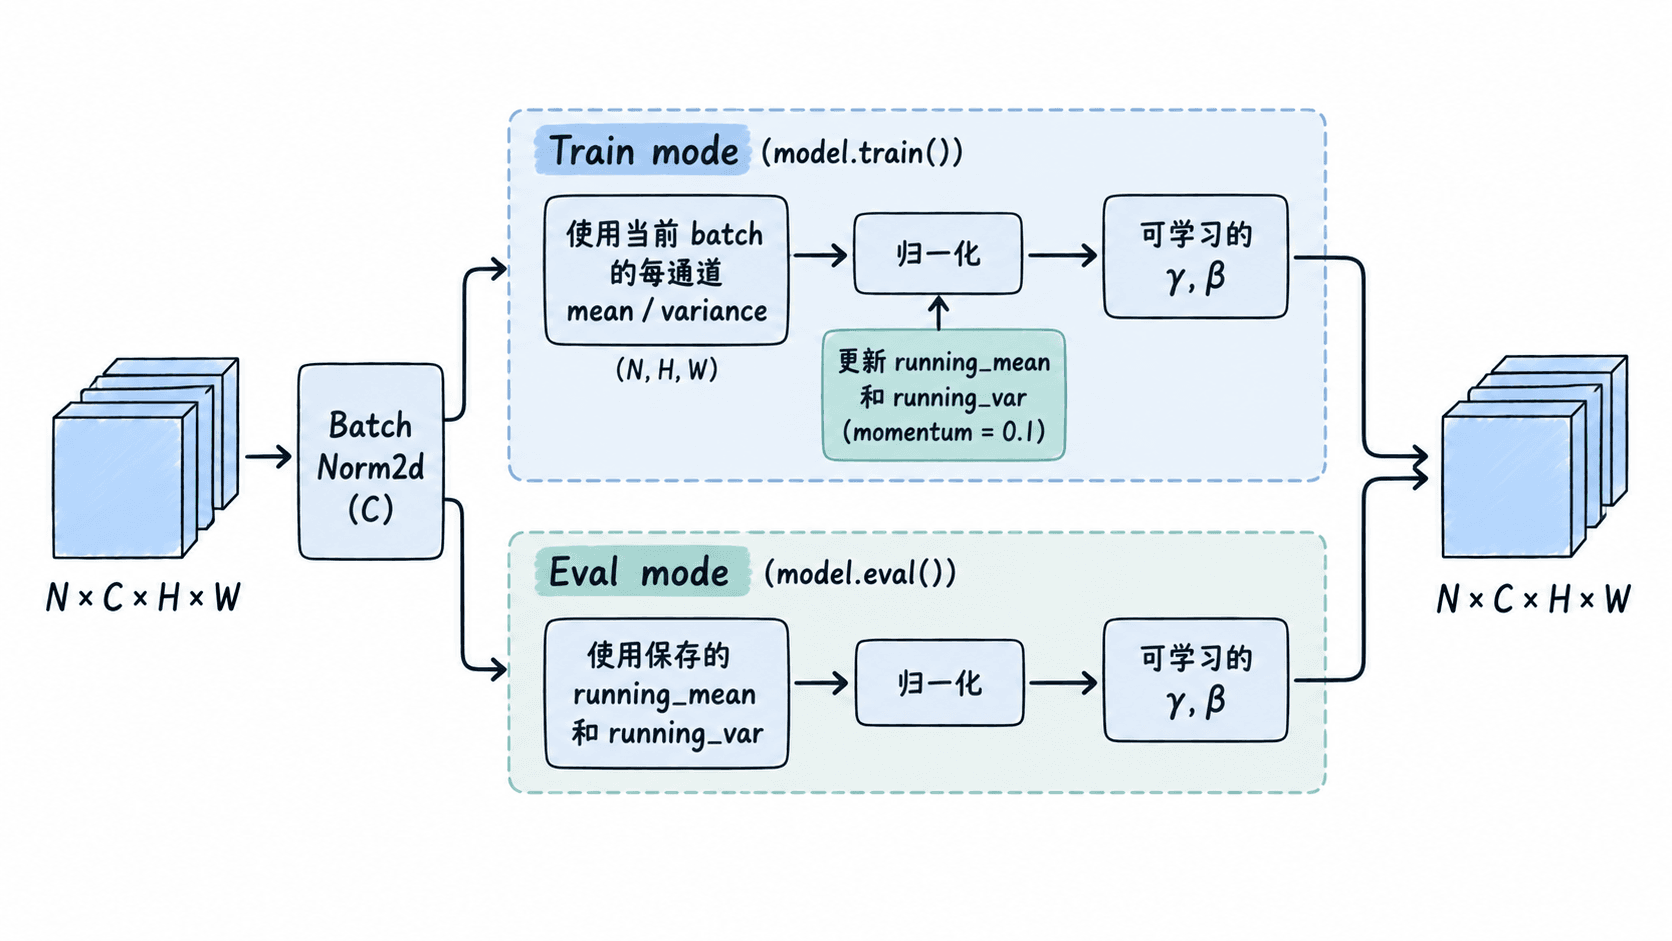
PyTorch 的 momentum 含义容易和优化器动量混淆。对于运行统计量,默认 0.1 表示新统计值主要保留旧值,并加入当前批次统计量的 10%;它不是 SGD 中速度项的定义。
放在卷积之后和激活之前
常见卷积块采用 Conv2d → BatchNorm2d → ReLU。既然 BatchNorm 自带每通道可学习偏移,前面的卷积通常可以设置 bias=False,避免同时维护两个承担相似偏移职责的参数。
下面构建一个带两层批归一化的分类器,完成一次训练更新,再切换到推理模式。程序同时检查第一层 BatchNorm 的运行均值是否已经从初始值发生变化。
import torch
from torch import nn


class BNClassifier(nn.Module):
    def __init__(self, num_classes: int = 10):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(3, 32, kernel_size=3, padding=1, bias=False),
            nn.BatchNorm2d(32),
            nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(32, 64, kernel_size=3, padding=1, bias=False),
            nn.BatchNorm2d(64),
            nn.ReLU(),
            nn.AdaptiveAvgPool2d((1, 1)),
        )
        self.classifier = nn.Linear(64, num_classes)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        x = self.features(x)
        x = torch.flatten(x, 1)
        return self.classifier(x)


def main():
    torch.manual_seed(0)
    model = BNClassifier()
    optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
    criterion = nn.CrossEntropyLoss()

    images = torch.randn(8, 3, 32, 32) * 3 + 5
    labels = torch.arange(8, dtype=torch.long) % 10

    first_bn = model.features[1]
    before = first_bn.running_mean.clone()

    model.train()
    optimizer.zero_grad()
    logits = model(images)
    loss = criterion(logits, labels)
    loss.backward()
    optimizer.step()

    running_mean_changed = not torch.equal(before, first_bn.running_mean)

    model.eval()
    with torch.inference_mode():
        eval_logits = model(images[:2])

    print("train logits shape:", tuple(logits.shape))
    print("running mean changed:", running_mean_changed)
    print("model is in eval mode:", not model.training)
    print("eval logits shape:", tuple(eval_logits.shape))


if __name__ == "__main__":
    main()
预期输出
train logits shape: (8, 10)
running mean changed: True
model is in eval mode: True
eval logits shape: (2, 10)
这四项检查分别证明训练批次能正常通过网络、BatchNorm 的运行统计量确实被更新、模型成功切换为推理模式,并且推理阶段改变批大小不会改变分类维度。
正确切换训练与推理模式
model.train() 和 model.eval() 不只是表达程序意图,它们会真正修改 BatchNorm 的行为。训练阶段应调用 model.train(),让 BatchNorm2d 使用当前批次统计量并更新运行统计;验证和部署推理前则调用 model.eval(),让它使用已经积累的 running_mean 与 running_var。
一个常见错误是验证集仍保持训练模式。这样同一张图片的输出会受到同批其他图片影响,而且验证过程还会继续修改运行统计量。推荐的验证顺序是先执行 model.eval(),再进入 torch.inference_mode(),验证结束后如果还要继续训练,再显式调用 model.train()。
小批次也需要特别检查。批大小很小且特征图空间尺寸也很小时,每批统计量容易波动;如果后期特征达到 [1, C, 1, 1],训练模式下甚至没有足够的每通道样本用于常规 BatchNorm 统计。长期只能使用极小 batch 的模型,可以评估 nn.GroupNorm 等不依赖 batch 维度统计的方案。
用对照实验判断是否值得保留
不要仅凭“加了 BatchNorm”判断模型一定更好。可以固定随机种子、训练集划分、优化器和学习率,仅比较是否加入 BatchNorm,并至少记录前 5 个 epoch 的训练损失和验证指标。例如基线与 BatchNorm 版本都使用 Adam(lr=1e-3),相同 batch size 32,再比较达到同一验证准确率所需的 epoch 数。
检查时重点看三个结果:训练损失是否更平稳、达到目标准确率是否更快、最终验证指标是否真的提升。若 batch size 很小导致曲线剧烈波动,先检查批次统计量问题,而不是继续叠加更多 BatchNorm 层。批归一化是否保留,应由相同训练条件下的可重复对照结果决定。