
机器学习与深度学习 / 系统课时
训练项目基线模型
训练项目基线模型
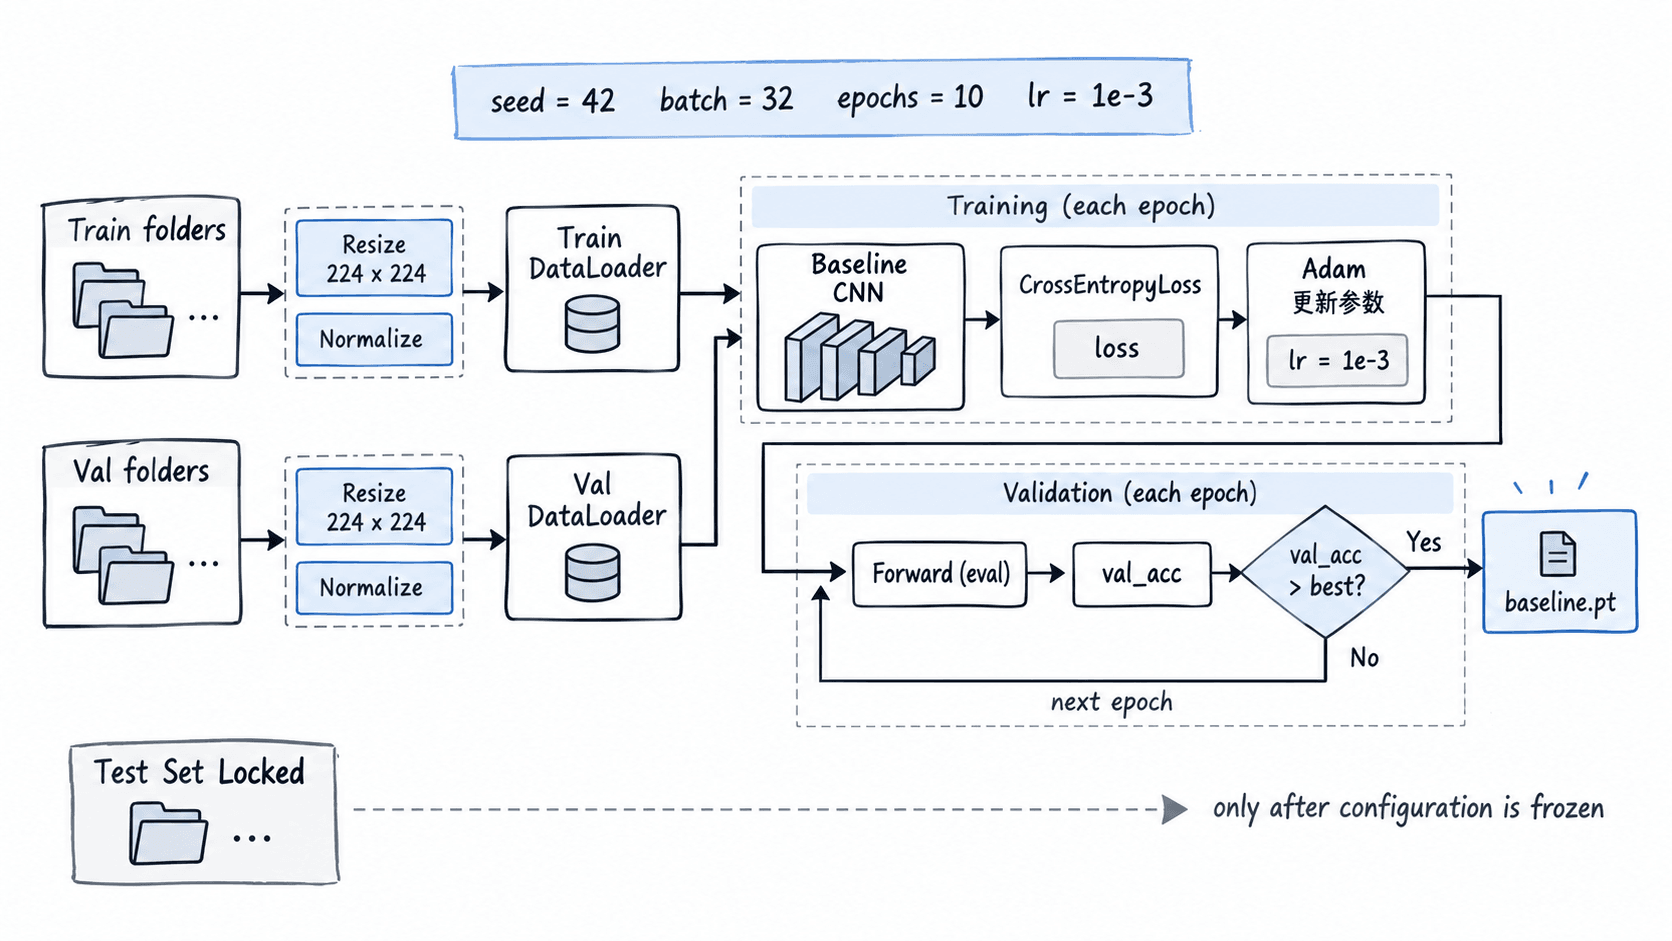
基线模型的任务不是追求最高准确率,而是建立一条可重复运行、可比较、能留下检查点与验证指标的训练链路。下面以多分类图像项目为例,用一个小型 CNN 固定数据处理、随机种子和训练参数,得到后续优化都必须超过的起点。
学习目标
- 固定数据划分、随机种子和训练参数,建立可复现的基线条件。
- 完成训练与验证循环,并保存验证集表现最好的检查点。
- 用训练集与验证集指标判断欠拟合、过拟合或数据流程问题。
固定可比较的基线条件
先冻结会影响比较结果的变量。示例约定训练数据位于 data/train,验证数据位于 data/val,两者都按 ImageFolder 的“每类一个子目录”组织;data/test 如果存在,本课完全不读取,避免在调参阶段泄漏最终测试信息。
| 项目 | 基线值 |
|---|---|
| 输入尺寸 | 224×224 RGB |
| 随机种子 | 42 |
| batch size | 32 |
| epoch | 10 |
| 优化器 | Adam(lr=1e-3) |
| 损失 | CrossEntropyLoss() |
| 数据增强 | 不使用,只做 Resize 与 Normalize |
| DataLoader worker | 0,优先保证复现实验 |
| 选择模型依据 | 最高 val_acc |
CrossEntropyLoss 直接接收未归一化 logits,因此模型末尾不要再手工加 Softmax。类别数由训练目录自动读取,不需要在模型中写死。
运行最小基线训练
保存下面脚本为 train_baseline.py。代码按 PyTorch 2.x 与 torchvision 当前 ImageFolder API 编写;为了让同一软件和硬件环境中的重复实验更稳定,固定 Python/PyTorch 随机种子、关闭 cuDNN benchmark,并启用确定性 cuDNN 算法。
import argparse
import random
from pathlib import Path

import torch
from torch import nn
from torch.utils.data import DataLoader
from torchvision import datasets, transforms

class BaselineCNN(nn.Module):
    def __init__(self, num_classes: int):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(3, 32, 3, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(32, 64, 3, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(64, 128, 3, padding=1),
            nn.ReLU(),
            nn.AdaptiveAvgPool2d(1),
        )
        self.classifier = nn.Linear(128, num_classes)

    def forward(self, x):
        x = self.features(x)
        return self.classifier(x.flatten(1))

def run_epoch(model, loader, criterion, device, optimizer=None):
    training = optimizer is not None
    model.train(training)
    total_loss, correct, total = 0.0, 0, 0

    for images, targets in loader:
        images, targets = images.to(device), targets.to(device)
        with torch.set_grad_enabled(training):
            logits = model(images)
            loss = criterion(logits, targets)
            if training:
                optimizer.zero_grad(set_to_none=True)
                loss.backward()
                optimizer.step()

        total_loss += loss.item() * images.size(0)
        correct += (logits.argmax(1) == targets).sum().item()
        total += images.size(0)

    return total_loss / total, correct / total

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--data", type=Path, default=Path("data"))
    parser.add_argument("--epochs", type=int, default=10)
    parser.add_argument("--seed", type=int, default=42)
    args = parser.parse_args()

    random.seed(args.seed)
    torch.manual_seed(args.seed)
    if torch.cuda.is_available():
        torch.cuda.manual_seed_all(args.seed)
    torch.backends.cudnn.benchmark = False
    torch.backends.cudnn.deterministic = True

    transform = transforms.Compose([
        transforms.Resize((224, 224)),
        transforms.ToTensor(),
        transforms.Normalize(
            mean=(0.485, 0.456, 0.406),
            std=(0.229, 0.224, 0.225),
        ),
    ])
    train_ds = datasets.ImageFolder(args.data / "train", transform=transform)
    val_ds = datasets.ImageFolder(args.data / "val", transform=transform)
    if train_ds.classes != val_ds.classes:
        raise ValueError("train/val class folders must match")

    train_loader = DataLoader(
        train_ds, batch_size=32, shuffle=True, num_workers=0
    )
    val_loader = DataLoader(
        val_ds, batch_size=32, shuffle=False, num_workers=0
    )

    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
    model = BaselineCNN(len(train_ds.classes)).to(device)
    criterion = nn.CrossEntropyLoss()
    optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

    print(f"classes={train_ds.classes}")
    print(f"trainable_params={sum(p.numel() for p in model.parameters())}")

    best_val = -1.0
    for epoch in range(1, args.epochs + 1):
        train_loss, _ = run_epoch(
            model, train_loader, criterion, device, optimizer
        )
        _, val_acc = run_epoch(model, val_loader, criterion, device)

        if val_acc > best_val:
            best_val = val_acc
            torch.save(
                {
                    "model_state": model.state_dict(),
                    "classes": train_ds.classes,
                    "seed": args.seed,
                    "val_acc": best_val,
                    "config": {
                        "epochs": args.epochs,
                        "batch_size": 32,
                        "lr": 1e-3,
                        "input_size": 224,
                    },
                    "torch_version": torch.__version__,
                },
                "baseline.pt",
            )

        print(
            f"epoch={epoch:02d} "
            f"train_loss={train_loss:.4f} val_acc={val_acc:.4f}"
        )

    print(f"best_val_acc={best_val:.4f} checkpoint=baseline.pt")

if __name__ == "__main__":
    main()
预期结果:脚本能完整加载训练集与验证集、训练模型并在验证准确率刷新时覆盖 baseline.pt;它不会读取 data/test。
准备好目录后执行:
python train_baseline.py --data data --epochs 10 --seed 42预期输出的结构如下,<LOSS>、<ACC>、<CLASS_LIST> 与 <N> 会随数据内容和类别数量变化。
classes=<CLASS_LIST>
trainable_params=<N>
epoch=01 train_loss=<LOSS> val_acc=<ACC>
...
epoch=10 train_loss=<LOSS> val_acc=<ACC>
best_val_acc=<ACC> checkpoint=baseline.pt
验收基线是否可信
先检查产物而不是只看最终准确率。baseline.pt 中应同时包含 model_state、classes、seed、最佳 val_acc、训练 config 和 torch_version;日志必须每个 epoch 都有 train_loss 与 val_acc。同一软件、驱动与硬件环境下用相同种子重跑时,结果应可重复;跨 PyTorch、CUDA 或硬件版本则不能把逐位一致当成保证。
如果一个 类任务长期停在约 的随机水平附近,先检查标签目录、归一化和优化器是否真的更新参数。如果训练准确率能到 90%,而验证准确率只有 60%,差距达到 30 个百分点,应把它记录为明显过拟合,而不是继续增加 epoch。
把基线记录成后续实验的锚点
至少保存四项:最佳 val_acc、对应 epoch、训练参数和代码版本。比如基线最佳验证准确率为 0.64,那么后续“优化有效”的最低判断标准应是同一验证集、同一指标下稳定高于 0.64,而不是拿另一份数据或另一种预处理得到的数字直接比较。
当两个方案的验证准确率只差 0.2 个百分点时,不要立即宣布胜负。至少用 3 个随机种子复跑,并同时记录均值和波动;只有收益大于运行噪声,才值得进入下一轮优化。