
机器学习与深度学习 / 系统课时
使用词嵌入层
使用词嵌入层
文本模型不能直接把“电影”“好看”这样的字符串送入神经网络。词嵌入层先接收词元的整数 ID,再从可训练矩阵中查出对应的连续向量。本篇用 nn.Embedding 完成从二维词元批次到三维向量张量的转换,并检查填充词元与索引范围两个常见边界。
学习目标
- 使用
nn.Embedding将整数词元 ID 映射为可训练向量 - 根据输入形状推导嵌入输出的维度
- 正确处理
padding_idx与越界词元 ID
嵌入层本质上是一张可训练查找表
nn.Embedding(num_embeddings, embedding_dim) 内部维护一个形状为 [num_embeddings, embedding_dim] 的参数矩阵。输入中的每个整数不是拿来做数值计算,而是作为行号选择矩阵中的一行。
例如词表共有 6 个 ID,设置 embedding_dim=3 后,权重矩阵就是 [6, 3]。若输入形状为 [2, 3],表示 2 条文本、每条 3 个词元,那么输出形状会变成 [2, 3, 3],最后一维就是每个词元的 3 维表示。
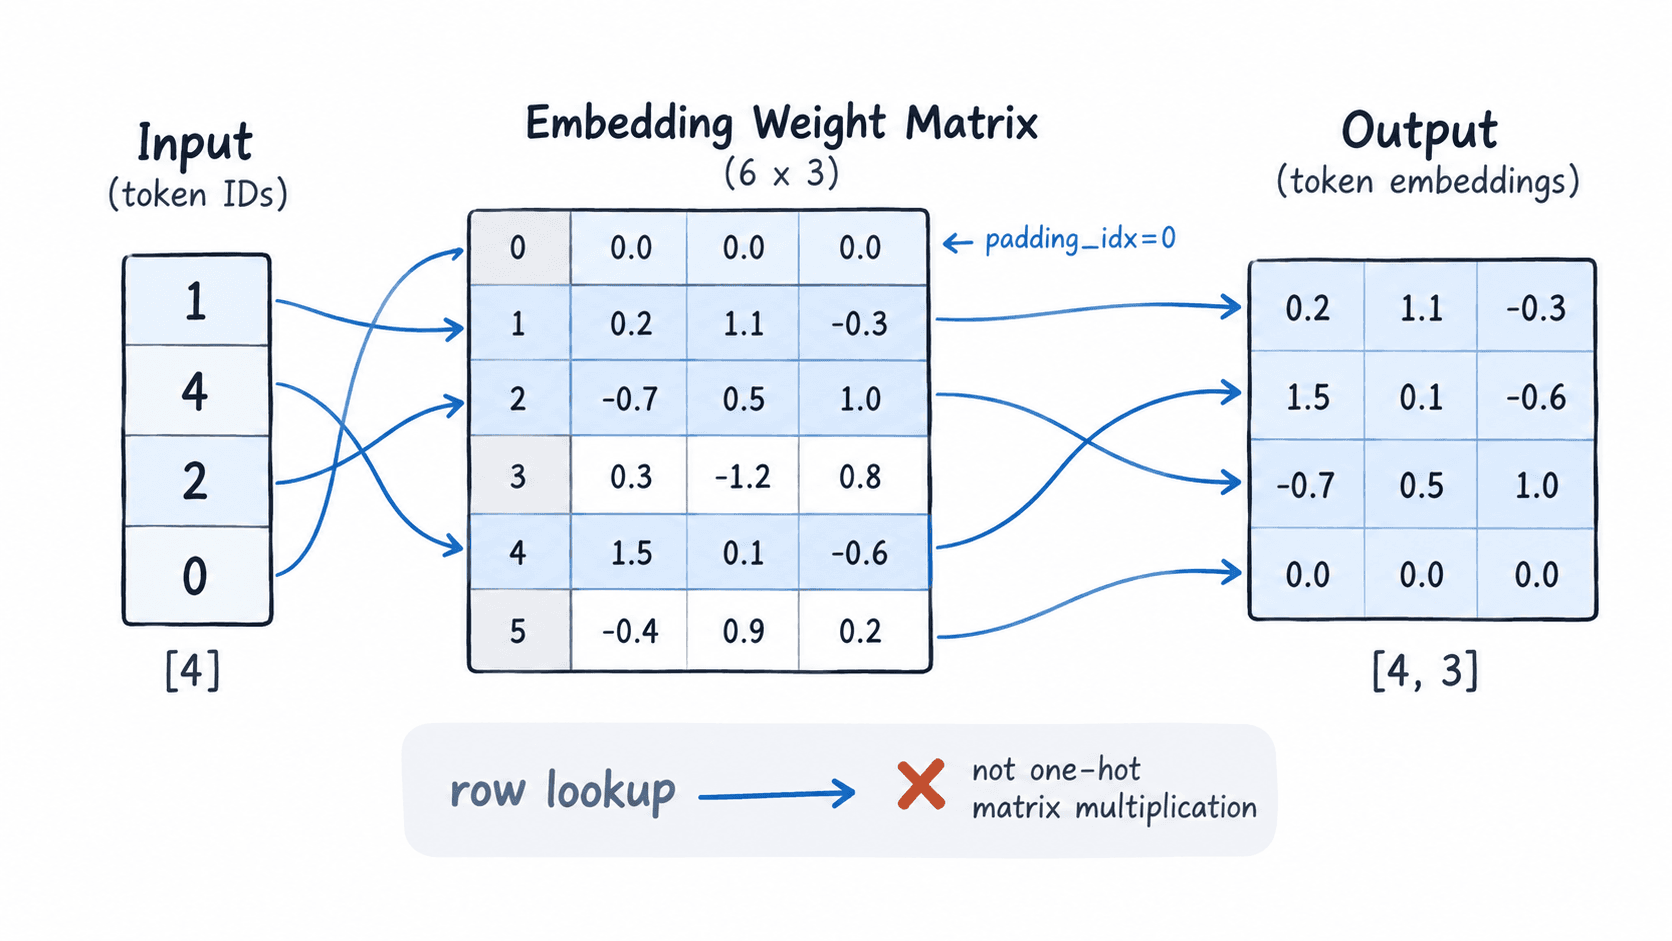
训练时这些行向量与线性层、卷积层等参数一样参与反向传播。某个词元在当前批次出现后,对应行通常会得到梯度;没有出现的行不会因为这次前向传播而被访问。
用 nn.Embedding 完成一次确定的查找
下面把词表大小设为 6、嵌入维度设为 3,并将第 1~5 行写成固定数值。padding_idx=0 保留第 0 行作为填充向量,因此示例既能检查输出形状,也能直接看到 ID 与矩阵行的对应关系。
import torch
from torch import nn

embedding = nn.Embedding(
    num_embeddings=6,
    embedding_dim=3,
    padding_idx=0,
)

# 固定非 padding 行,便于直接核对查找结果。
with torch.no_grad():
    embedding.weight[1:].copy_(torch.tensor([
        [0.1, 0.2, 0.3],
        [0.4, 0.5, 0.6],
        [0.7, 0.8, 0.9],
        [1.0, 1.1, 1.2],
        [1.3, 1.4, 1.5],
    ]))

token_ids = torch.tensor(
    [[1, 2, 0], [3, 4, 5]],
    dtype=torch.long,
)
vectors = embedding(token_ids)

print("shape:", vectors.shape)
print("first sequence:", vectors[0].detach())
print("padding vector:", vectors[0, 2].detach())
预期输出:
shape: torch.Size([2, 3, 3])
first sequence: tensor([[0.1000, 0.2000, 0.3000],
        [0.4000, 0.5000, 0.6000],
        [0.0000, 0.0000, 0.0000]])
padding vector: tensor([0., 0., 0.])
这里的第一个维度 2 是 batch,大小为 3 的第二个维度是序列长度,新增的最后一维 3 来自 embedding_dim。因此后续 RNN、GRU 或 Transformer 接收到的已经不是整数 ID,而是连续浮点向量。
用 padding_idx 隔离补齐位置
文本批处理经常需要把不同长度的序列补到同一长度。例如真实长度分别为 2 和 3 的两条文本可以编码为 [1, 2, 0] 与 [3, 4, 5],其中 ID 0 专门作为 <pad>。
设置 padding_idx=0 后,该位置对应的权重在普通 nn.Embedding 反向传播中不会更新。新建嵌入层时 PyTorch 会把这一行初始化为零,因此可以把补齐位置与真实词元分开。不过如果代码后来手动改写了这一行,它不会自动在每次前向传播时重新清零。
词元 ID 必须落在词表范围内
当 num_embeddings=6 时,合法索引只能是 0~5。若分词器生成了 ID 6 或更大的值,nn.Embedding 会发生索引越界,因此词表、未知词 <unk>、填充词 <pad> 与模型配置必须使用同一套编号。
实际项目可以在进入模型前检查 token_ids.min() 与 token_ids.max()。例如词表大小为 30,000 时,最大 ID 必须小于 30,000;未知词应先由 tokenizer 映射到预留的 <unk> ID,而不是临时生成新的编号。
嵌入层完成的关键转换可以直接用形状检查:整数张量 [batch, seq_len] 输入 nn.Embedding 后得到浮点张量 [batch, seq_len, embedding_dim]。只要词元编号范围、padding_idx 和词表定义保持一致,这个输出就能直接作为序列模型的输入。