
机器学习与深度学习 / 系统课时
部署模型推理接口
部署模型推理接口
在线推理要同时解决模型格式、输入契约、服务进程和结果一致性。这里把一个 4 维特征分类器导出为 ONNX,用 ONNX Runtime 加载,再用 FastAPI 暴露 /health 与 /predict,最后用固定请求验证端到端结果。
学习目标
- 用
torch.onnx.export导出模型,并验证 PyTorch 与 ONNX Runtime 输出一致。 - 用 FastAPI 和 Pydantic 固定 4 维输入契约,返回类别与置信度。
- 启动服务并用真实 HTTP 请求检查健康状态、正确响应和非法输入。
确定服务契约
本例服务只接受一条 4 维浮点特征:请求体为 {"features":[1,2,3,4]},服务端转换为 float32 的 (1, 4) 数组。模型输出 3 类 logits,接口再做 softmax 与 argmax,返回 class_id 和 confidence。长度不是 4 时由 Pydantic 拒绝并返回 HTTP 422。
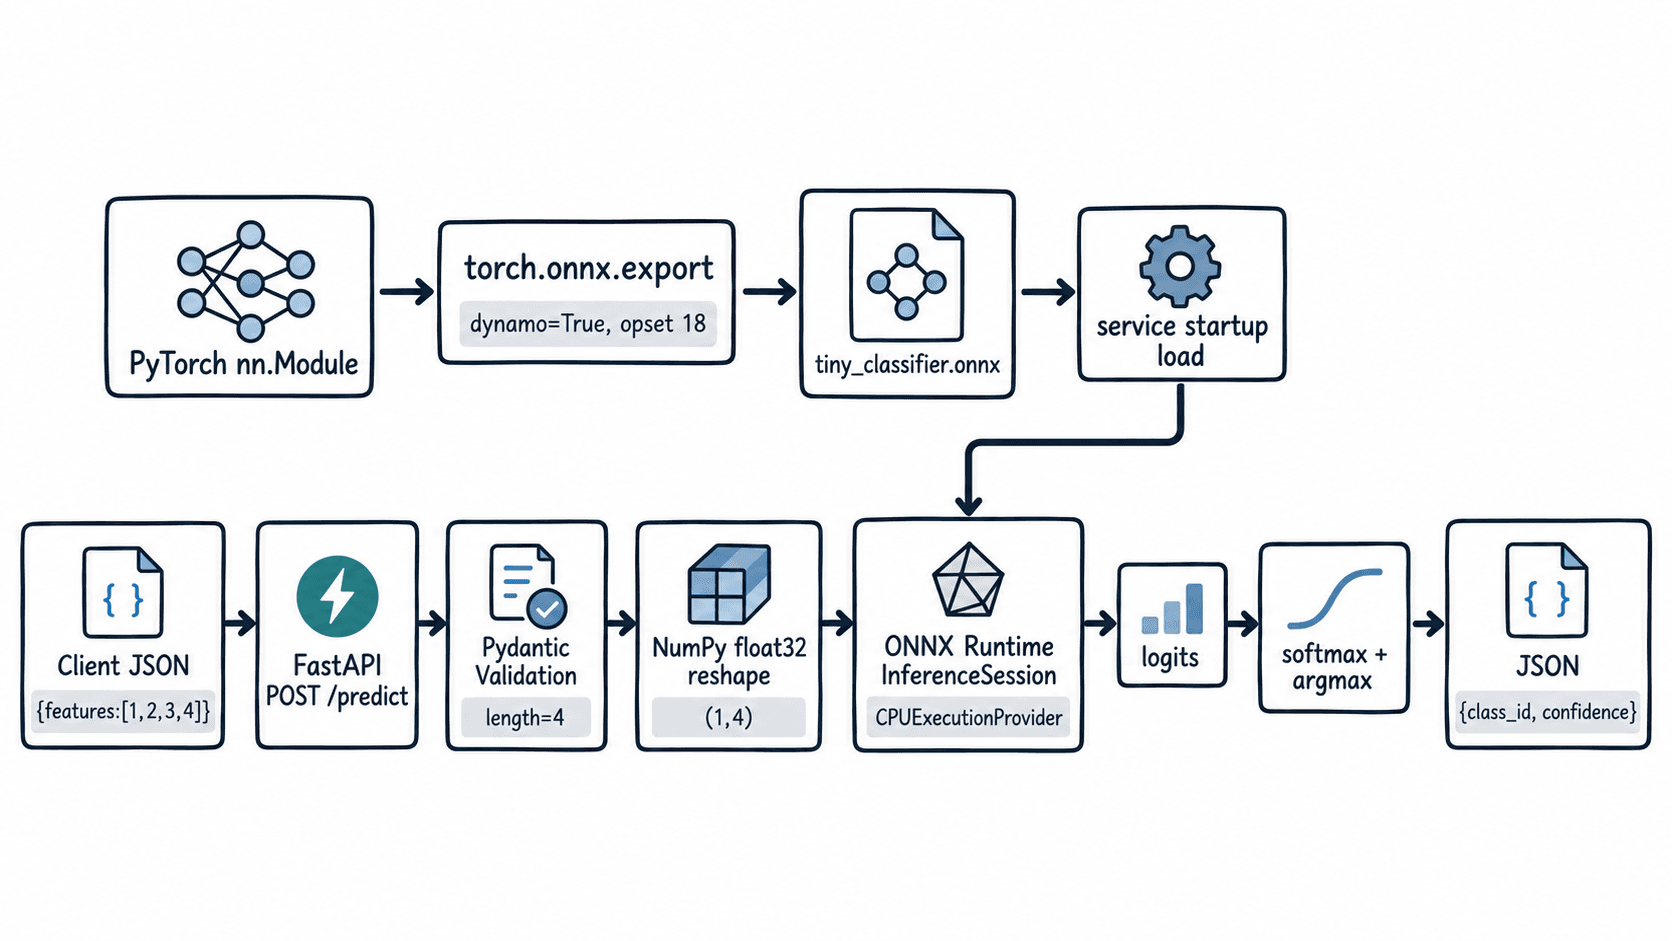
先准备 Python 3.11 环境,并安装 torch>=2.9、onnx、onnxruntime、onnxscript、fastapi、uvicorn 和 numpy。下面用 CPU 推理,避免把 GPU 驱动差异混进接口验证。
python -m pip install "torch>=2.9" onnx onnxruntime onnxscript fastapi "uvicorn[standard]" numpy
python -c "import torch, onnx, onnxruntime, fastapi; print('deps=ok')"
预期输出末尾应出现:
deps=ok导出并校验 ONNX
下面的 export_model.py 创建一个固定权重的 Linear(4, 3) 分类器。显式写 dynamo=True,并在保存后同时执行 ONNX checker 与 ONNX Runtime 一致性断言;这样“成功生成文件”不等于“模型可运行”。
import numpy as np
import onnx
import onnxruntime as ort
import torch
from torch import nn

class TinyClassifier(nn.Module):
    def __init__(self) -> None:
        super().__init__()
        self.fc = nn.Linear(4, 3)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.fc(x)

model = TinyClassifier()
with torch.no_grad():
    model.fc.weight.copy_(
        torch.tensor(
            [
                [1.0, 0.0, 0.0, 0.0],
                [0.0, 1.0, 0.0, 0.0],
                [0.0, 0.0, 1.0, 1.0],
            ],
            dtype=torch.float32,
        )
    )
    model.fc.bias.zero_()
model.eval()

example = torch.tensor([[1.0, 2.0, 3.0, 4.0]], dtype=torch.float32)
onnx_program = torch.onnx.export(
    model,
    (example,),
    input_names=["features"],
    output_names=["logits"],
    opset_version=18,
    dynamo=True,
)
onnx_program.save("tiny_classifier.onnx")

# 文件结构先过 ONNX checker,再用同一输入比较两个运行时的数值。
onnx.checker.check_model(onnx.load("tiny_classifier.onnx"))
session = ort.InferenceSession(
    "tiny_classifier.onnx",
    providers=["CPUExecutionProvider"],
)
ort_logits = session.run(None, {"features": example.numpy()})[0]
with torch.no_grad():
    torch_logits = model(example).numpy()
np.testing.assert_allclose(ort_logits, torch_logits, rtol=1e-5, atol=1e-6)

print(f"pytorch_logits={torch_logits.tolist()}")
print("saved=tiny_classifier.onnx")
print("consistency=ok")
预期输出中应包含以下三行;不同 PyTorch 版本可能额外打印导出进度:
pytorch_logits=[[1.0, 2.0, 7.0]]
saved=tiny_classifier.onnx
consistency=ok
构建 FastAPI 服务
把下面内容保存为 app.py,并与 tiny_classifier.onnx 放在同一目录。服务启动时立即创建 InferenceSession;如果模型缺失或损坏,进程会直接启动失败,而不是等第一条业务请求才暴露问题。
import numpy as np
import onnxruntime as ort
import uvicorn
from fastapi import FastAPI
from pydantic import BaseModel, Field

MODEL_PATH = "tiny_classifier.onnx"

session = ort.InferenceSession(
    MODEL_PATH,
    providers=["CPUExecutionProvider"],
)
input_name = session.get_inputs()[0].name

# 启动期做一次固定形状 warm-up,提前暴露输入名或形状不匹配。
session.run(
    None,
    {input_name: np.zeros((1, 4), dtype=np.float32)},
)

app = FastAPI()

class PredictRequest(BaseModel):
    features: list[float] = Field(min_length=4, max_length=4)

class PredictResponse(BaseModel):
    class_id: int
    confidence: float

@app.get("/health")
def health() -> dict[str, str]:
    return {"status": "ok", "model": MODEL_PATH}

@app.post("/predict", response_model=PredictResponse)
def predict(payload: PredictRequest) -> PredictResponse:
    x = np.asarray(payload.features, dtype=np.float32).reshape(1, 4)
    logits = session.run(None, {input_name: x})[0][0]

    # 先减最大值再指数化,避免 softmax 在大 logits 上溢出。
    exp_logits = np.exp(logits - logits.max())
    probs = exp_logits / exp_logits.sum()
    class_id = int(np.argmax(probs))
    return PredictResponse(
        class_id=class_id,
        confidence=round(float(probs[class_id]), 6),
    )

if __name__ == "__main__":
    uvicorn.run(app, host="127.0.0.1", port=8000)
预期结果:执行 python app.py 后进程保持运行,关键启动日志类似下面三行,实际 PID 可能不同。
INFO:     Started server process [<PID>]
INFO:     Application startup complete.
INFO:     Uvicorn running on http://127.0.0.1:8000 (Press CTRL+C to quit)
调用接口做端到端验收
保持服务进程运行,在另一个终端执行三次请求:先检查模型是否已加载,再验证固定输入的预测,最后故意发送 3 维特征检查契约拒绝是否生效。
curl -s http://127.0.0.1:8000/health
echo
curl -s -X POST http://127.0.0.1:8000/predict -H "Content-Type: application/json" -d '{"features":[1,2,3,4]}'
echo
curl -s -o /dev/null -w "%{http_code}\n" -X POST http://127.0.0.1:8000/predict -H "Content-Type: application/json" -d '{"features":[1,2,3]}'
预期输出:
{"status":"ok","model":"tiny_classifier.onnx"}
{"class_id":2,"confidence":0.990867}
422
class_id=2 对应第三个 logit,因为固定权重产生 [1, 2, 7];422 则说明输入长度约束已经在进入 ONNX Runtime 之前生效。
处理上线前边界
这个最小服务可用于验证部署链路,但生产发布前至少要再锁定四件事:模型文件使用内容哈希或版本号而不是覆盖同名文件;训练时的标准化、词表或图像预处理必须与服务端完全一致;健康检查要区分“进程活着”和“模型可推理”;CPU 压测时记录 P50/P95 延迟与吞吐,而不是只看单次 curl。
如果训练阶段对 4 个特征做过标准化,就不能把原始数值直接送入当前接口。正确做法是把相同的 mean/std 固化进模型图或服务代码,并用一组黄金输入同时跑 PyTorch 与线上接口做回归;两端类别一致且概率差在约定容差内,才算部署验收完成。