
机器学习与深度学习 / 系统课时
处理变长批次数据
处理变长批次数据
文本、语音和轨迹样本常常长度不同,默认 DataLoader 无法直接堆叠。本课用自定义 collate_fn 在批次级完成 padding,并返回真实长度与有效位置掩码,让 RNN 或 Transformer 正确忽略补齐值。
学习目标
- 能解释默认批处理为什么无法直接堆叠不同长度的张量。
- 能用
pad_sequence编写可直接传给DataLoader的collate_fn。 - 能同时生成长度张量和有效位置掩码,并按模型接口转换掩码语义。
为什么默认批处理会失败
假设三个 token 序列长度分别为 3、1、4。默认 collate 会尝试执行类似 torch.stack 的操作,但 [3]、[1]、[4] 形状不同,无法沿新的 batch 维拼成一个矩形张量。
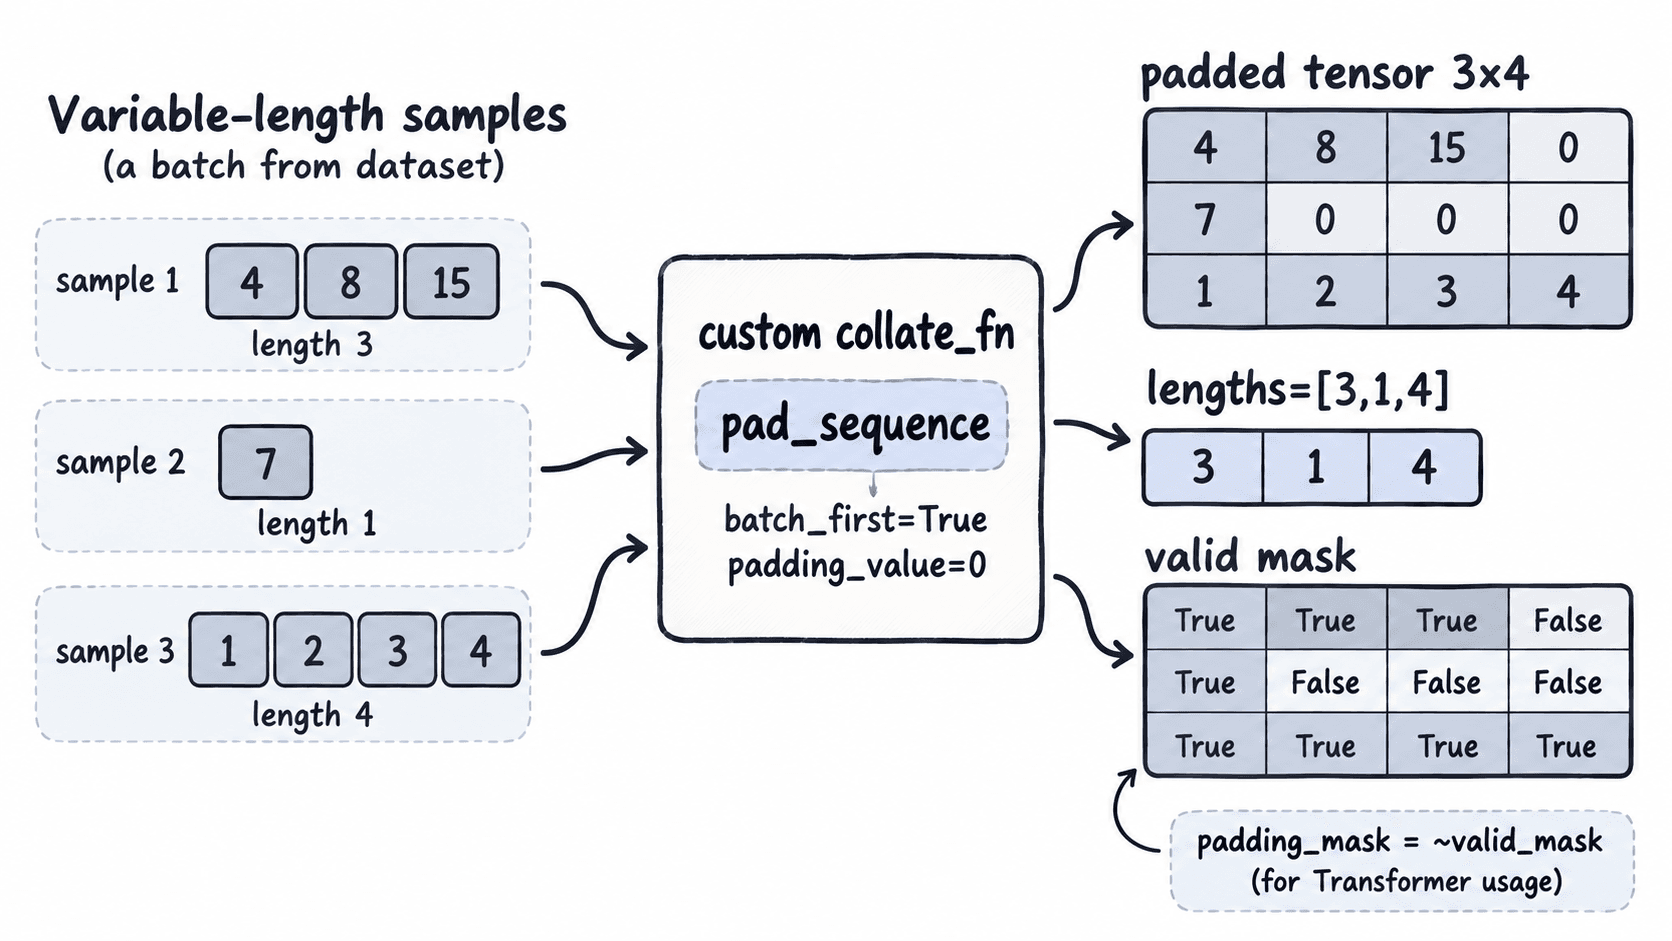
解决位置应放在 collate_fn,因为它拿到的是“一整个待组批的样本列表”,最适合计算当前批次的最大长度并只补到该长度。相比在 Dataset 中提前补到全局最大长度,这样通常能减少无效 padding 和显存浪费。
自定义 collate_fn
下面示例构造三个不同长度的整数序列。padding_value=0 只是本例约定;真实文本任务应确保 0 与词表中的 padding token 定义一致。
import torch
from torch.nn.utils.rnn import pad_sequence
from torch.utils.data import DataLoader, Dataset

class ToyDataset(Dataset):
    def __init__(self):
        self.samples = [
            (torch.tensor([4, 8, 15]), 0),
            (torch.tensor([7]), 1),
            (torch.tensor([1, 2, 3, 4]), 0),
        ]

    def __len__(self):
        return len(self.samples)

    def __getitem__(self, index):
        return self.samples[index]

def collate_batch(batch):
    sequences, labels = zip(*batch)
    lengths = torch.tensor([seq.numel() for seq in sequences])

    # 只补到当前批次中的最大长度,输出形状为 [batch, max_len]。
    padded = pad_sequence(
        sequences,
        batch_first=True,
        padding_value=0,
    )

    positions = torch.arange(padded.size(1)).unsqueeze(0)
    valid_mask = positions < lengths.unsqueeze(1)

    return padded, lengths, valid_mask, torch.tensor(labels)

loader = DataLoader(
    ToyDataset(),
    batch_size=3,
    shuffle=False,
    collate_fn=collate_batch,
)

padded, lengths, valid_mask, labels = next(iter(loader))
print(padded)
print(lengths)
print(valid_mask)
print(labels)
预期输出
tensor([[ 4,  8, 15,  0],
        [ 7,  0,  0,  0],
        [ 1,  2,  3,  4]])
tensor([3, 1, 4])
tensor([[ True,  True,  True, False],
        [ True, False, False, False],
        [ True,  True,  True,  True]])
tensor([0, 1, 0])
这里 padded.shape 为 [3, 4],因为当前批次最长序列长度是 4。如果下一批最长只有 2,它只会补到 2,不会沿用上一批的长度。
让模型知道真实长度
padding 只是为了把数据排成矩形,补出的 0 不应被当成真实 token。RNN 常用 lengths 配合 pack_padded_sequence;如果序列没有按长度降序排列,传入 enforce_sorted=False 即可。
Transformer 更常用 padding mask。需要特别注意掩码语义:上例的 valid_mask=True 表示“这是有效位置”,而 PyTorch nn.Transformer 的 src_key_padding_mask=True 表示“这个位置要被忽略”,因此应传入 ~valid_mask。本例得到的第一行 padding mask 是 [False, False, False, True]。
边界与性能
批次内长度差异越大,padding 浪费越明显。若一个 batch 中最短长度为 20、最长为 1000,短样本会产生大量无效位置。工程上可按长度分桶,再在桶内随机组批,让相近长度的样本进入同一 batch。
对于嵌套结构,例如每个样本同时包含 input_ids、标签和原始字符串,collate_fn 可以只对张量字段补齐,字符串保留为 Python 列表。验收时检查四项即可:padded.size(0) 等于 batch size、lengths.max() 等于 padded.size(1)、每行 valid_mask.sum() 等于对应长度、padding 区域全部等于约定的 padding_value。