
机器学习与深度学习 / 系统课时
诊断梯度异常
诊断梯度异常
梯度异常通常表现为参数完全不更新、loss 突然变成 NaN、更新幅度失控,或深层网络几乎学不动。这一课建立固定排查顺序,并用可运行脚本区分零梯度、非有限梯度、梯度爆炸和梯度消失。
学习目标
- 区分
.grad is None、零梯度、非有限梯度、爆炸和消失。 - 使用
torch.isfinite与梯度范数快速定位异常参数。 - 根据异常类型选择断图修复、数值保护、梯度裁剪或网络结构调整。
先区分四类梯度症状
不要把“参数没变化”都归结为梯度为零。p.grad is None 表示当前反向传播根本没有为该参数产生梯度;p.grad 存在但范数为 0,才属于零梯度。
| 症状 | 可直接检查的信号 | 常见原因 |
|---|---|---|
| 零梯度 | p.grad.norm()==0 |
ReLU 落在负半轴、局部导数为零、梯度抵消 |
| 非有限值 | torch.isfinite(p.grad).all()==False |
除零、非法 log/sqrt、溢出 |
| 梯度爆炸 | 范数比正常层高多个数量级 | 深层连乘、过大学习率、不稳定递归结构 |
| 梯度消失 | 深层梯度持续接近 0 | 多层小导数连乘、深层 sigmoid/tanh 路径 |
调试时可以先把 1e-8 以下视为“疑似消失”、1e3 以上视为“疑似爆炸”,但这两个数只是排查阈值,不是通用训练标准。真实模型应结合参数尺度以及正常训练阶段的梯度基线判断。
按固定顺序定位异常
一次反向传播完成后,先检查 loss,再检查参数梯度。推荐顺序是:确认 loss 是否有限;检查 .grad is None;检查梯度中是否包含 NaN 或 Inf;计算各层梯度范数;最后根据层级位置寻找异常从哪一层开始出现。
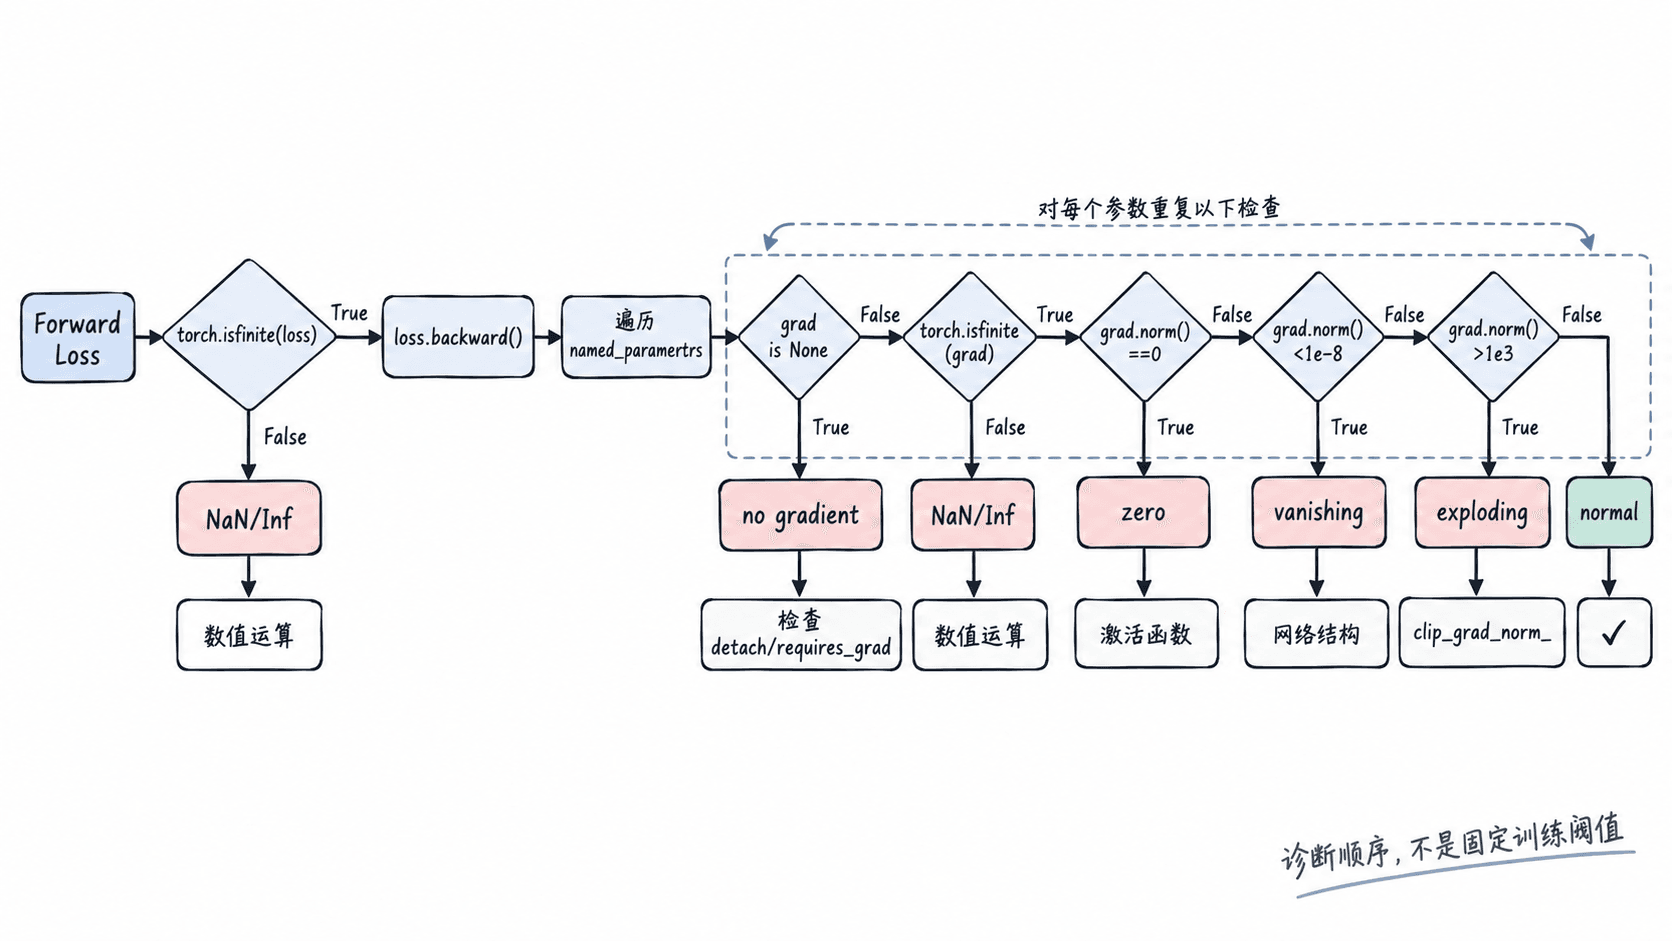
如果某层的梯度先出现非有限值,它通常比最终 loss 变成 NaN 更接近根因。调试短复现时可以使用 torch.autograd.detect_anomaly(check_nan=True) 定位产生异常反向值的运算;它有明显性能开销,不应长期包住完整训练任务。
用脚本给梯度分类
下面构造四个参数,并故意让它们分别得到 0、1e-12、1e6 和 NaN 梯度。分类函数与真实模型的检查方式相同,因此可以直接把遍历部分迁移到训练代码中。
import torch
from torch import nn

class GradientProbe(nn.Module):
    def __init__(self):
        super().__init__()
        self.zero = nn.Parameter(torch.tensor(1.0))
        self.vanishing = nn.Parameter(torch.tensor(1.0))
        self.exploding = nn.Parameter(torch.tensor(1.0))
        self.non_finite = nn.Parameter(torch.tensor(1.0))

    def forward(self):
        nan_value = torch.tensor(float("nan"))
        return (
            self.zero * 0.0
            + self.vanishing * 1e-12
            + self.exploding * 1e6
            + self.non_finite * nan_value
        )

def classify_gradient(grad):
    if grad is None:
        return "no_grad"
    if not bool(torch.isfinite(grad).all()):
        return "non_finite"

    norm = grad.detach().norm().item()
    if norm == 0.0:
        return "zero"
    if norm < 1e-8:
        return "vanishing"
    if norm > 1e3:
        return "exploding"
    return "ok"

model = GradientProbe()
loss = model()
loss.backward()

print(f"loss_finite={bool(torch.isfinite(loss))}")
for name, parameter in model.named_parameters():
    print(f"{name}: {classify_gradient(parameter.grad)}")
预期输出
loss_finite=False
zero: zero
vanishing: vanishing
exploding: exploding
non_finite: non_finite
真实模型中还要单独记录 grad is None。例如参数被设为 requires_grad=False、前向路径没有使用该参数,或中途对张量调用 detach(),都会导致参数没有梯度,而不是得到数值为 0 的梯度。
按根因选择修复方式
遇到非有限梯度时,先检查产生非有限 loss 的运算。例如对可能为 0 的分母增加合理下界,或在业务允许时将对数输入限制为 x.clamp_min(1e-8);不要仅在出现 NaN 后把它替换成 0,因为这会隐藏真正的数值错误。
梯度爆炸时可先降低学习率,例如从 1e-3 降到 1e-4,并在 loss.backward() 之后、optimizer.step() 之前调用 torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)。裁剪能限制更新幅度,但如果梯度每一步都严重爆炸,还应继续检查初始化、输入尺度和网络结构。
梯度消失需要观察它是否沿网络深度持续衰减。深层 sigmoid 路径可考虑改用 ReLU 或 GELU,并检查是否适合加入残差连接;ReLU 大量输出恒为 0 时,则应检查输入分布和初始化,必要时比较 nn.LeakyReLU(negative_slope=0.01) 的结果。
在训练环里设置验收线
实际排障时可以连续观察 100 个训练 step:每一步要求 loss 与所有已有梯度均通过 torch.isfinite;使用 max_norm=1.0 裁剪时,裁剪后的全局梯度范数应受限制;此前长期为 None 或接近 0 的关键层应重新出现可测梯度。
如果 loss 已恢复为有限值但关键层仍持续没有梯度,应优先追踪计算图是否被切断,而不是继续调学习率。反过来,如果各层梯度都存在且有限,只是数值整体偏大或偏小,再调整学习率、裁剪阈值、初始化或网络结构才有意义。