
机器学习与深度学习 / 系统课时
构建文本词表
构建文本词表
文本模型不能直接处理单词字符串,需要先把文本稳定地切成词元,再把词元映射为整数索引。本篇完成一条可复现的最小词表流水线,并处理低频词、未知词和训练集之外的新词。
学习目标
- 用固定规则完成分词与词频统计。
- 生成确定性的
token -> id和id -> token映射。 - 使用
<pad>、<unk>和最小词频处理真实数据中的边界情况。
先固定分词规则
词表的输入不是原始字符串,而是分词后的词元。训练和推理必须使用同一套规则,否则同一句话可能得到不同索引。一个简单英文基线可以先统一转小写,再只提取字母序列;真实项目若使用子词模型,也应把分词器版本与模型一起保存。
示例中只用训练语料构建词表,避免把验证集或测试集的新词提前泄漏进词表。假设训练文本为三句,PyTorch 与 pytorch 会在小写化后合并为同一个词元。
从词频生成稳定索引
下面示例适用于 Python 3.10+ 与 PyTorch 2.x。min_freq=2 会过滤只出现一次的 clear 和 makes;频率相同时再按字典序排序,从而让相同语料每次生成相同索引。
import re
from collections import Counter

import torch


def tokenize(text: str) -> list[str]:
    return re.findall(r"[a-z]+", text.lower())


def build_vocab(counter: Counter, min_freq: int = 2):
    specials = ['<pad>', '<unk>']
    kept = [token for token, freq in counter.items() if freq >= min_freq]
    kept.sort(key=lambda token: (-counter[token], token))

    itos = specials + kept
    stoi = {token: idx for idx, token in enumerate(itos)}
    return stoi, itos


docs = [
    'PyTorch makes tensor code clear.',
    'Tensor code needs data.',
    'PyTorch needs data.',
]

counter = Counter(token for doc in docs for token in tokenize(doc))
stoi, itos = build_vocab(counter, min_freq=2)

sample = 'PyTorch needs unseen data.'
ids = [stoi.get(token, stoi['<unk>']) for token in tokenize(sample)]
encoded = torch.tensor(ids, dtype=torch.long)

print(sorted(counter.items()))
print(stoi)
print(encoded.tolist())
预期输出
[('clear', 1), ('code', 2), ('data', 2), ('makes', 1), ('needs', 2), ('pytorch', 2), ('tensor', 2)]
{'<pad>': 0, '<unk>': 1, 'code': 2, 'data': 3, 'needs': 4, 'pytorch': 5, 'tensor': 6}
[5, 4, 1, 3]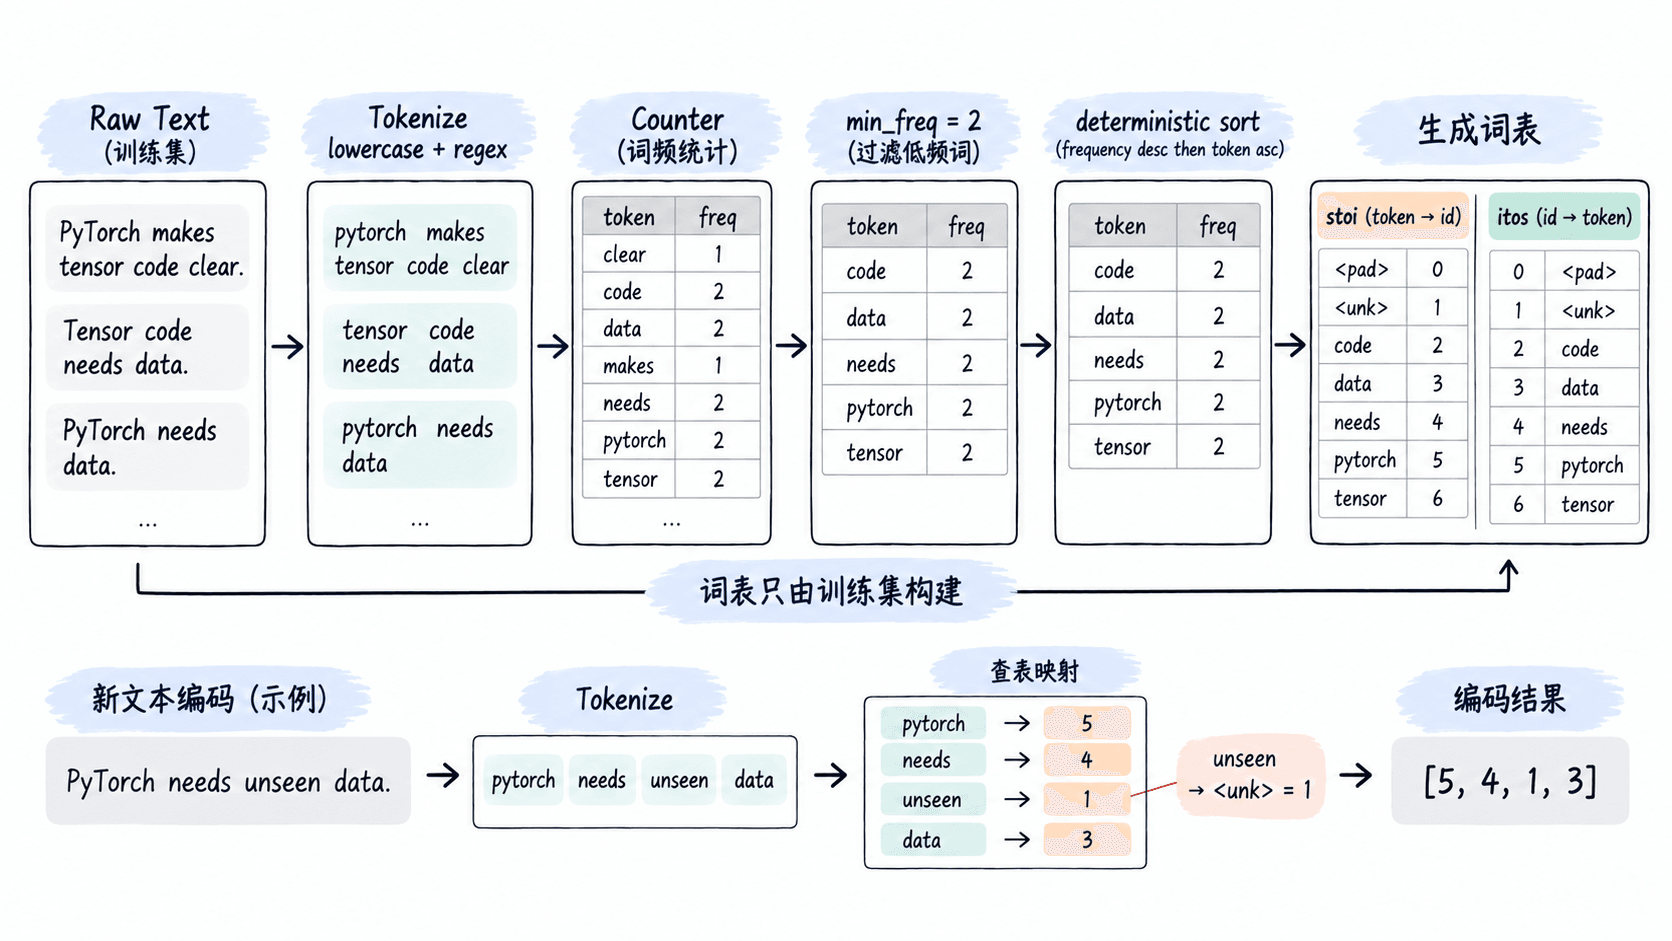
这条流水线的关键不是“把词放进字典”本身,而是让过滤条件、排序规则和特殊词元位置都可复现。否则重新训练或部署时,只要索引顺序变化,同一个整数就可能指向另一个词,已有模型参数会立刻失去意义。
特殊词元要先占固定索引
常见做法是把 <pad> 固定为 0、<unk> 固定为 1。批处理时可直接用 0 补齐短序列;编码遇到词表外词元时则回退到 1。只有模型确实需要句首、句尾或掩码任务时,才额外加入 <bos>、<eos>、<mask>,不要无条件增加特殊词元。
min_freq 要和数据规模一起定。只有几十句的小数据集若设成 5,可能丢掉大量有意义词;百万句语料设成 1 又可能让拼写错误占据巨大词表。上面的三句演示用 2 是为了清楚显示过滤效果,真实项目应先查看词频分布再决定阈值。
冻结词表后再编码验证集和测试集
词表一旦由训练集生成,就应冻结映射。验证集、测试集和线上新文本只能查询现有 stoi,找不到的词统一映射到 <unk>,不能临时追加新索引。以示例中的 unseen 为例,它在训练语料中不存在,因此编码结果明确落到索引 1。
保存模型时,应把词表内容、分词规则和关键参数一起保存,例如记录 min_freq=2、特殊词元顺序以及完整 itos 列表。加载模型后先检查 <pad> 和 <unk> 的索引是否仍为 0、1,再做一条固定文本的编码回归测试;只要索引序列变化,就应停止推理并检查词表版本。