
机器学习与深度学习 / 系统课时
封装可复用训练器
封装可复用训练器
当训练脚本同时承担训练、验证、保存检查点和打印日志时,代码很快会被重复逻辑淹没。这里把这些职责收进一个 Trainer,但仍把模型、优化器、损失函数和数据加载器作为外部依赖注入,最终得到可以复用、可以验证、也方便扩展的训练组件。
学习目标
- 划清训练器与模型、数据之间的职责边界。
- 封装训练、验证、最佳检查点保存和日志输出的统一流程。
- 通过固定入口和检查点内容验证训练器是否真正可复用。
划清训练器的职责
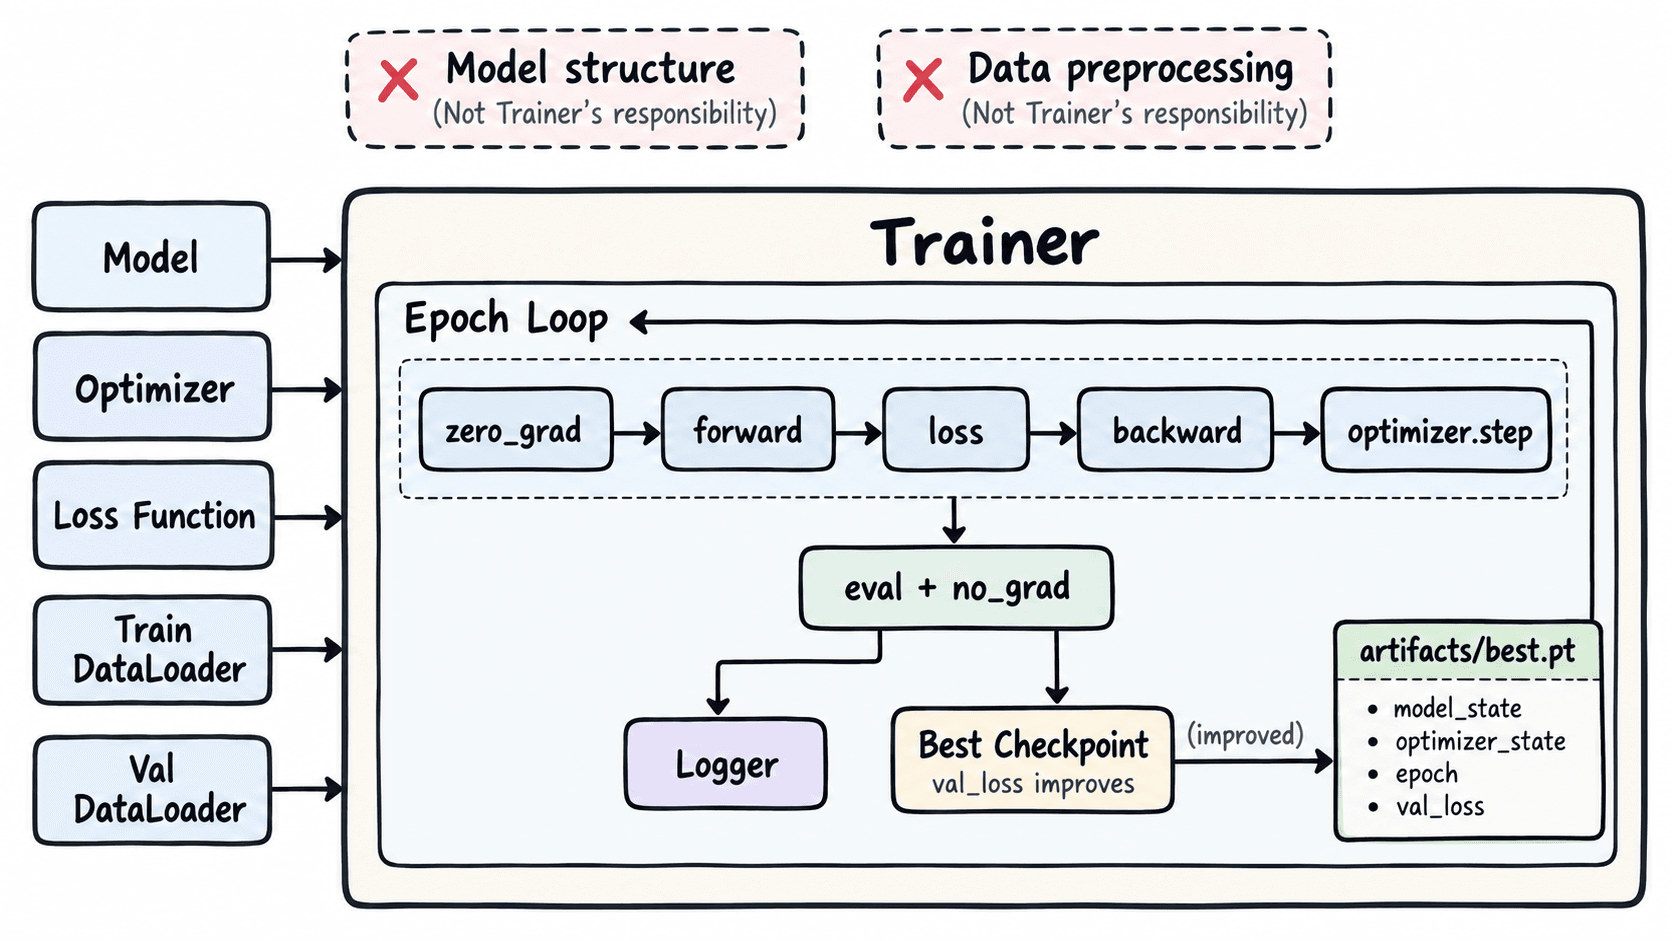
训练器应该管理“怎么跑一轮”,而不是决定“任务是什么”。一个够用的接口通常只接收 model、optimizer、loss_fn、device 和日志函数;训练集、验证集在 fit() 时传入。这样分类、回归或不同网络结构都能复用相同流程。
| 责任 | 放在 Trainer 中 | 保留在外部 |
|---|---|---|
model.train() / model.eval() 切换 |
是 | 否 |
| 梯度清零、反向传播、参数更新 | 是 | 否 |
验证阶段 torch.no_grad() |
是 | 否 |
| 最佳检查点保存 | 是 | 否 |
网络层结构与 forward() |
否 | 是 |
数据预处理与 Dataset 定义 |
否 | 是 |
| 任务特有指标 | 建议注入 | 是 |
实现统一的 Trainer
下面示例使用线性回归数据,但 Trainer 本身并不知道任务含义。run_epoch() 通过 training 参数控制训练或验证,验证阶段使用 torch.no_grad();fit() 负责日志与“验证损失最低时保存”策略。
from pathlib import Path

import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

class Trainer:
    def __init__(self, model, optimizer, loss_fn, device="cpu", log_fn=print):
        self.model = model.to(device)
        self.optimizer = optimizer
        self.loss_fn = loss_fn
        self.device = torch.device(device)
        self.log_fn = log_fn
        self.best_path = Path("artifacts/best.pt")
        self.best_path.parent.mkdir(parents=True, exist_ok=True)

    def run_epoch(self, loader, training):
        self.model.train(training)
        total_loss = 0.0
        total_items = 0

        context = torch.enable_grad() if training else torch.no_grad()
        with context:
            for x, y in loader:
                x = x.to(self.device)
                y = y.to(self.device)

                if training:
                    self.optimizer.zero_grad(set_to_none=True)

                pred = self.model(x)
                loss = self.loss_fn(pred, y)

                if training:
                    loss.backward()
                    self.optimizer.step()

                batch_size = x.size(0)
                total_loss += loss.item() * batch_size
                total_items += batch_size

        return total_loss / total_items

    def fit(self, train_loader, val_loader, epochs):
        best_val_loss = float("inf")
        history = []

        for epoch in range(1, epochs + 1):
            train_loss = self.run_epoch(train_loader, training=True)
            val_loss = self.run_epoch(val_loader, training=False)
            lr = self.optimizer.param_groups[0]["lr"]

            row = {
                "epoch": epoch,
                "train_loss": train_loss,
                "val_loss": val_loss,
                "lr": lr,
            }
            history.append(row)
            self.log_fn(
                f"epoch={epoch} train_loss={train_loss:.4f} "
                f"val_loss={val_loss:.4f} lr={lr:.4f}"
            )

            if val_loss < best_val_loss:
                best_val_loss = val_loss
                torch.save(
                    {
                        "epoch": epoch,
                        "model_state": self.model.state_dict(),
                        "optimizer_state": self.optimizer.state_dict(),
                        "val_loss": val_loss,
                    },
                    self.best_path,
                )

        return history

torch.manual_seed(7)

train_x = torch.tensor([[0.0], [1.0], [2.0], [3.0]])
train_y = 3 * train_x + 1
val_x = torch.tensor([[4.0], [5.0]])
val_y = 3 * val_x + 1

train_loader = DataLoader(
    TensorDataset(train_x, train_y), batch_size=2, shuffle=False
)
val_loader = DataLoader(
    TensorDataset(val_x, val_y), batch_size=2, shuffle=False
)

model = nn.Linear(1, 1)
optimizer = torch.optim.SGD(model.parameters(), lr=0.05)
trainer = Trainer(model, optimizer, nn.MSELoss())

history = trainer.fit(train_loader, val_loader, epochs=3)
checkpoint = torch.load(
    trainer.best_path, map_location="cpu", weights_only=True
)

print(f"history_len={len(history)}")
print(f"checkpoint_exists={trainer.best_path.exists()}")
print(f"checkpoint_keys={sorted(checkpoint.keys())}")
预期输出中的损失值依赖 PyTorch 版本和浮点计算细节,因此用占位符表示;轮次数、学习率和检查点结构应与下列结果一致。
epoch=1 train_loss=<TRAIN_LOSS> val_loss=<VAL_LOSS> lr=0.0500
epoch=2 train_loss=<TRAIN_LOSS> val_loss=<VAL_LOSS> lr=0.0500
epoch=3 train_loss=<TRAIN_LOSS> val_loss=<VAL_LOSS> lr=0.0500
history_len=3
checkpoint_exists=True
checkpoint_keys=['epoch', 'model_state', 'optimizer_state', 'val_loss']
让保存逻辑支持真正恢复
只保存 model.state_dict() 适合纯推理;如果要中断后继续训练,还需要保存 optimizer_state、当前 epoch,使用学习率调度器时还应加入 scheduler_state。上例保存的四个字段已经足够恢复模型和 SGD 动量等优化器内部状态。
恢复时应先用相同结构创建模型与优化器,再调用 load_state_dict()。不要直接把整个 Trainer 对象序列化成黑盒文件,因为代码路径、类定义和环境变化后更难兼容。检查点文件也应按验证指标保存“最佳”版本,而不是只保留最后一个 epoch。
给扩展点留接口而不是继续堆条件
当任务需要准确率、F1 或自定义回调时,优先注入 metric_fn、callbacks 或 log_fn,不要在 Trainer 内不断增加 if task == ...。例如日志已经通过 log_fn 注入,既可以传 print,也可以替换成写 JSONL、TensorBoard 或实验追踪平台的函数。
一个可复用训练器至少应通过三项检查:同一 Trainer 能换不同 nn.Module;验证阶段不会执行参数更新;最佳检查点包含恢复训练所需状态。满足这三点后,再加入混合精度、梯度裁剪或分布式训练,复杂度才不会反过来污染基础训练流程。