
机器学习与深度学习 / 系统课时
冻结基础网络参数
冻结基础网络参数
迁移学习的数据量较小时,先固定预训练主干、只训练新分类头,通常能更快得到稳定基线。这里继续使用 ResNet-18,把主干参数设为不计算梯度,只让 5 类分类头参与反向传播,并检查优化器中确实只有任务层参数。
学习目标
- 用
requires_grad=False冻结预训练主干参数。 - 只把新分类头参数交给优化器更新。
- 区分“冻结梯度”和
train()、eval()对运行状态的影响。
先冻结,再创建新分类头
一个稳妥顺序是先冻结当前模型全部参数,再替换分类头。新创建的 nn.Linear 参数默认 requires_grad=True,因此最终只有 fc.weight 与 fc.bias 可训练。5 分类时参数量为 512×5+5=2565。
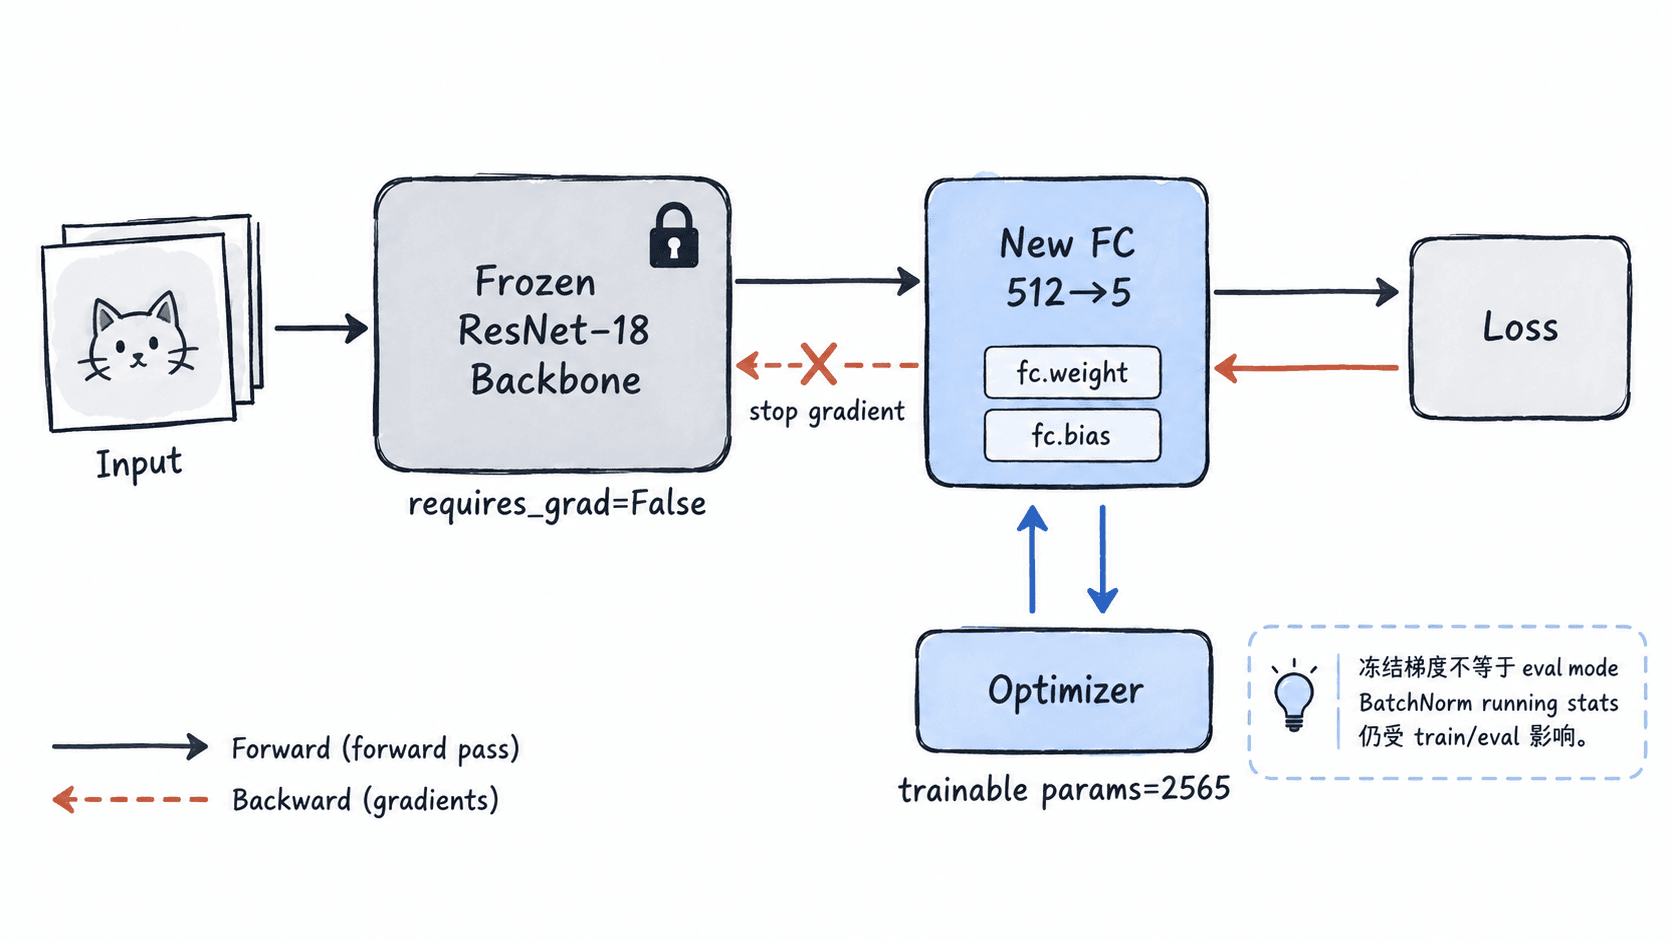
下面的示例不仅打印可训练参数,还执行一次反向传播,直接确认主干没有梯度而分类头有梯度。
import torch
from torch import nn
from torchvision.models import ResNet18_Weights, resnet18

def main():
    model = resnet18(weights=ResNet18_Weights.DEFAULT)

    for param in model.parameters():
        param.requires_grad = False

    in_features = model.fc.in_features
    model.fc = nn.Linear(in_features, 5)

    optimizer = torch.optim.AdamW(
        (p for p in model.parameters() if p.requires_grad),
        lr=1e-3,
        weight_decay=1e-4,
    )

    x = torch.randn(2, 3, 224, 224)
    target = torch.tensor([0, 4])

    model.train()
    optimizer.zero_grad()
    logits = model(x)
    loss = nn.CrossEntropyLoss()(logits, target)
    loss.backward()

    base_weight = model.layer1[0].conv1.weight
    trainable = [name for name, p in model.named_parameters() if p.requires_grad]

    print("trainable:", trainable)
    print("trainable params:", sum(p.numel() for p in model.parameters() if p.requires_grad))
    print("base grad is None:", base_weight.grad is None)
    print("head grad exists:", model.fc.weight.grad is not None)

if __name__ == "__main__":
    main()
预期输出
trainable: ['fc.weight', 'fc.bias']
trainable params: 2565
base grad is None: True
head grad exists: True
让优化器只接收可训练参数
上例把 p.requires_grad 为真的参数过滤后交给 AdamW。这样即使模型里仍保存着大量冻结参数,优化器也不会为它们创建更新状态。对于新分类头,lr=1e-3 是常见起点;若后续解冻部分主干,主干学习率通常应更小,例如 1e-4。
不要只依赖“冻结后优化器不会更新”这一印象。训练开始前打印可训练参数名和数量更可靠;对本例而言,若输出中出现 layer1、layer2 等主干名称,就说明冻结范围不符合“仅训练分类头”的目标。
冻结梯度不等于切换评估模式
requires_grad=False 只控制参数是否记录梯度,并不会自动把 BatchNorm 或 Dropout 切到评估行为。若调用 model.train(),ResNet 主干中的 BatchNorm 仍会更新 running_mean 和 running_var,即使它的可学习参数已经被冻结。
如果当前阶段希望把主干当作完全固定的特征提取器,可在每轮训练开始时执行 model.eval(),再执行 model.fc.train()。ResNet-18 的分类头只有线性层,因此这里主要是为了固定主干中的 BatchNorm 状态。若模型头部包含 Dropout,则必须确保任务头处于训练模式。
什么时候开始解冻主干
只训练分类头适合先建立基线,尤其是新数据集较小或与预训练数据相似时。若分类头损失已经停滞、验证集指标仍明显不足,可以再解冻靠近输出端的一部分主干,并把学习率降到例如 1e-4。
解冻后要重新构建或更新优化器,使新增的可训练参数真正进入参数组。验收时仍使用同样的三项检查:可训练参数名符合预期、冻结层梯度为 None、优化器只管理计划更新的参数。