
机器学习与深度学习 / 系统课时
理解动态计算图
理解动态计算图
PyTorch 会在前向计算实际发生时记录参与求导的张量运算,而不是先固定一张静态图。理解这一点后,你就能解释条件分支、循环为什么可以直接参与训练,也能判断一次 backward() 之后哪些图状态会被释放。
学习目标
- 说清动态计算图在前向阶段如何按实际执行路径建立。
- 使用
grad_fn、is_leaf和backward()验证图中的依赖关系。 - 理解分支变化、重复反向传播与图释放之间的边界。
图是在前向计算时建立的
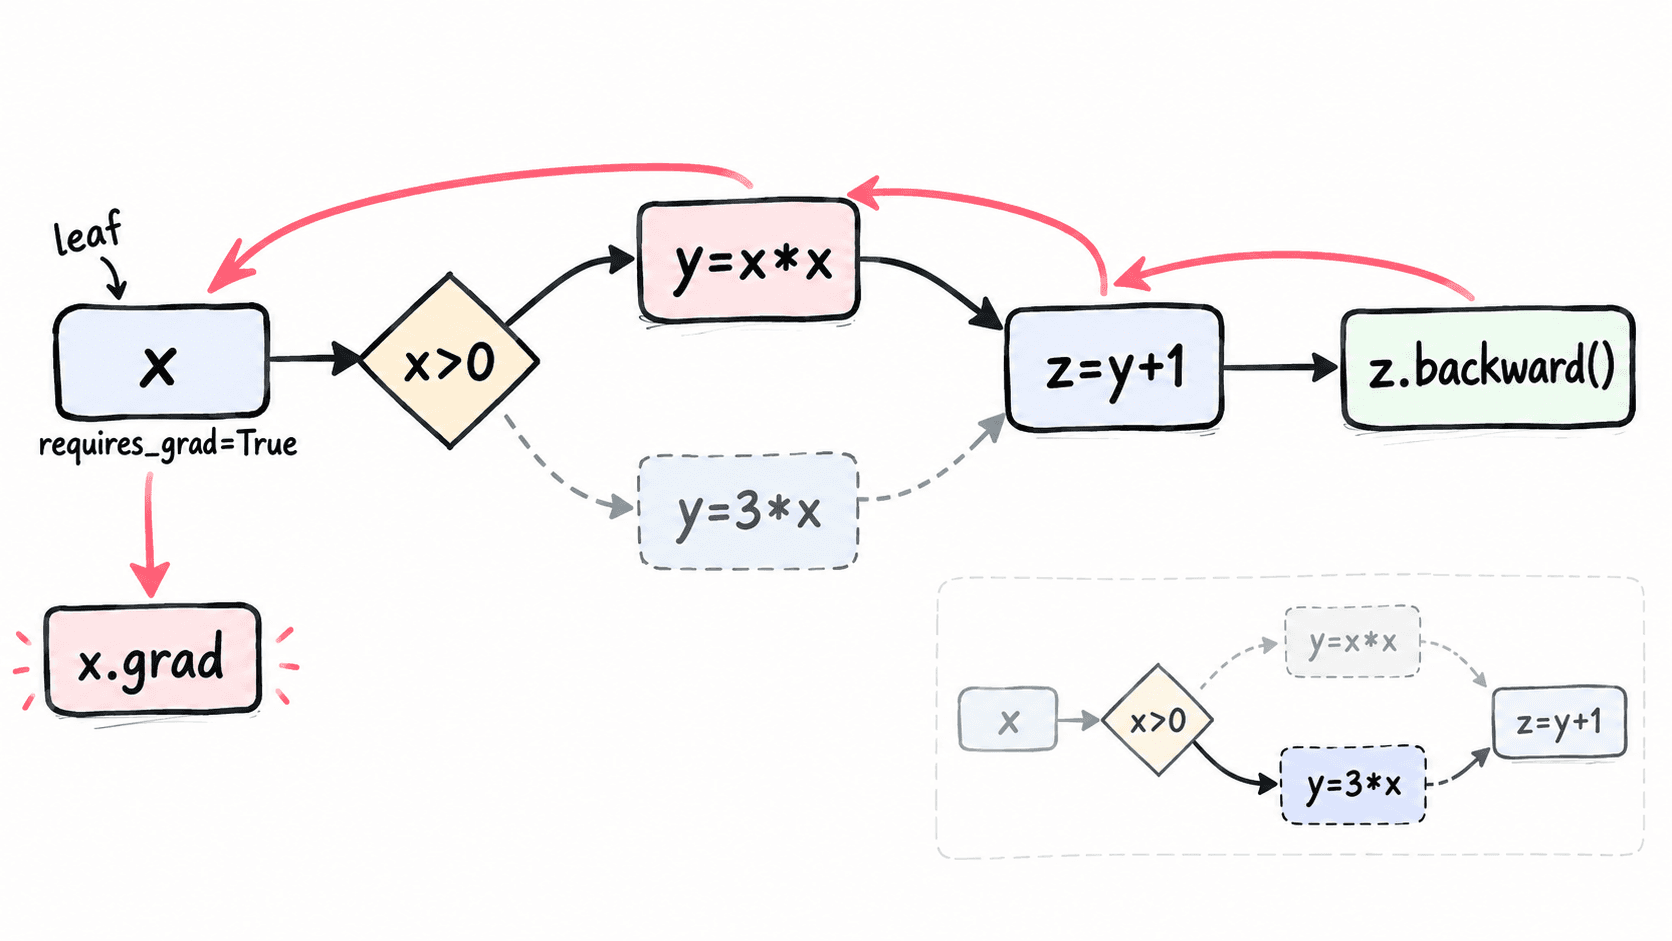
只要运算涉及 requires_grad=True 的张量,并且当前没有关闭梯度模式,PyTorch autograd 就会为相关结果记录求导所需的信息。叶子张量通常是模型参数或手工创建的可训练张量;由运算得到的中间结果属于非叶子张量,并通过 grad_fn 指向对应的反向计算节点。
下面这段程序对正数和负数走不同分支。两次调用执行的是同一个 Python 函数,但实际记录下来的运算路径不同。
import torch

def run(value: float) -> None:
    x = torch.tensor(value, requires_grad=True)

    # Python 分支会直接决定这一次前向计算记录哪些运算。
    if x.item() > 0:
        y = x * x
        branch = "square"
    else:
        y = 3 * x
        branch = "triple"

    z = y + 1
    z.backward()

    print(
        f"value={value:.1f}, branch={branch}, "
        f"z={z.item():.1f}, grad={x.grad.item():.1f}, "
        f"has_grad_fn={z.grad_fn is not None}"
    )

run(2.0)
run(-2.0)
预期输出:
value=2.0, branch=square, z=5.0, grad=4.0, has_grad_fn=True
value=-2.0, branch=triple, z=-5.0, grad=3.0, has_grad_fn=True
第一个分支中 z=x*x+1,所以在 x=2 时梯度为 4;第二个分支中 z=3*x+1,所以梯度恒为 3。输出中的 has_grad_fn=True 说明 z 不是独立叶子,而是由已记录运算生成的结果。
backward 会沿本次图反向求导
调用 z.backward() 时,autograd 从标量输出 z 沿依赖关系反向应用链式法则,并把叶子张量的梯度累加到 .grad。因此训练循环里通常要在下一次反向传播前执行 optimizer.zero_grad() 或把相关 .grad 清空,否则多次反向传播得到的梯度会继续相加。
一次普通的 backward() 结束后,反向传播需要的中间缓存通常会被释放。若对同一个前向结果再次调用 backward(),会遇到“trying to backward through the graph a second time”一类错误。确实需要在同一张图上再次反向传播时可以传入 retain_graph=True,但它会额外占用内存,不应作为训练循环的默认设置。
动态不等于没有图
“动态图”指图在 Python 程序运行过程中按本次执行路径即时建立,而不是 autograd 不保存依赖关系。条件分支、不同长度循环和可变形状输入都可以改变下一次前向传播的图;但当前这一次反向传播仍严格沿已经执行并记录的运算链路进行。
判断代码是否真正进入求导图,可以先看三个点:待训练叶子张量的 requires_grad 应为 True,中间结果通常有非空 grad_fn,执行 backward() 后叶子张量的 .grad 应得到与手算一致的值。上面的正负两个输入分别得到 4 和 3,就是最直接的验证。