
机器学习与深度学习 / 系统课时
优化模型效果
优化模型效果
优化阶段要回答的不是“还能加什么技巧”,而是哪一项改动在同一验证协议下真正带来收益。下面把迁移学习、正则化和学习率调节拆成可追踪实验,再给出一套两阶段 ResNet-18 微调脚本,最终只用验证集选方案。
学习目标
- 用受控实验比较迁移学习、解冻范围和正则化带来的增益。
- 正确设置预训练 ResNet-18 的分类头、分组学习率与学习率调度器。
- 根据训练/验证曲线判断欠拟合、过拟合和学习率过高等问题。
用实验矩阵控制变量
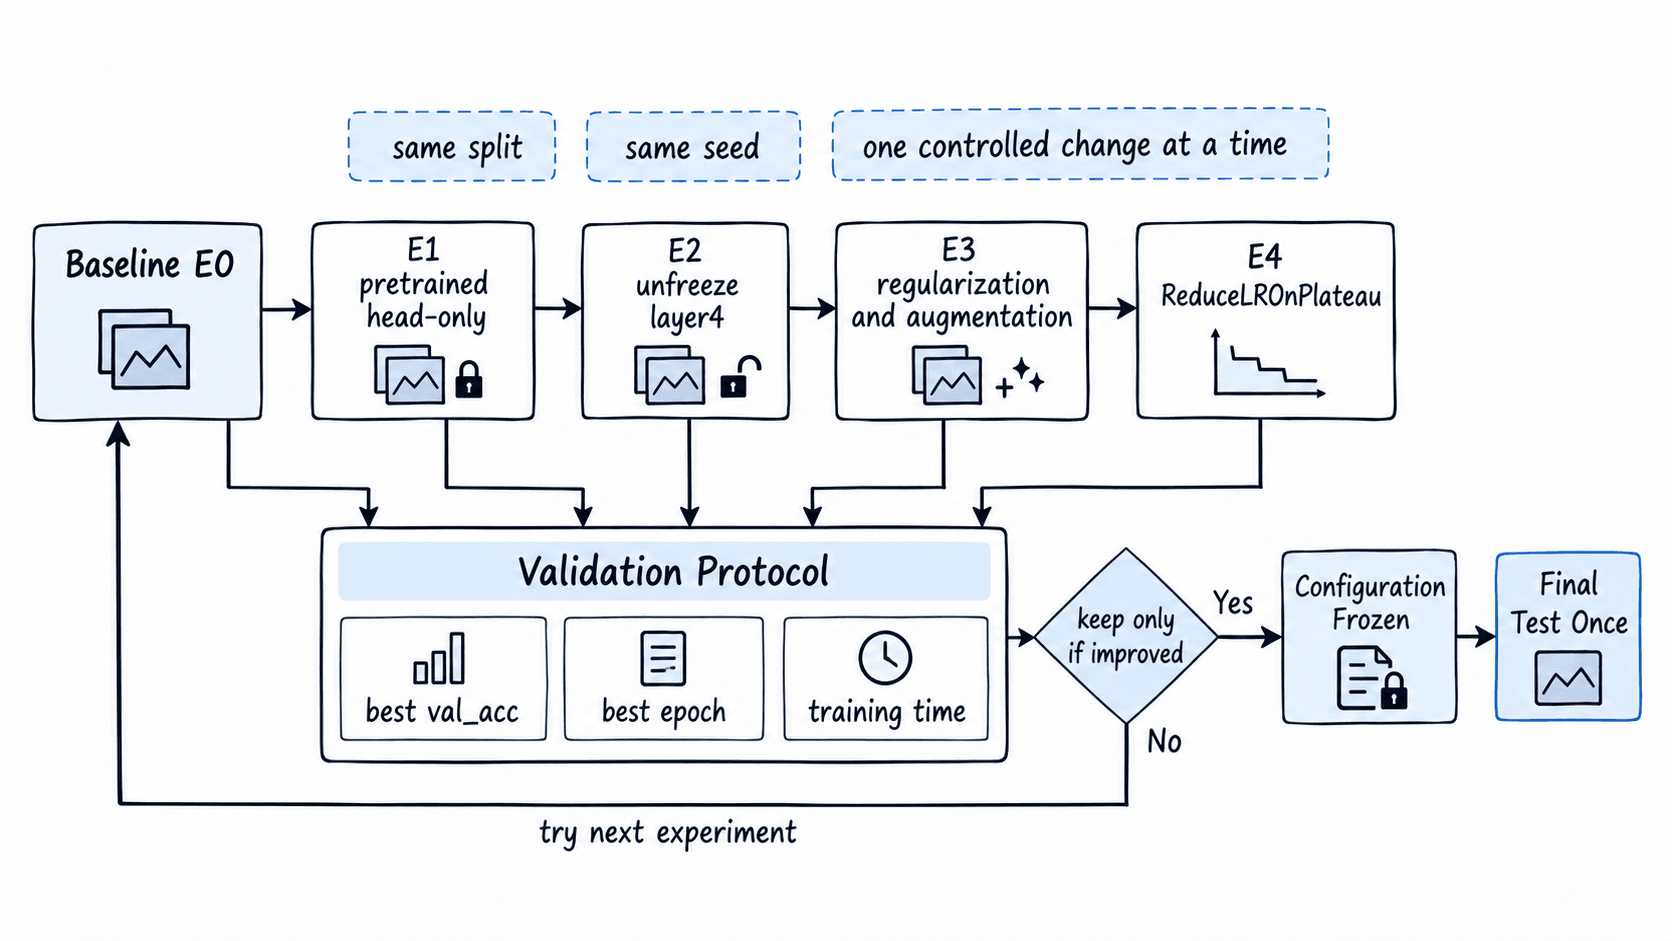
不要一次同时改模型、增强、学习率和损失后只比较一个最终数字。把当前项目的固定训练协议记为 E0;如果还没有基线,可先用一个不含预训练的简单 CNN 得到 E0。随后固定数据划分与 seed,按累计实验逐步加入改动,并把每次最佳 val_acc、最佳 epoch 和训练时长写入同一张记录表。
| 实验 | 相对上一实验的改动 | 关键参数 |
|---|---|---|
| E0 | 项目基线 | 小型 CNN,Adam(lr=1e-3) |
| E1 | 换成预训练 ResNet-18,只训练分类头 | head lr=1e-3,5 epoch |
| E2 | 解冻 layer4 |
layer4 lr=1e-5,head lr=1e-4,10 epoch |
| E3 | 加正则化与训练增强 | label_smoothing=0.1,weight_decay=1e-4 |
| E4 | 验证集停滞时降学习率 | factor=0.2,patience=2 |
如果 E2 比 E1 低,就不要因为“解冻更多通常更强”而继续扩大解冻范围;先回到 E1,检查学习率是否过大或训练数据是否太少。
实现两阶段迁移学习
下面脚本使用 torchvision 的 ResNet18_Weights.DEFAULT。第一阶段冻结主干、只训练新分类头;第二阶段解冻 layer4,给主干更小学习率。训练增强使用随机裁剪和水平翻转,验证集使用预训练权重自带的确定性预处理。 这份脚本直接给出 E4 的候选配方;若要严格复现 E1/E2,应令训练预处理与 weights.transforms() 一致,并把 label_smoothing 与 weight_decay 设为 0,确认收益后再逐项加入 E3/E4。
import argparse
import random
from pathlib import Path

import torch
from torch import nn
from torch.utils.data import DataLoader
from torchvision import datasets, transforms
from torchvision.models import ResNet18_Weights, resnet18

def run_epoch(model, loader, criterion, device, optimizer=None):
    training = optimizer is not None
    model.train(training)
    if training:
        # 参数被冻结的 BatchNorm 同时冻结运行统计量,避免主干悄悄漂移。
        for module in model.modules():
            if isinstance(module, nn.BatchNorm2d):
                if not any(p.requires_grad for p in module.parameters()):
                    module.eval()
    correct, total = 0, 0

    for images, targets in loader:
        images, targets = images.to(device), targets.to(device)
        with torch.set_grad_enabled(training):
            logits = model(images)
            loss = criterion(logits, targets)
            if training:
                optimizer.zero_grad(set_to_none=True)
                loss.backward()
                optimizer.step()

        correct += (logits.argmax(1) == targets).sum().item()
        total += images.size(0)

    return correct / total

def fit_phase(
    name, model, train_loader, val_loader, criterion, device,
    optimizer, epochs, best, scheduler=None
):
    for epoch in range(1, epochs + 1):
        run_epoch(model, train_loader, criterion, device, optimizer)
        val_acc = run_epoch(model, val_loader, criterion, device)

        if val_acc > best:
            best = val_acc
            torch.save(
                {
                    "model_state": model.state_dict(),
                    "classes": train_loader.dataset.classes,
                    "val_acc": best,
                },
                "best_transfer.pt",
            )

        if scheduler is not None:
            scheduler.step(val_acc)

        lrs = ",".join(f"{g['lr']:.1e}" for g in optimizer.param_groups)
        print(
            f"phase={name} epoch={epoch:02d} "
            f"val_acc={val_acc:.4f} lrs={lrs}"
        )
    return best

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--data", type=Path, default=Path("data"))
    parser.add_argument("--seed", type=int, default=42)
    args = parser.parse_args()

    random.seed(args.seed)
    torch.manual_seed(args.seed)
    if torch.cuda.is_available():
        torch.cuda.manual_seed_all(args.seed)
    torch.backends.cudnn.benchmark = False
    torch.backends.cudnn.deterministic = True

    weights = ResNet18_Weights.DEFAULT
    train_tf = transforms.Compose([
        transforms.RandomResizedCrop(224, scale=(0.8, 1.0)),
        transforms.RandomHorizontalFlip(p=0.5),
        transforms.ToTensor(),
        transforms.Normalize(
            mean=(0.485, 0.456, 0.406),
            std=(0.229, 0.224, 0.225),
        ),
    ])
    val_tf = weights.transforms()

    train_ds = datasets.ImageFolder(args.data / "train", transform=train_tf)
    val_ds = datasets.ImageFolder(args.data / "val", transform=val_tf)
    if train_ds.classes != val_ds.classes:
        raise ValueError("train/val class folders must match")

    train_loader = DataLoader(
        train_ds, batch_size=32, shuffle=True, num_workers=0
    )
    val_loader = DataLoader(
        val_ds, batch_size=32, shuffle=False, num_workers=0
    )

    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
    model = resnet18(weights=weights)
    for p in model.parameters():
        p.requires_grad = False
    model.fc = nn.Linear(model.fc.in_features, len(train_ds.classes))
    model = model.to(device)

    criterion = nn.CrossEntropyLoss(label_smoothing=0.1)

    head_optimizer = torch.optim.AdamW(
        model.fc.parameters(), lr=1e-3, weight_decay=1e-4
    )
    best = fit_phase(
        "head", model, train_loader, val_loader, criterion,
        device, head_optimizer, epochs=5, best=-1.0
    )

    for p in model.layer4.parameters():
        p.requires_grad = True

    finetune_optimizer = torch.optim.AdamW(
        [
            {"params": model.layer4.parameters(), "lr": 1e-5},
            {"params": model.fc.parameters(), "lr": 1e-4},
        ],
        weight_decay=1e-4,
    )
    scheduler = torch.optim.lr_scheduler.ReduceLROnPlateau(
        finetune_optimizer,
        mode="max",
        factor=0.2,
        patience=2,
        min_lr=1e-7,
    )
    best = fit_phase(
        "finetune", model, train_loader, val_loader, criterion,
        device, finetune_optimizer, epochs=10, best=best,
        scheduler=scheduler
    )

    print(f"best_val_acc={best:.4f} checkpoint=best_transfer.pt")

if __name__ == "__main__":
    main()
预期结果:首次运行可能下载 ResNet-18 预训练权重;之后先训练分类头 5 个 epoch,再微调 layer4 与分类头 10 个 epoch,并把最高验证准确率对应的参数保存到 best_transfer.pt。
执行:
python optimize_model.py --data data --seed 42预期输出结构如下,<ACC> 为实际验证准确率。若连续多个 epoch 未刷新最佳值,ReduceLROnPlateau 会把当前学习率乘以 0.2。
phase=head epoch=01 val_acc=<ACC> lrs=1.0e-03
...
phase=finetune epoch=01 val_acc=<ACC> lrs=1.0e-05,1.0e-04
...
best_val_acc=<ACC> checkpoint=best_transfer.pt
给超参数设置搜索边界
先在小范围内搜索,不要把一次训练变成无上限试错。对中小型图像分类项目,可以从下面的离散候选开始,并保持其他条件不变。
| 参数 | 建议候选 | 观察信号 |
|---|---|---|
| head 学习率 | 3e-4、1e-3 |
头部是否在 3~5 epoch 内收敛 |
layer4 学习率 |
1e-5、3e-5、1e-4 |
验证指标是否震荡或退化 |
weight_decay |
0、1e-4、1e-3 |
训练/验证差距是否缩小 |
label_smoothing |
0、0.05、0.1 |
验证准确率和置信度是否改善 |
| 随机裁剪 scale | (0.8, 1.0) 或 (0.7, 1.0) |
主体是否被过度裁掉 |
RandomHorizontalFlip(p=0.5) 只适用于左右翻转不改变标签语义的图像。若类别依赖文字方向、左右结构或设备接口朝向,应关闭该增强,否则它会制造错误标签。
根据曲线决定下一步
出现“训练准确率继续上升、验证准确率停滞”时,优先尝试更强的 weight decay、label smoothing 或停止扩大解冻范围;如果训练与验证都低,说明更像欠拟合,应尝试解冻更多层或适度提高微调学习率。若验证准确率在相邻 epoch 间波动超过 3 个百分点,先降低学习率并用 3 个种子复跑,不要只挑最高的一次。
所有方案都只能用验证集选型。配置冻结后,再加载 best_transfer.pt 对 data/test 做一次最终评估;测试结果不再用于回头改超参数。这样得到的提升才是相对项目基线可解释、可复现的提升,而不是对测试集反复试出来的数字。