
机器学习与深度学习 / 系统课时
执行模型微调
执行模型微调
完成迁移学习的头部训练后,可以只解冻预训练网络靠后的层,用更小学习率继续更新特征。这里以 torchvision 的 ResNet18 为例,演示如何选择解冻范围、执行一次真实反向传播,并避免冻结层的 BatchNorm 统计量被意外改写。
学习目标
- 能冻结早期特征层,只解冻
layer4与新建的fc分类头。 - 能用较小学习率执行微调,并验证哪些参数会参与优化。
- 能正确处理训练阶段与验证阶段的 BatchNorm 模式。
选择解冻范围
对只有几千张图片的小型三分类任务,可以先保留通用低层特征,只微调最后一个残差阶段。下面这组起始配置便于控制过拟合:conv1、bn1、layer1~layer3 冻结,layer4 与 fc 解冻,微调学习率先用 1e-4。
| 模块 | 状态 | 作用 |
|---|---|---|
conv1~layer3 |
冻结 | 保留预训练边缘、纹理与中层特征 |
layer4 |
解冻 | 让高层语义适配新数据集 |
fc |
解冻 | 学习新的 3 类决策边界 |
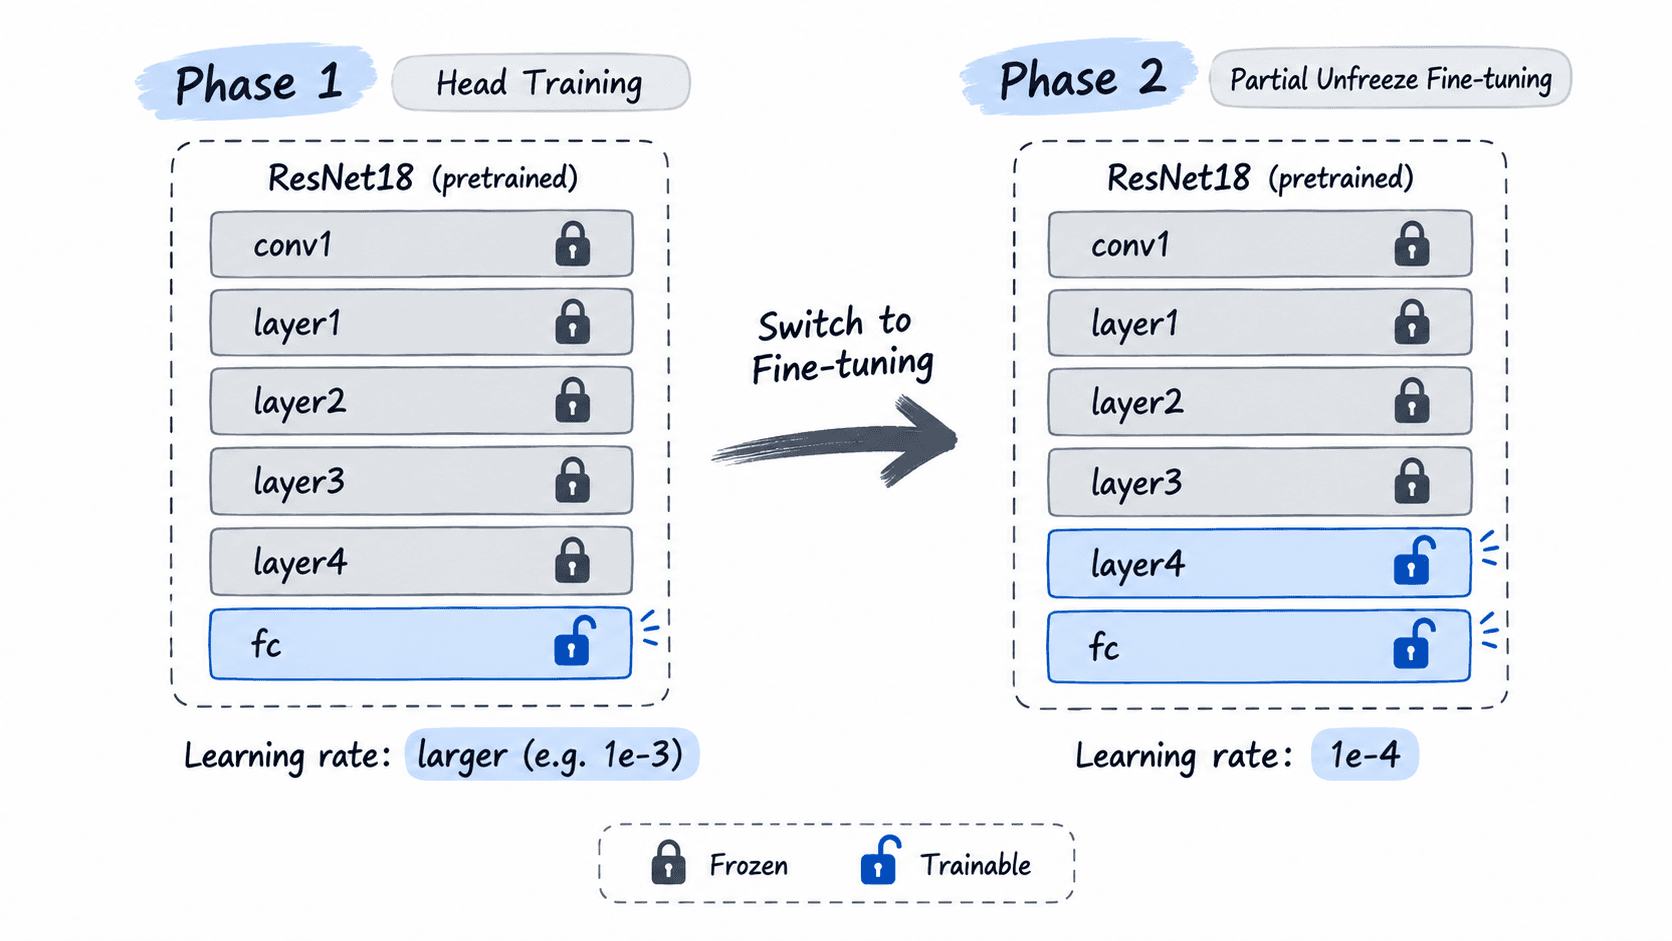
如果验证集与预训练数据差异更大,可以继续向前解冻 layer3;如果样本很少,先不要一次解冻整个骨干网络,否则参数量骤增后更容易过拟合。
运行一次微调步骤
下面代码使用 torchvision 0.13+ 的 weights= 枚举接口。首次运行若权重不在本机缓存,会下载 ResNet18 预训练权重;程序只优化 layer4 与 fc,并用随机输入完成一次前向、反向与参数更新。
import torch
from torch import nn
from torchvision.models import ResNet18_Weights, resnet18

def set_finetune_mode(model):
    # 冻结区域保持 eval,避免其 BatchNorm 运行统计量继续变化。
    model.eval()
    model.layer4.train()
    model.fc.train()

def main():
    torch.manual_seed(7)
    model = resnet18(weights=ResNet18_Weights.DEFAULT)
    model.fc = nn.Linear(model.fc.in_features, 3)

    # 先冻结全部参数,再只解冻最后一个残差阶段和分类头。
    for parameter in model.parameters():
        parameter.requires_grad = False
    for parameter in model.layer4.parameters():
        parameter.requires_grad = True
    for parameter in model.fc.parameters():
        parameter.requires_grad = True

    optimizer = torch.optim.AdamW(
        (p for p in model.parameters() if p.requires_grad),
        lr=1e-4,
        weight_decay=1e-4,
    )
    criterion = nn.CrossEntropyLoss()
    set_finetune_mode(model)

    images = torch.randn(2, 3, 224, 224)
    labels = torch.tensor([0, 2])

    optimizer.zero_grad(set_to_none=True)
    logits = model(images)
    loss = criterion(logits, labels)
    loss.backward()
    optimizer.step()

    print("conv1 trainable:", next(model.conv1.parameters()).requires_grad)
    print("layer4 trainable:", next(model.layer4.parameters()).requires_grad)
    print("fc trainable:", next(model.fc.parameters()).requires_grad)
    print("logits shape:", tuple(logits.shape))
    print("fine-tuning step completed")

if __name__ == "__main__":
    main()
预期输出
conv1 trainable: False
layer4 trainable: True
fc trainable: True
logits shape: (2, 3)
fine-tuning step completed
真实数据训练时,把随机 images 与 labels 换成 DataLoader 产出的 batch 即可;每个 epoch 开始都应重新设置微调模式,验证前则调用 model.eval()。
处理 BatchNorm 与验证模式
requires_grad=False 只阻止参数计算梯度,并不会自动把模块切到推理模式。若直接执行 model.train(),已冻结区域里的 BatchNorm 仍会更新 running_mean 和 running_var,小数据集上可能让预训练统计量漂移。
本例先执行 model.eval(),再只对 layer4 调用 train(),因此 layer4 内的 BatchNorm 会随新数据更新,而更早的冻结层保持固定。验证时统一调用 model.eval(),并在 torch.no_grad() 上下文中计算指标;检查时可以记录一次冻结层的 running_mean,训练一个 epoch 后确认它没有变化。
判断是否继续解冻
可以把“是否继续向前解冻”绑定到验证集指标,而不是固定训练很多轮。一个可执行的项目规则是:先微调 layer4 + fc 3~5 个 epoch;若验证准确率连续 3 个 epoch 提升不足 0.2 个百分点,同时训练准确率仍明显上升,则优先停止或加强正则,而不是继续解冻。
如果验证准确率仍稳定上升且训练集不过拟合,再解冻 layer3,把学习率继续控制在 1e-5~1e-4 量级。每扩大一次解冻范围,都重新观察验证损失、准确率和训练集与验证集之间的差距,确认新增可训练参数确实带来收益。