
机器学习与深度学习 / 系统课时
处理变长序列
处理变长序列
文本批次中的句子长度通常不同。直接补零虽然能凑成矩形张量,但循环网络仍可能在补零位置做无效计算。本课用 PyTorch 的填充、布尔掩码与 PackedSequence 组成一条完整处理链,并验证打包后只计算真实时间步。
学习目标
- 用
pad_sequence把不同长度的 token 序列整理成批量张量,并保存真实长度。 - 用布尔掩码区分真实 token 与 padding,避免统计或损失函数把补零算进去。
- 用
pack_padded_sequence与pad_packed_sequence让 LSTM 跳过补齐位置并恢复批量输出。
先填充并保存真实长度
假设一个批次有 3 条序列,长度分别为 4、2、3。右侧填充到最大长度 4 后,token 张量形状是 (3, 4);对应掩码中,真实位置为 True,padding 为 False。真实长度必须与每条样本一起保留,因为仅看填充值无法可靠推断长度:token ID 0 只有在你的词表明确把它保留给 padding 时才有特殊含义。
对 RNN 文本分类,常见处理链是“原始变长 token → padding + lengths → Embedding → PackedSequence → LSTM/GRU → 最终状态或解包输出”。掩码则用于损失、池化或注意力等仍在矩形张量上工作的步骤。
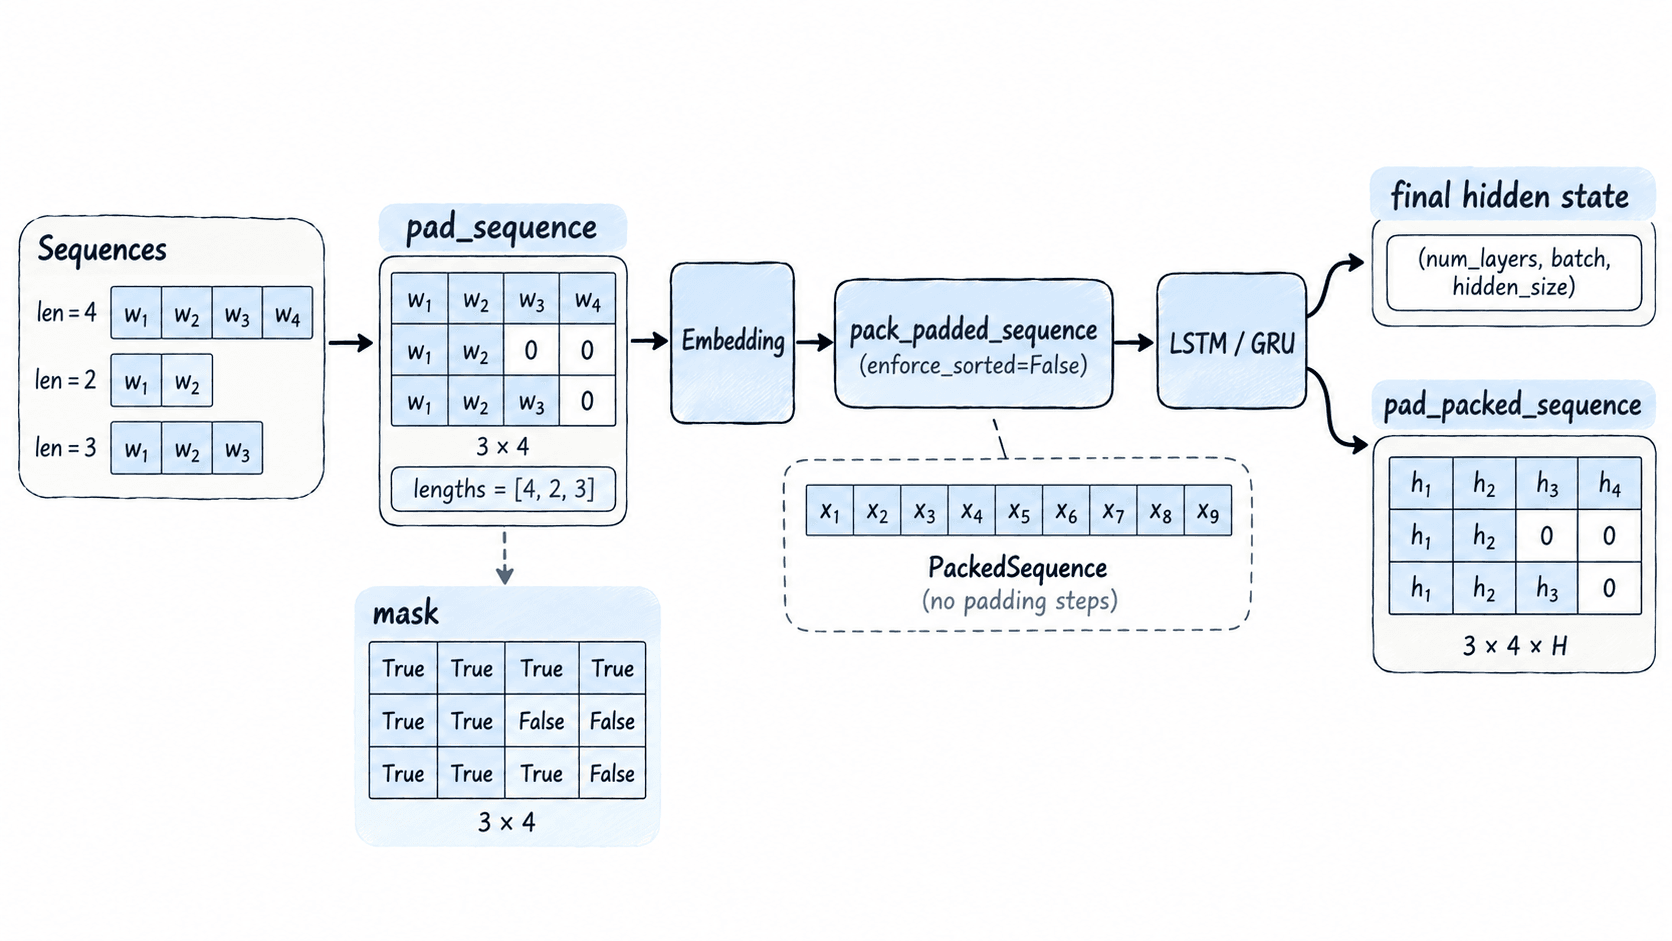
若词表约定 padding_idx=0,可以给 nn.Embedding 同样设置 padding_idx=0,这样 padding 行不会通过普通 Embedding 反向传播更新。但这并不会自动阻止 LSTM 在补零时间步继续计算,减少这部分计算仍需打包序列。
用 PackedSequence 跳过补齐位置
pack_padded_sequence 接收补齐后的张量与真实长度。下面的示例不预先按长度排序,因此设置 enforce_sorted=False;PyTorch 会在打包时处理排序信息,并在 pad_packed_sequence 时恢复原批次顺序。若 lengths 以 Tensor 传入,调用打包函数时应让它位于 CPU。
import torch
from torch import nn
from torch.nn.utils.rnn import (
    pad_sequence,
    pack_padded_sequence,
    pad_packed_sequence,
)

torch.manual_seed(0)

tokens = [
    torch.tensor([4, 8, 2, 9]),
    torch.tensor([3, 7]),
    torch.tensor([5, 1, 6]),
]
lengths = torch.tensor([len(x) for x in tokens])

padded = pad_sequence(tokens, batch_first=True, padding_value=0)
mask = torch.arange(padded.size(1)).unsqueeze(0) < lengths.unsqueeze(1)

embedding = nn.Embedding(num_embeddings=10, embedding_dim=5, padding_idx=0)
lstm = nn.LSTM(input_size=5, hidden_size=4, batch_first=True)

embedded = embedding(padded)
packed = pack_padded_sequence(
    embedded,
    lengths.cpu(),
    batch_first=True,
    enforce_sorted=False,
)
packed_out, (h_n, c_n) = lstm(packed)

unpacked, out_lengths = pad_packed_sequence(
    packed_out,
    batch_first=True,
    total_length=padded.size(1),
)

print(padded)
print(mask)
print("batch_sizes:", packed.batch_sizes.tolist())
print("unpacked:", tuple(unpacked.shape))
print("lengths:", out_lengths.tolist())
print("final:", tuple(h_n.shape))
预期输出:
tensor([[4, 8, 2, 9],
        [3, 7, 0, 0],
        [5, 1, 6, 0]])
tensor([[ True,  True,  True,  True],
        [ True,  True, False, False],
        [ True,  True,  True, False]])
batch_sizes: [3, 3, 2, 1]
unpacked: (3, 4, 4)
lengths: [4, 2, 3]
final: (1, 3, 4)
batch_sizes=[3,3,2,1] 表示第 1、2 个时间步仍有 3 条有效序列,第 3 个时间步只剩 2 条,第 4 个时间步只剩 1 条。LSTM 因而不需要在两个末尾 padding 上继续执行循环计算。
掩码与打包解决不同问题
打包用于 RNN/GRU/LSTM 的递归计算;掩码用于仍以矩形张量表示的数据。比如做 token 级交叉熵时,可以给 padding 标签设置 ignore_index;做平均池化时,应只把 mask=True 的时间步计入分子和分母。只使用 padding 而没有 mask,最常见的错误是把补零位置也平均进去,使短句表示被系统性压小。
如果只需要每条序列的最终表示,可以直接使用打包后 RNN 返回的 h_n,通常无需再 pad_packed_sequence。只有需要每个真实时间步的输出,例如序列标注或时间步级注意力时,才把 packed_out 解包回 (N, L, H)。
处理排序与固定长度边界
训练时通常使用 enforce_sorted=False,这样数据加载器不必为了 RNN 额外重排样本。若工作流要求已经按长度降序排列,可以使用默认的 enforce_sorted=True;涉及 ONNX 导出时也应按目标导出链的要求保持可预测的排序。
pad_packed_sequence 的 total_length 可以强制恢复到固定时间维。例如批内最长长度是 4,而后续模块统一要求长度 8,可设置 total_length=8;若 total_length 小于打包序列的最长真实长度,PyTorch 会报错。工程中应在进入打包前检查所有长度都大于 0,并保证 max(lengths) 不超过补齐张量的时间维,避免真实序列被静默截短。