
机器学习与深度学习 / 系统课时
理解模型开发流程
理解模型开发流程
一个 PyTorch 模型从“能训练”到“能交付”至少要经过数据准备、模型构建、训练、评估、保存和部署六个环节。把每一步的输入、输出和验收条件固定下来,可以避免训练集泄漏、只看 loss 不看泛化效果,以及模型保存后无法复现推理等常见问题。
学习目标
- 说清数据、模型、训练、评估、保存和部署之间的依赖关系。
- 跑通一条包含训练、验证、测试、保存和重新加载的最小 PyTorch 流水线。
- 为每个阶段设置可检查的产物与放行条件。
从数据到部署设置六个检查点
开发流程不是“写模型然后训练”这一条直线。评估不通过时,通常要退回数据、模型或训练阶段;部署验证失败时,则要检查保存格式、输入预处理和推理环境是否与训练时一致。
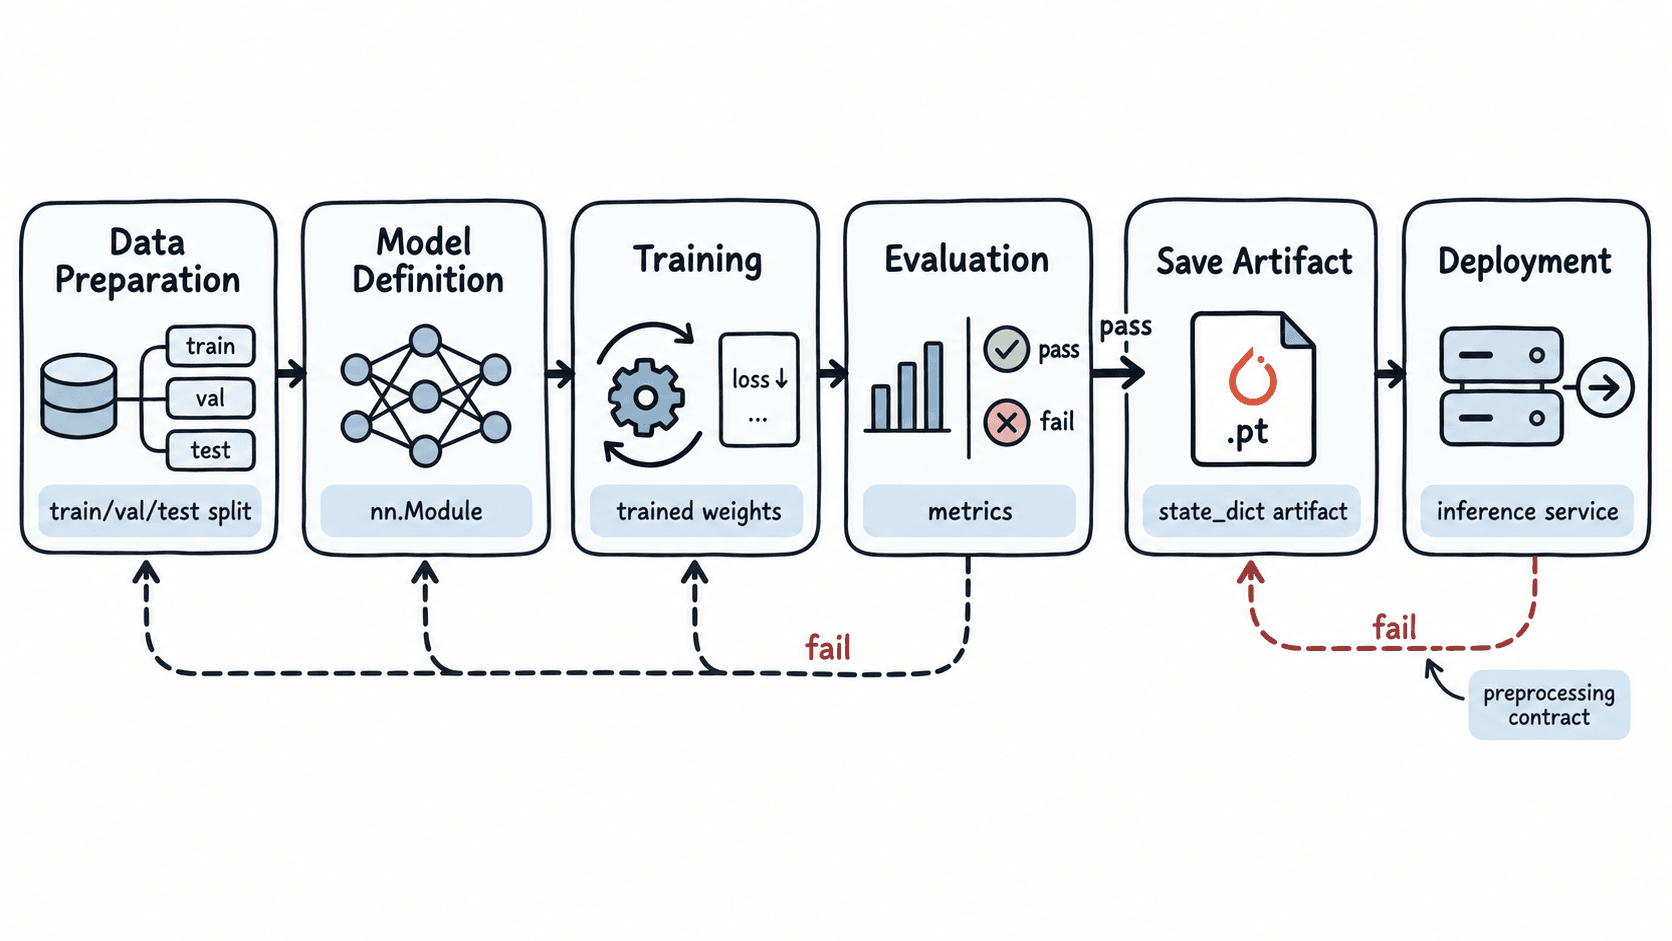
可以把每一阶段的最小验收条件定成下面这样:
| 阶段 | 主要产物 | 可执行的验收条件 |
|---|---|---|
| 数据准备 | train/val/test 三份数据 | 例如按 70%/15%/15% 切分,测试集在最终评估前不参与调参 |
| 模型构建 | nn.Module |
给定一批输入后,输出形状和任务类别数一致 |
| 训练 | 更新后的参数 | loss 能反向传播,参数梯度不是全部为 None |
| 评估 | validation/test 指标 | 先用 validation 选方案,最后只用一次冻结的 test 集做报告 |
| 保存 | 权重与运行元数据 | 新进程可重新加载,输出与保存前一致 |
| 部署 | 推理入口 | 输入 dtype、shape、预处理与训练约定一致,并通过至少一条冒烟请求 |
跑通最小端到端流水线
下面示例按 PyTorch 2.x API 编写。它生成一个二维二分类数据集,按 70%/15%/15% 划分,训练一个小型 MLP,验证指标通过后保存 state_dict,再用新模型实例重新加载并检查推理结果是否一致。
from pathlib import Path

import torch
from torch import nn

# 固定随机种子,让数据划分和初始化可复现。
torch.manual_seed(7)

# 构造一个可快速训练的二维二分类数据集。
x = torch.linspace(-1.0, 1.0, steps=200).unsqueeze(1)
features = torch.cat([x, x**2], dim=1)
labels = (x[:, 0] > 0).long()

# 先打乱,再按 70%/15%/15% 划分。
perm = torch.randperm(len(features))
features, labels = features[perm], labels[perm]
x_train, y_train = features[:140], labels[:140]
x_val, y_val = features[140:170], labels[140:170]
x_test, y_test = features[170:], labels[170:]

def build_model():
    return nn.Sequential(
        nn.Linear(2, 8),
        nn.ReLU(),
        nn.Linear(8, 2),
    )

def accuracy(model, x_data, y_data):
    model.eval()
    with torch.no_grad():
        pred = model(x_data).argmax(dim=1)
    return (pred == y_data).float().mean().item()

# 训练阶段只更新训练集上的参数。
model = build_model()
loss_fn = nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(model.parameters(), lr=0.03)

for _ in range(120):
    model.train()
    logits = model(x_train)
    loss = loss_fn(logits, y_train)
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()

# 验证集用于放行判断;测试集用于最终报告。
val_acc = accuracy(model, x_val, y_val)
test_acc = accuracy(model, x_test, y_test)

# 保存权重,而不是把整个 Python 模型对象序列化。
artifact = Path("artifacts/model.pt")
artifact.parent.mkdir(parents=True, exist_ok=True)
torch.save(model.state_dict(), artifact)

# 用全新模型实例加载权重,模拟独立推理进程。
loaded = build_model()
state = torch.load(artifact, map_location="cpu", weights_only=True)
loaded.load_state_dict(state)
loaded.eval()

with torch.no_grad():
    reload_same = torch.equal(model(x_test), loaded(x_test))

print("val_ok:", val_acc >= 0.95)
print("test_ok:", test_acc >= 0.95)
print("saved:", artifact.exists())
print("reload_same:", reload_same)
预期输出:
val_ok: True
test_ok: True
saved: True
reload_same: True这个例子故意把数据、模型、训练、评估和保存放在同一个文件里,目的是验证流程闭环;进入真实项目后应再把这些职责拆到独立模块。weights_only=True 用于只加载权重类对象,保存 state_dict 也比直接序列化整个模型对象更容易跨代码重构维护。
用验证集决定方案,用测试集做最终报告
一个常用的分类项目可以先固定数据比例和放行门槛,例如训练集 70%、验证集 15%、测试集 15%,验证准确率要求至少 95%。如果验证集只有 82%,应继续调整数据、模型或训练过程,而不是先查看测试集寻找“更好看的数字”。
真实交付还要同时固定推理契约。以本例为准,输入应是 float32、形状为 [N, 2],输出 logits 形状为 [N, 2]。如果线上收到 [N, 3] 或字符串字段,即使权重文件能成功加载,也不代表模型可以正确服务。
保存产物至少要能回答三件事:使用哪版代码、需要什么输入预处理、权重文件在哪里。小项目可以把代码提交哈希、PyTorch 版本、类别映射和预处理参数写入同一个发布清单;只保留一个 model.pt,几周后通常不足以可靠复现结果。
失败时退回正确阶段
排查时按“现象属于哪一层”决定回退位置,比盲目改学习率更有效:
- 训练指标和验证指标都低:先检查标签、特征和模型容量,再调整优化器或训练轮数。
- 训练接近 100%,验证明显偏低:优先检查过拟合、数据重复和切分方式,可增加正则化或重新划分数据。
- 离线评估正常,重新加载后结果变化:检查是否加载了对应权重、模型结构是否一致,以及推理前是否调用了
model.eval()。 - 本地推理正常,部署后 shape 或 dtype 报错:回到输入契约,核对线上预处理、批次维度和设备转换。
当六个阶段都有明确产物和验收条件时,模型开发就从一次性的训练脚本变成了可以定位问题、复现实验并交付推理的完整工程流程。