
机器学习与深度学习 / 系统课时
理解函数与导数
理解函数与导数
训练神经网络时,优化器需要知道参数往哪个方向调整才能让损失变小。导数描述单变量函数的瞬时变化率,偏导数把这个概念扩展到多变量函数,梯度则把所有偏导数组成一个方向向量。理解这三者,就能看懂反向传播最终交给优化器的数值代表什么。
学习目标
- 能用具体数值解释平均变化率与导数的区别
- 能计算简单多变量函数的偏导数与梯度
- 能说明梯度下降为什么使用参数减去梯度
从变化率得到导数
函数把输入映射为输出,例如 。从 变化到 时,函数值从 4 变为 9,这一段的平均变化率为 。它描述整个区间的平均斜率,而不是 这一点的瞬时斜率。
把输入变化量缩小到趋近于 0,就得到导数定义:
对 求导可得 ,所以 。这意味着当 在 2 附近增加一个很小的量,例如 0.01,函数值大约增加 。实际计算 ,与线性近似非常接近。
多变量函数需要偏导数
神经网络的损失通常同时依赖成千上万个参数,因此不能只对一个变量求导。以简单损失函数 为例,分别固定另一个变量,就能得到对 和 的偏导数:
当 、 时,,因此 ,。负号表示在当前位置增加对应参数会使损失下降。
实际检查偏导数时可以只改变一个变量。例如保持 ,把 从 1 增加到 1.01,损失从 4 下降到约 3.9204,变化方向确实与负偏导数一致。
梯度把所有方向合在一起
多个偏导数按参数顺序组成梯度。上例在 时的梯度为 。梯度指向函数值局部增长最快的方向,因此要降低损失,应沿梯度的反方向移动。
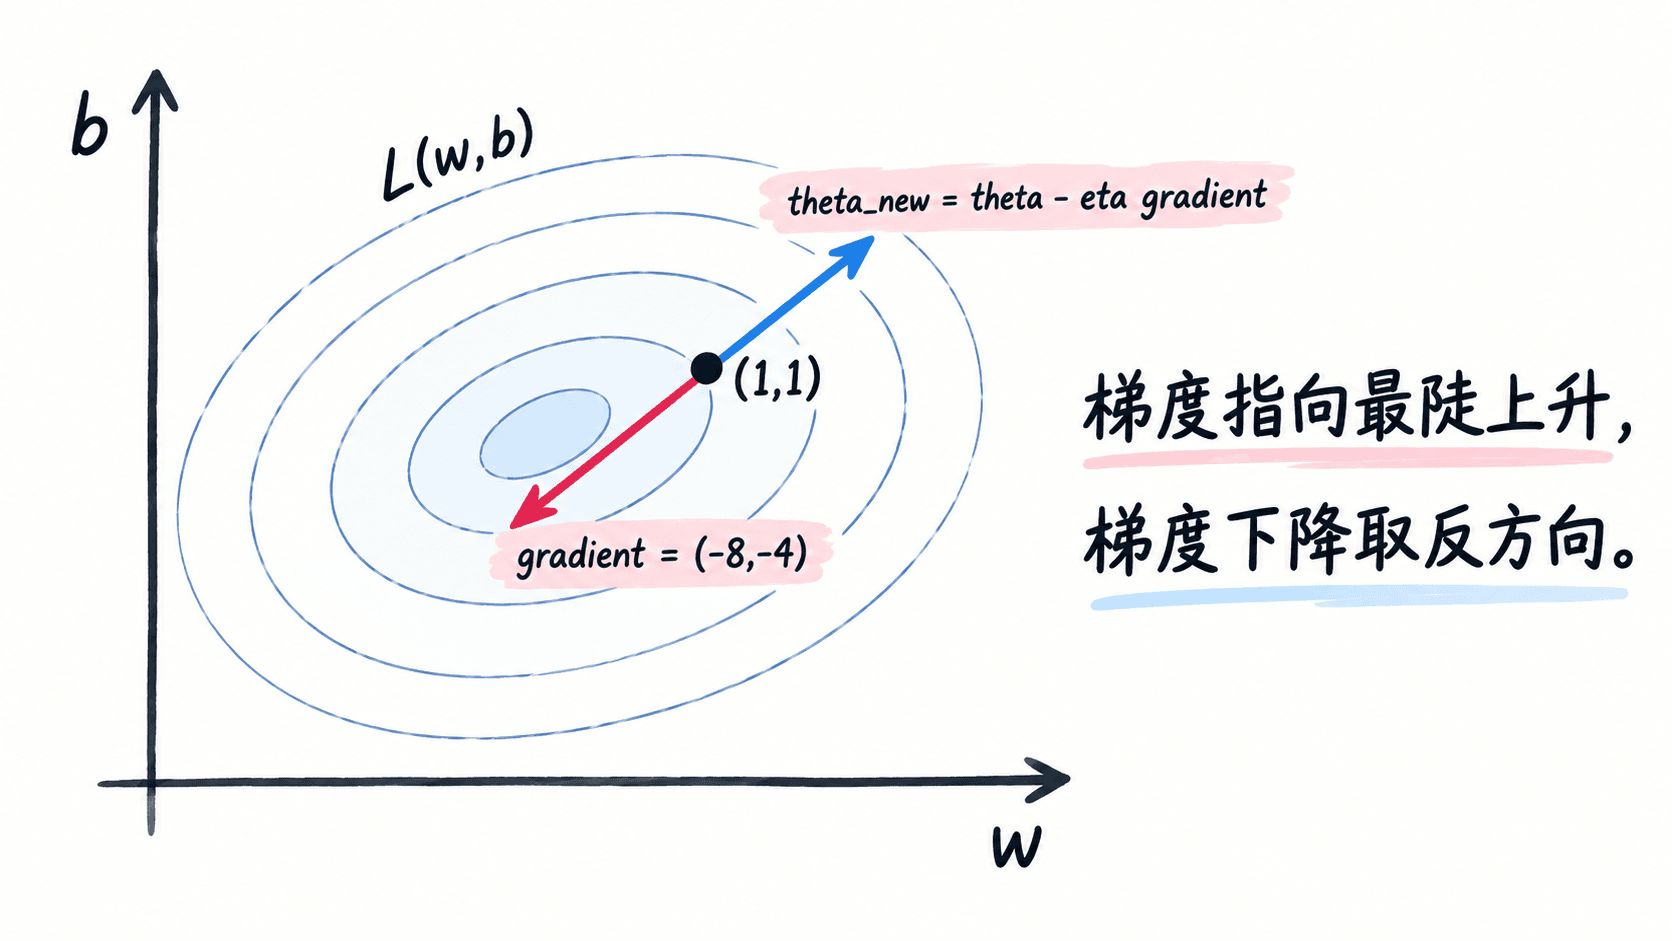
若学习率取 ,梯度下降更新规则为:
更新后 ,损失正好从 4 降到 0。实际神经网络的损失面远比这个例子复杂,一次更新通常不会直接到达最优点,但计算逻辑完全相同。
读懂训练中的梯度
训练时每个可学习参数都会得到一个与自身形状相同的梯度。若某个权重矩阵有 个参数,就会对应 8192 个偏导数;优化器根据这些数值同时更新全部元素。
检查梯度时可以记住三个直接可用的判断:梯度长期接近 0 时参数几乎不更新;梯度绝对值持续非常大时容易造成训练不稳定;损失下降方向使用的是 ,如果误写成加上梯度,就会朝损失上升方向移动。导数、偏导数和梯度并不是三套独立概念,而是从单变量变化率逐步扩展到神经网络多参数优化的同一套数学工具。