
机器学习与深度学习 / 系统课时
生成模型评估报告
生成模型评估报告
评估报告不是把一个 accuracy 数字贴上去,而是把冻结测试集上的整体指标、类别差异、混淆方向、典型错误和已知局限放进同一份可复核结果里。本课用一个可运行脚本生成结构化报告,并据此做发布判断。
学习目标
- 固定测试集、类别顺序和指标口径,避免评估结果被后续调参污染。
- 生成 accuracy、macro-F1、逐类指标、混淆矩阵和高置信错误样本。
- 用明确门槛写出可复核的模型局限与发布结论。
固定评估口径
正式评估前先冻结四项信息:模型版本、测试集版本、类别顺序和预处理版本。下面统一使用 frozen-test-v1、5 个类别 cat/dog/shoe/bag/bottle,并规定测试集只用于最终验收,不参与阈值选择、数据增强调整或超参数搜索。
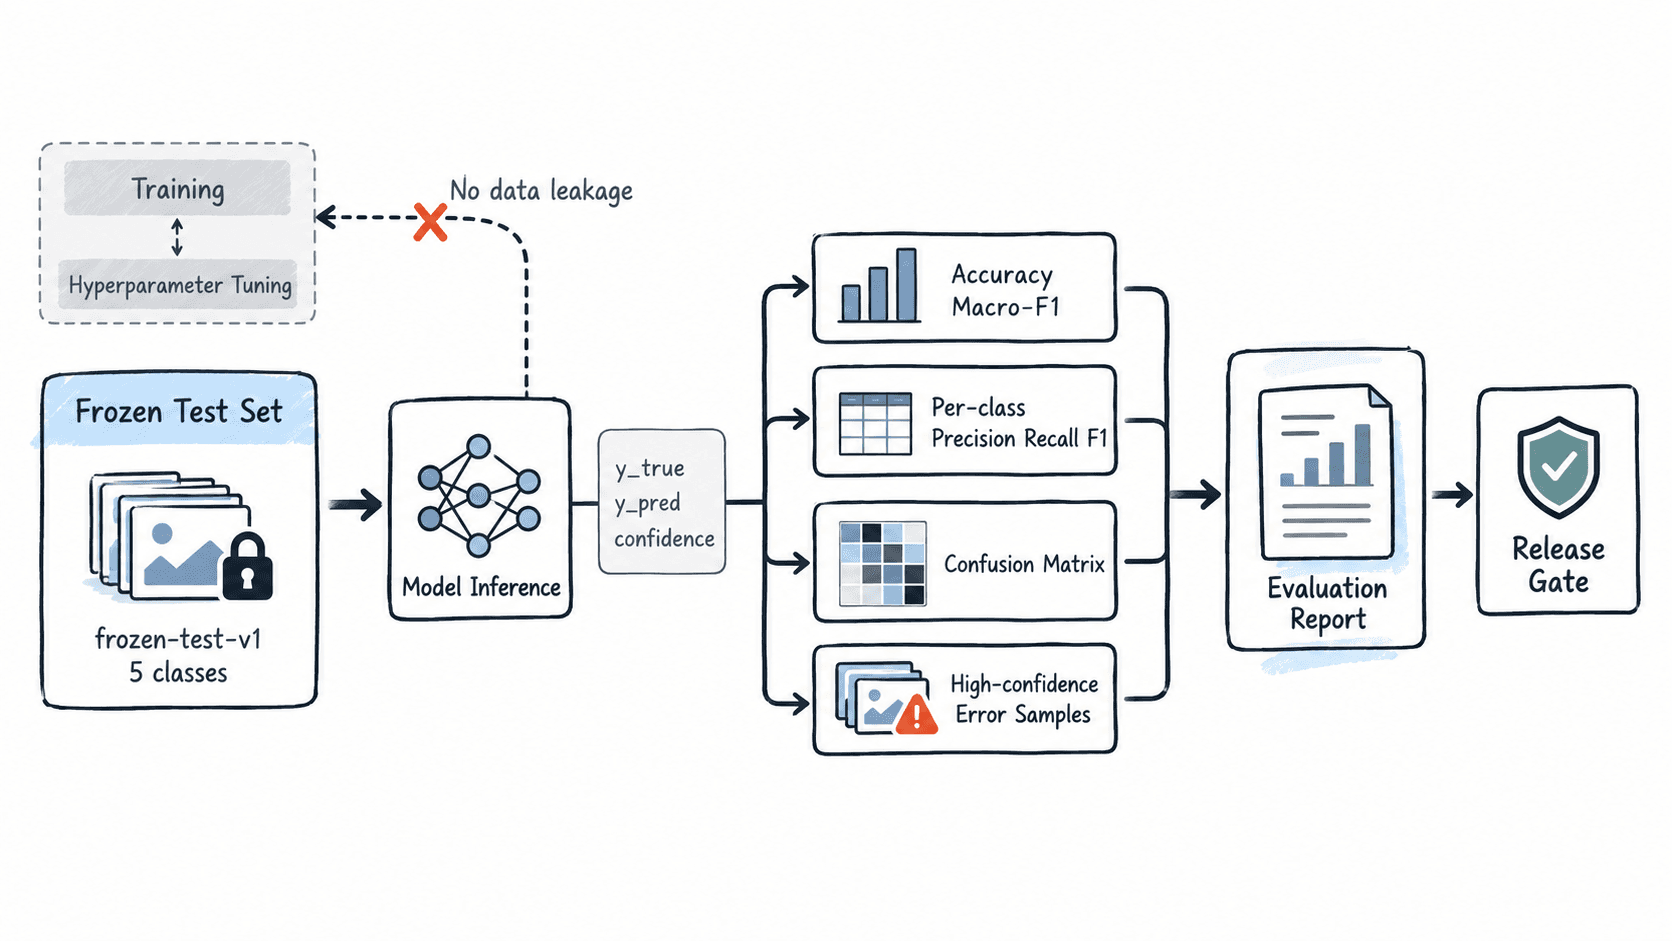
生成指标与错误样本
下面的脚本用 10 条固定样本演示完整报告结构。真实项目只需把 y_true、y_pred、confidence 和 sample_ids 换成测试集推理结果;依赖为 scikit-learn,输出写入 evaluation_report.json。
from pathlib import Path
import json

from sklearn.metrics import (
    accuracy_score,
    classification_report,
    confusion_matrix,
    f1_score,
)

CLASS_NAMES = ["cat", "dog", "shoe", "bag", "bottle"]
sample_ids = [f"img-{i:03d}" for i in range(1, 11)]
y_true = [0, 0, 1, 1, 2, 2, 3, 3, 4, 4]
y_pred = [0, 1, 1, 1, 2, 3, 3, 3, 4, 0]
confidence = [0.93, 0.62, 0.91, 0.88, 0.89, 0.71, 0.95, 0.86, 0.92, 0.58]

per_class_raw = classification_report(
    y_true,
    y_pred,
    labels=list(range(len(CLASS_NAMES))),
    target_names=CLASS_NAMES,
    output_dict=True,
    zero_division=0,
)
cm = confusion_matrix(
    y_true,
    y_pred,
    labels=list(range(len(CLASS_NAMES))),
).tolist()

# 高置信错误优先进入人工复核队列,比随机抽错例更容易发现系统性问题。
errors = []
for i, (true_id, pred_id) in enumerate(zip(y_true, y_pred)):
    if true_id != pred_id:
        errors.append(
            {
                "sample_id": sample_ids[i],
                "true": CLASS_NAMES[true_id],
                "pred": CLASS_NAMES[pred_id],
                "confidence": confidence[i],
            }
        )
errors.sort(key=lambda item: item["confidence"], reverse=True)

per_class = {}
for name in CLASS_NAMES:
    values = per_class_raw[name]
    per_class[name] = {
        "precision": round(values["precision"], 4),
        "recall": round(values["recall"], 4),
        "f1": round(values["f1-score"], 4),
        "support": int(values["support"]),
    }

report = {
    "model": {"name": "classifier-demo", "version": "1.0.0"},
    "test_set": {"name": "frozen-test-v1", "samples": len(y_true)},
    "preprocess_version": "image-preprocess-v3",
    "classes": CLASS_NAMES,
    "accuracy": round(accuracy_score(y_true, y_pred), 4),
    "macro_f1": round(f1_score(y_true, y_pred, average="macro"), 4),
    "per_class": per_class,
    "confusion_matrix": cm,
    "error_samples": errors[:3],
}
Path("evaluation_report.json").write_text(
    json.dumps(report, ensure_ascii=False, indent=2),
    encoding="utf-8",
)

print(f"accuracy={report['accuracy']:.4f}")
print(f"macro_f1={report['macro_f1']:.4f}")
print(f"errors={len(errors)}")
print(f"confusion_matrix={cm}")
print("wrote=evaluation_report.json")
预期输出:
accuracy=0.7000
macro_f1=0.6867
errors=3
confusion_matrix=[[1, 1, 0, 0, 0], [0, 2, 0, 0, 0], [0, 0, 1, 1, 0], [0, 0, 0, 2, 0], [1, 0, 0, 0, 1]]
wrote=evaluation_report.json
这份 JSON 已经包含模型版本、测试集版本、预处理版本、类别顺序、总体指标、逐类指标、混淆矩阵和错误样本。真实项目再补模型文件 SHA-256 与代码提交号,几周后才能准确重现同一次评估。
读混淆矩阵与错误样本
混淆矩阵约定“行是真实类别、列是预测类别”。本例的矩阵可以直接读成下面这张表;对角线是正确分类,非对角线就是具体错误流向。
| 真实类别 / 预测类别 | cat | dog | shoe | bag | bottle |
|---|---|---|---|---|---|
| cat | 1 | 1 | 0 | 0 | 0 |
| dog | 0 | 2 | 0 | 0 | 0 |
| shoe | 0 | 0 | 1 | 1 | 0 |
| bag | 0 | 0 | 0 | 2 | 0 |
| bottle | 1 | 0 | 0 | 0 | 1 |
这里有三条错误:cat→dog、shoe→bag、bottle→cat。其中 shoe→bag 的错误置信度为 0.71,是本例最值得先看的样本;高置信错误常对应标签问题、类别外观重叠或预处理偏差,而不是单纯“模型不够自信”。
写清模型局限与验收结论
把“好不好”改成可以执行的发布门槛。一个演示用门槛可以设为:测试样本不少于 500、accuracy 不低于 0.70、macro-F1 不低于 0.68、任一类别 recall 不低于 0.50。门槛应由业务风险决定,不是通用标准。
本例 accuracy=0.70、macro-F1=0.6867,5 类最低 recall=0.50,指标值刚好过线;但测试样本只有 10 条,未满足不少于 500 条的样本量要求,所以结论应写成 NO-GO:需要扩大冻结测试集后重新验收,而不是只报告“准确率 70%”。同时在局限项记录当前仅覆盖 5 类、尚未验证分布外样本和线上输入漂移。