
机器学习与深度学习 / 系统课时
使用 TensorBoard
使用 TensorBoard
训练时只看终端最后一行,很难判断损失是否震荡、不同实验谁更好,或参数是否逐渐饱和。本篇会把训练指标、参数分布与模型结构写入 TensorBoard 日志,并用浏览器面板完成一次可重复的训练诊断。
学习目标
- 使用
SummaryWriter记录 loss、MAE、参数直方图和模型结构。 - 启动 TensorBoard 并从
Scalars、Histograms、Graphs中检查训练状态。 - 用独立
log_dir管理多次实验,避免不同运行的数据混在一起。
准备 TensorBoard 依赖
PyTorch 通过 torch.utils.tensorboard.SummaryWriter 写事件文件,浏览器界面由 tensorboard 包提供。已有 PyTorch 环境时,只需安装 TensorBoard 并做一次导入检查。
python -m pip install tensorboard
python -c "from torch.utils.tensorboard import SummaryWriter; print('tensorboard writer ok')"
预期输出:
tensorboard writer ok日志默认可以写入 runs/;实际项目更适合显式指定目录,例如 runs/lr-0.01、runs/lr-0.001,这样 TensorBoard 能把多次实验作为不同 run 对比。
记录损失、指标、参数和模型结构
一次训练会经过“训练循环 → SummaryWriter → event 文件 → TensorBoard”这条数据链。标量适合画曲线,参数张量适合写直方图,add_graph 则记录一次模型计算结构。
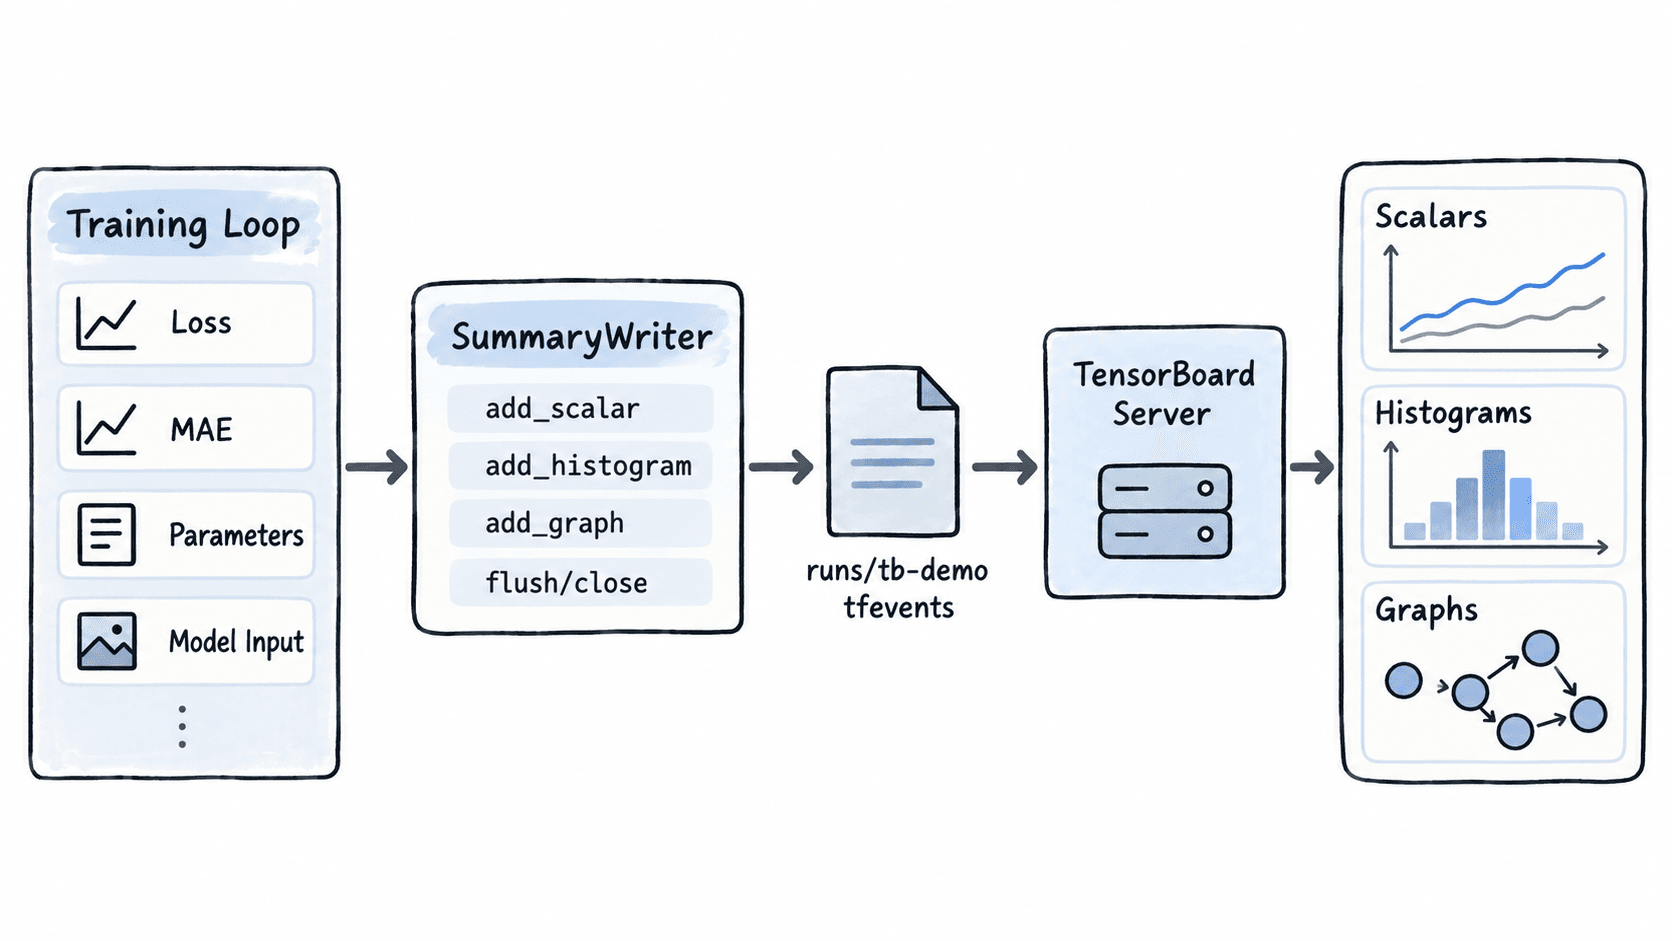
下面用一个一维回归模型生成 80 个训练 step。固定随机种子后,日志目录和输出文本可重复;数值曲线会显示在 TensorBoard 中。
import torch
from torch import nn
from torch.utils.tensorboard import SummaryWriter

torch.manual_seed(7)

x = torch.linspace(-1.0, 1.0, 128).unsqueeze(1)
y = 3.0 * x - 0.5 + 0.1 * torch.randn_like(x)

model = nn.Sequential(
    nn.Linear(1, 16),
    nn.ReLU(),
    nn.Linear(16, 1),
)
optimizer = torch.optim.SGD(model.parameters(), lr=0.1)
loss_fn = nn.MSELoss()
writer = SummaryWriter(log_dir="runs/tb-demo")

# 模型结构只需记录一次;输入形状必须能真实通过 forward。
writer.add_graph(model, x[:8])

for step in range(80):
    pred = model(x)
    loss = loss_fn(pred, y)

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()

    mae = (pred.detach() - y).abs().mean()
    writer.add_scalar("Loss/train", loss.item(), step)
    writer.add_scalar("Metrics/mae", mae.item(), step)

    # 每 10 步记录一次参数分布,避免每一步都写直方图造成日志膨胀。
    if step % 10 == 0:
        for name, param in model.named_parameters():
            writer.add_histogram(f"Parameters/{name}", param.detach(), step)

writer.flush()
writer.close()
print("TensorBoard logs written to runs/tb-demo")
预期输出:
TensorBoard logs written to runs/tb-demo执行后,runs/tb-demo 下应出现文件名含 tfevents 的事件文件。close() 会关闭 writer;需要训练中立即查看新数据时,可以像示例一样主动调用 flush()。
启动面板并检查四类信息
训练脚本结束后,在项目根目录启动 TensorBoard。--logdir runs 会递归发现各个 run,--port 6006 明确指定常用本地端口。
tensorboard --logdir runs --port 6006预期结果:进程持续运行,浏览器访问 http://localhost:6006/ 后可以看到 tb-demo 这次运行。若 6006 已被占用,把参数改为 --port 6007,并访问对应端口。
检查时不要只确认“有图”:
Scalars中Loss/train应总体下降,Metrics/mae也应同步下降;若 loss 大幅锯齿,可先把学习率从0.1降到0.01再跑一组。Histograms中同一参数会随 step 形成分布序列;若权重长期几乎不变,检查优化器是否拿到了model.parameters(),以及是否执行了backward()与step()。Graphs应能看到两层Linear与中间的ReLU;若add_graph报输入形状错误,先用相同样本直接调用model(x[:8])验证forward。- run 选择器中只应把同一组实验放在同一个
runs根目录下,不要让测试脚本与正式训练共用同一个具体log_dir。
组织多次实验而不污染曲线
对比超参数时,每次运行使用独立目录,标签名称保持一致。比如比较两个学习率,可以固定数据与模型,只改变 run 目录和 lr。
| run 目录 | 学习率 | 适合比较的曲线 |
|---|---|---|
runs/lr-0.1 |
0.1 | Loss/train、Metrics/mae |
runs/lr-0.01 |
0.01 | Loss/train、Metrics/mae |
SummaryWriter 默认会异步写事件,长时间训练可以保留默认缓冲策略;需要在崩溃前尽量落盘时,应在关键 checkpoint 前调用 writer.flush()。若断点续训复用同一 log_dir,要确保 global_step 延续旧值,否则同一标签会出现 step 回退,曲线会变得难以解释。