
AI 内容创作 / 系统课时
时延、同步与显存故障排查
时延、同步与显存故障排查
本课把数字人系统中容易相互掩盖的四类故障放进同一条证据链:先用 trace_id 定位关键路径,再分别检查时间戳、队列等待、显存峰值和模型制品,最终形成可重复的修复与回归验证方法。
学习目标
- 能够依据链路日志拆分端到端时延,并识别排队、计算、传输和播放缓冲瓶颈。
- 能够使用统一时间基准定位音画偏移,并区分丢帧、等待和时间戳错误。
- 能够排查显存溢出与模型加载失败,完成修复后的压力回归和资源验证。
故障定位总路径
不要从反复重启服务开始排障。先固定请求、模型、角色和配置版本,再以 trace_id 与 generation_id 串联客户端、会话服务、AI 模块、渲染器和播放器。只有证据处于同一代生成任务中,阶段耗时和音画偏移才具有可比性。
| 现象 | 第一证据 | 重点责任域 |
|---|---|---|
| 首次响应慢 | 各阶段 start_time、end_time、队列长度 |
ASR、对话首字、TTS 首包、冷加载 |
| 播放卡顿 | 帧间隔、缓冲深度、丢帧数、网络抖动 | 渲染、编码、网络、播放器 |
| 音画不同步 | 音频 PTS、视频 PTS、统一时钟 | 驱动、编码、播放器 |
| 显存溢出 | 已分配显存、保留显存、活跃任务数 | 模型、批处理、帧缓存、生命周期 |
| 模型加载失败 | 文件路径、权限、哈希、格式、设备能力 | 制品管理、容器挂载、运行环境 |
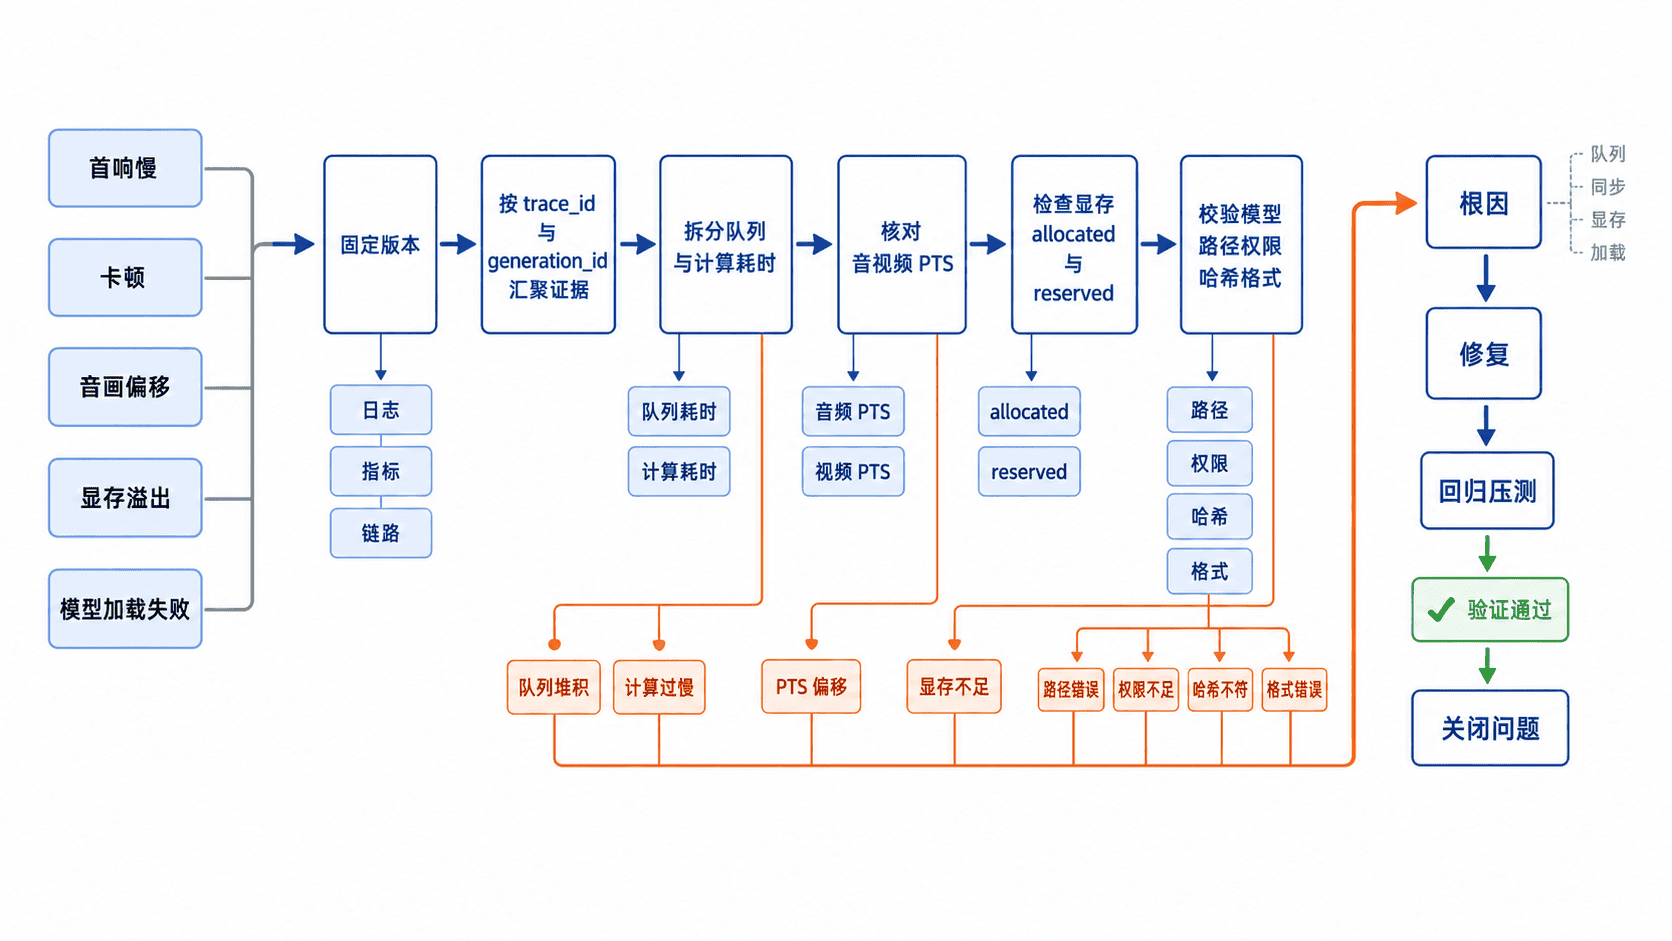
按症状拆解根因
时延与卡顿
端到端时延以客户端同一单调时钟测量。分别记录排队、模型、传输、编码、播放缓冲,并按关键路径找出先后与重叠。同一批请求再比较 p50、p95 和 p99,报告样本数、失败数、版本和并发。只在必要的诊断路径使用 GPU 同步或 CUDA Event 测量计算区间,异步提交耗时只反映调用方等待到提交返回。PyTorch CUDA 语义
首帧慢但后续流畅,通常优先检查模型冷加载、对话首字和 TTS 首包;周期性卡顿则更可能来自批处理等待、渲染帧耗时波动、编码阻塞或客户端缓冲耗尽。修复后必须在相同输入、相同并发和相同模型版本下重新测量。
音画不同步
本课沿用第 13 章约定。在同一代、同一个配对事件上,分别将音频与视频的 PTS 乘以各自 time_base(秒/计数),再映射到共同媒体起点。定义 偏差 = 画面事件时间 - 音频事件时间。正值代表画面事件晚,负值代表画面事件早。例:共同起点下,55_200 × 1/48_000 = 1.15 s,115_650 × 1/90_000 = 1.285 s,画面晚 135 ms。PTS 是计划呈现的媒体时间,实际播放还受网络、解码和缓冲影响;测量实际差值时应观测同一客户端的播放事件。缺时间戳、缺配对或跨代时应记录缺失。FFmpeg AVPacket 时间戳
若画面持续晚,检查配对起点、渲染生产、编码和接收缓冲。若偏差随播放时间持续变化,再查采样率和时钟漂移。按呈现顺序分析 PTS,避免把有 B 帧时的解码顺序当成呈现顺序。播放器可按策略等待、追赶或丢弃过期帧,并记录纠偏量。
显存溢出与模型加载失败
显存溢出可能由冷启动、动态批量、旧任务仍运行或张量及渲染缓存未释放造成。PyTorch 的 memory_allocated() 统计当前进程里张量占用,memory_reserved() 统计其缓存分配器管理量。GPU 设备级总显存使用还包含其他进程和 CUDA 开销;分配器保留量与活跃张量用量的差额也可能是正常缓存。empty_cache() 只释放未用缓存,无法释放活跃张量。观测尖峰应保留峰值与采样范围,多进程和多卡分别统计。PyTorch CUDA 内存管理 · NVIDIA nvidia-smi
模型加载失败应按“路径存在性 → 读取权限 → 文件哈希 → 序列化格式 → 精度与设备兼容性 → 初始化显存”顺序检查。修复后至少完成一次冷启动、一次模型切换和多轮会话释放,确认显存回到稳定基线且加载结果可重复。
用脚本汇总关键证据
这里用分类型 JSONL 保存观测。阶段记录来自同一个 trace_id 与 generation_id;音画记录表示同一语音事件的配对;显存和制品记录只与这次运行的观测窗相关。生产中按版本、设备与观测窗分组,再汇总多个请求的阶段分布。
保存以下数据为 metrics.jsonl。
{"kind":"stage","stage":"asr","ms":180}
{"kind":"stage","stage":"dialogue","ms":920}
{"kind":"stage","stage":"tts","ms":330}
{"kind":"stage","stage":"render","ms":280}
{"kind":"av","audio":[55200,1,48000],"video":[115650,1,90000]}
{"kind":"av","audio":[96000,1,48000],"video":[174600,1,90000]}
{"kind":"gpu","device":"GPU-demo","allocated_mib":7600,"reserved_mib":8100,"total_mib":8192}
{"kind":"load","status":"checksum_mismatch"}
保存以下代码为 diagnose.py。
import json
import math
import sys
from collections import defaultdict
from fractions import Fraction
from pathlib import Path

LIMITS = {"asr": 300, "dialogue": 700, "tts": 400, "render": 250}


def pts_seconds(stamp):
    pts, numerator, denominator = stamp
    if type(pts) is not int or type(numerator) is not int or type(denominator) is not int:
        raise ValueError("PTS and time base must be integers")
    if numerator <= 0 or denominator <= 0:
        raise ValueError("time base must be positive")
    return Fraction(pts * numerator, denominator)


def report(records):
    stages = defaultdict(list)
    offsets = []
    devices = defaultdict(list)
    load_events = []
    for row in records:
        kind = row["kind"]
        if kind == "stage":
            value = float(row["ms"])
            if not math.isfinite(value) or value < 0:
                raise ValueError("invalid stage duration")
            stages[row["stage"]].append(value)
        elif kind == "av":
            if row["audio"] is not None and row["video"] is not None:
                offsets.append(1000 * (pts_seconds(row["video"]) - pts_seconds(row["audio"])))
        elif kind == "gpu":
            allocated, reserved, total = (row[name] for name in ("allocated_mib", "reserved_mib", "total_mib"))
            if not 0 <= allocated <= reserved <= total or total <= 0:
                raise ValueError("invalid GPU counters")
            devices[row["device"]].append((allocated, reserved, total))
        elif kind == "load":
            load_events.append(row["status"])

    for stage, limit in LIMITS.items():
        values = sorted(stages[stage])
        if not values:
            print(f"{stage}: no data")
            continue
        p95 = values[math.ceil(len(values) * 0.95) - 1]
        print(f"{stage}: p95={p95:.1f} ms n={len(values)} {'SLOW' if p95 > limit else 'OK'}")
    if offsets:
        worst = max(offsets, key=abs)
        direction = "video late" if worst > 0 else "video early" if worst < 0 else "aligned"
        print(f"AV: worst={float(worst):+.1f} ms ({direction}), n={len(offsets)}")
    else:
        print("AV: no paired data")
    for device, samples in sorted(devices.items()):
        allocated, reserved, total = max(samples, key=lambda sample: sample[0] / sample[2])
        print(f"{device}: allocated={allocated}/{total} MiB ({allocated / total:.1%}), reserved={reserved} MiB")
    if not devices:
        print("GPU: no data")
    failures = sorted({status for status in load_events if status != "ok"})
    print("Load:", ", ".join(failures) if failures else "ok" if load_events else "no data")


if __name__ == "__main__":
    if len(sys.argv) != 2:
        raise SystemExit("usage: python diagnose.py <metrics.jsonl>")
    with Path(sys.argv[1]).open(encoding="utf-8") as source:
report(json.loads(line) for line in source if line.strip())python diagnose.py metrics.jsonlasr: p95=180.0 ms n=1 OK
dialogue: p95=920.0 ms n=1 SLOW
tts: p95=330.0 ms n=1 OK
render: p95=280.0 ms n=1 SLOW
AV: worst=+135.0 ms (video late), n=2
GPU-demo: allocated=7600/8192 MiB (92.8%), reserved=8100 MiB
Load: checksum_mismatch此处每个阶段只有 1 个值,p95 等于这个值;只能演示诊断口径。设备记录须来自同一进程分配器或已经正确聚合的同一统计范围。92.8% 是所选采样点的张量占用比,若要确认显存不足,结合设备用量、缓存、其他进程与 OOM 事件。制品哈希错误独立处理,即使同一窗口有旧模型完成请求也应检查加载链路。
验证闭环、常见错误与练习
| 常见错误 | 为什么无效 | 正确验证 |
|---|---|---|
| 只看平均时延 | 平均值会掩盖长尾卡顿 | 同时比较 p50、p95、p99 和慢请求明细 |
| 混用不同时间基准的 PTS | 原始数值的单位与起点不同 | 用各自 time_base 换算后对齐媒体起点,实际播放用同端时钟观测 |
| OOM 后只清缓存 | 活跃对象和并发峰值仍然存在 | 查找引用、取消旧任务并重复多轮会话 |
| 替换模型文件后直接上线 | 路径正确不代表内容与格式正确 | 校验哈希、冷加载、推理和释放全过程 |
练习 1:补充队列等待诊断
任务目标是区分“模型计算慢”和“请求排队久”。在指标文件中加入 queue_wait_ms,修改脚本输出最大值与 p95。验收条件是能对超过自定义阈值的队列等待输出 SLOW,且原有诊断结果保持不变。
练习 2:设计同步与显存回归
准备正常、视频落后、视频超前和显存持续增长四组记录。要求定义每组的通过条件,并连续执行至少三轮加载、生成、取消和释放。验收时应能指出失败发生在哪一阶段,而不是只给出“系统卡顿”的结论。
本课总结
- 故障排查应先固定版本并建立同一
trace_id、同一generation_id下的完整证据链。 - 时延、同步和显存问题必须分别量化,不能通过重启、加缓冲或清缓存掩盖根因。
- 修复完成的标准是相同负载下指标恢复、资源回落稳定,并通过冷启动与多轮回归。
下一课预告
下一课将进入“压测、灰度发布与项目复盘”,把单请求诊断扩展到并发容量、上线门槛、回滚演练和可追踪的工程改进闭环。