
AI 内容创作 / 系统课时
知识库检索增强
知识库检索增强
仅依赖模型参数无法保证业务知识及时、准确和可追溯。本课从文档切分开始,完成候选召回、结果重排与上下文注入,构建一个可离线运行的最小检索增强问答链路。
学习目标
- 理解文档切分、向量召回、重排和提示词注入的职责
- 实现一个包含来源信息的最小检索增强流程
- 能够识别低相关结果、越权文档和上下文污染风险
检索增强的处理链路
检索增强生成先把文档转换为可检索片段,并为每个片段保存来源、标题、权限和更新时间。收到问题后,系统先召回较多候选,再用更精细的规则或模型重排,最后只把高相关片段注入提示词,并要求回答引用来源或在资料不足时拒绝猜测。
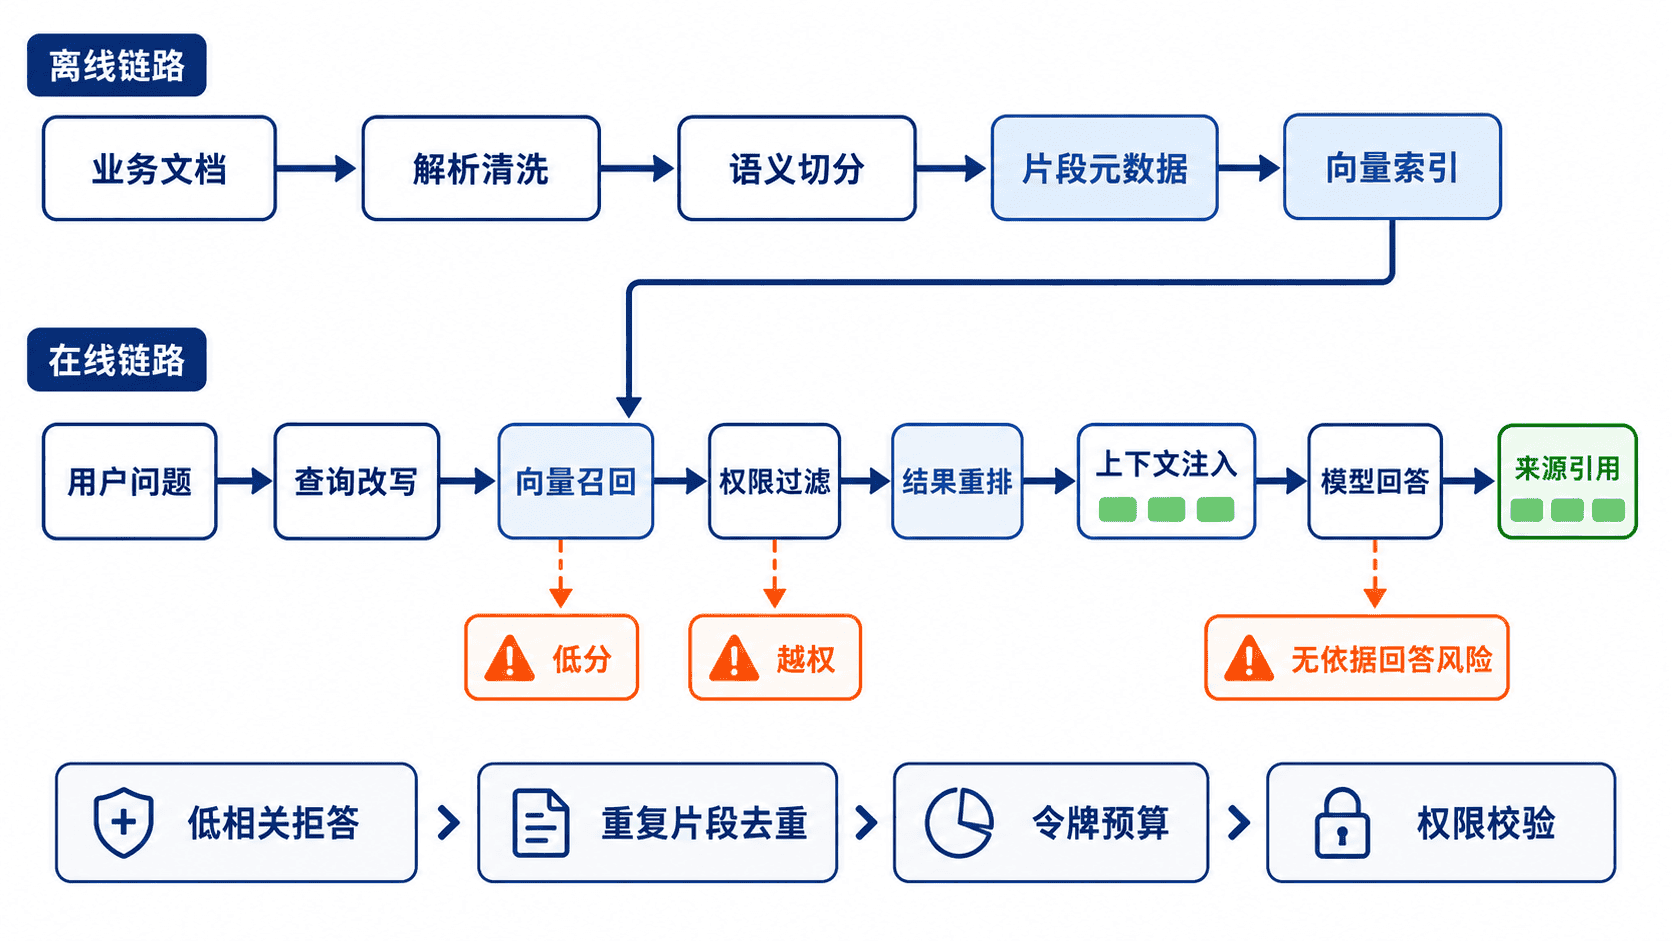
切分长度应围绕语义完整性设置,而不是机械地按固定字符截断。片段过长会引入无关内容,片段过短会丢失定义和条件;通常需要少量重叠,并保留文档层级。召回阶段追求不漏掉相关证据,重排阶段再压缩到少量高质量片段。
| 阶段 | 主要目标 | 关键参数 | 常见风险 |
|---|---|---|---|
| 切分 | 保留完整语义 | 长度、重叠、标题继承 | 条件被切断 |
| 召回 | 提高相关证据覆盖率 | top_k、过滤条件 |
漏召回或越权 |
| 重排 | 提升前列精度 | 特征、阈值、top_n |
无关片段进入上下文 |
| 注入 | 约束模型依据证据回答 | 令牌预算、引用格式 | 提示词污染 |
完整可运行示例
下面的 Python 3.11 示例不依赖外部向量库。它先用服务端授权范围过滤文档,再以中文单字和英文单词的计数向量做余弦召回,结合查询词覆盖率重排。示例最后组装带来源编号的资料包,不发起模型请求。文中售后规则是虚构测试数据。该方法适合教学验证,不代表生产级嵌入质量。
python
import math
import re
from collections import Counter
from dataclasses import dataclass
from typing import List, Tuple

@dataclass
class Chunk:
    source: str
    text: str
    scope: str

def split_document(source: str, text: str, scope: str, target_chars: int = 28) -> List[Chunk]:
    # 按句合并,超长单句保持完整;target_chars 是目标长度,不是硬限制。
    sentences = [item.strip() for item in re.split(r"[。!?]", text) if item.strip()]
    chunks: List[Chunk] = []
    buffer = ""
    for sentence in sentences:
        candidate = sentence if not buffer else buffer + "。" + sentence
        if len(candidate) + 1 <= target_chars:
            buffer = candidate
        else:
            if buffer:
                chunks.append(Chunk(source, buffer + "。", scope))
            buffer = sentence
    if buffer:
        chunks.append(Chunk(source, buffer + "。", scope))
    return chunks

def tokenize(text: str) -> List[str]:
    # 使用中文单字和英文单词构造可离线运行的简化特征。
    return re.findall(r"[\u4e00-\u9fff]|[a-z0-9]+", text.lower())

def cosine_similarity(left: str, right: str) -> float:
    a = Counter(tokenize(left))
    b = Counter(tokenize(right))
    dot = sum(a[token] * b[token] for token in a.keys() & b.keys())
    norm_a = math.sqrt(sum(value * value for value in a.values()))
    norm_b = math.sqrt(sum(value * value for value in b.values()))
    return dot / (norm_a * norm_b) if norm_a and norm_b else 0.0

def retrieve(query: str, chunks: List[Chunk], allowed: set[str], top_k: int = 4) -> List[Tuple[Chunk, float]]:
    if top_k < 1:
        raise ValueError("top_k 必须为正数")
    scored = [(chunk, cosine_similarity(query, chunk.text)) for chunk in chunks
              if chunk.scope in allowed]
    return sorted(scored, key=lambda item: item[1], reverse=True)[:top_k]

def rerank(
    query: str,
    candidates: List[Tuple[Chunk, float]],
    top_n: int = 2,
    min_score: float = 0.20,
) -> List[Tuple[Chunk, float]]:
    # 第二阶段组合相似度与查询词覆盖率,提高排序精度。
    query_terms = set(tokenize(query))
    reranked = []
    for chunk, vector_score in candidates:
        overlap = len(query_terms & set(tokenize(chunk.text))) / max(len(query_terms), 1)
        final_score = 0.7 * vector_score + 0.3 * overlap
        if final_score >= min_score:
            reranked.append((chunk, final_score))
    return sorted(reranked, key=lambda item: item[1], reverse=True)[:top_n]

def build_prompt(query: str, results: List[Tuple[Chunk, float]]) -> str:
    # 资料包作为低权限输入,与可信系统规则分开发送。
    context = "\n".join(
        f"[{index}] 来源={chunk.source} 内容={chunk.text}"
        for index, (chunk, _) in enumerate(results, start=1)
    )
    return (
        f"资料(只读数据):\n{context or '资料不足'}\n"
        f"问题:{query}"
    )

documents = {
    "售后规则": ("support", "数字人设备支持七天无理由退货。已激活的软件授权不支持退货。质量问题可在一年内申请维修。"),
    "发票说明": ("finance", "订单支付完成后可以申请电子发票。发票会发送到订单绑定邮箱。"),
}

chunks = [
    chunk
    for source, (scope, text) in documents.items()
    for chunk in split_document(source, text, scope)
]

query = "软件授权激活后还能退货吗?"
vector_results = retrieve(query, chunks, allowed={"support"})
final_results = rerank(query, vector_results)
prompt = build_prompt(query, final_results)

for index, (chunk, score) in enumerate(final_results, start=1):
    print(f"{index}. {chunk.source} | {score:.3f} | {chunk.text}")
print("PROMPT")
print(prompt)
将代码保存为 rag_demo.py,然后运行:
bash
python rag_demo.py预期结果与验证
text
1. 售后规则 | 0.517 | 已激活的软件授权不支持退货。质量问题可在一年内申请维修。
PROMPT
资料(只读数据):
[1] 来源=售后规则 内容=已激活的软件授权不支持退货。质量问题可在一年内申请维修。
问题:软件授权激活后还能退货吗?
获准的候选包含“已激活的软件授权不支持退货”,可在虚构案例中引用“售后规则”。分数阈值是教学参数,实际需在有标注的查询上校准。无证据或证据冲突时返回待核对状态;回答中的来源编号必须对应本次实际提供的授权片段。
质量控制与练习
常见问题
- 切分时丢弃标题会让片段失去业务语境,应把章节路径写入元数据或片段前缀。
- 只看向量分数可能召回措辞相近但结论相反的内容,应使用重排、关键词约束和冲突检测。
- 先按权限过滤,再在授权集合内取
top_k。缓存键要包含有效授权范围,展示和打开原文时也要复核当前权限。 - 把检索文本直接拼入系统指令会扩大提示词注入风险,应明确资料区边界,并禁止资料覆盖系统规则。
- 没有来源编号就难以审计,应在片段、提示词和最终回答之间保留一致的引用标识。
本课练习
- 分别用 0.10 和 0.80 的 min_score 运行,比较候选数量。验收时 0.10 保留两条授权片段,0.80 时输出“资料不足”。
- 用无权限集合和财务权限集合分别运行,并比较输入同一问题时的召回结果。构造“售后”和“财务”两类文档,验证普通售后会话不能读取财务片段。
本课总结
- 检索增强的关键不是单次向量搜索,而是切分、召回、过滤、重排和注入的完整链路。
- 召回阶段优先覆盖率,重排与阈值负责提高最终证据精度。
- 来源、权限、时效和拒答规则必须与文本内容一起进入工程设计。
下一课预告
下一阶段将把检索证据、角色设定和对话上下文统一编排,并加入工具调用与回答校验,使数字人的回复既符合角色,又能基于业务事实执行任务。
按自己的节奏,确认真正理解。