
AI 内容创作 / 系统课时
推理加速与批处理
推理加速与批处理
数字人链路通常同时调用 ASR、语言模型、TTS 和视觉驱动模型,单次推理速度并不等于端到端性能。本课从指标拆分开始,组合混合精度、图优化、动态批处理、缓存与异步执行,并用一个可运行调度器验证吞吐量与等待时间之间的取舍。
学习目标
- 能够拆分排队、预处理、模型计算、后处理与数据传输耗时。
- 能够为不同模型选择混合精度、图优化、缓存和批处理策略。
- 能够实现带最大批量、等待窗口、去重缓存和异步返回的最小调度器。
性能基线与加速策略
优化前先为每个请求记录 trace_id,并分别测量队列等待、预处理、模型计算、后处理和跨设备拷贝。串行阶段可以相加。阶段重叠时按请求关键路径计算,不能把所有并行 span 的耗时直接相加。只看模型平均耗时会掩盖长尾排队,因此至少同时观察吞吐量、并发数、GPU 利用率、显存峰值以及延迟的 p50、p95 和 p99。
| 策略 | 主要收益 | 关键边界 |
|---|---|---|
| 混合精度 | 降低显存占用并提高支持硬件上的张量吞吐 | FP16 需要检查溢出与精度退化;支持时可优先验证 BF16 |
| 图优化 | 减少解释器调度、常量计算和可融合算子开销 | 输入形状频繁变化可能触发重新编译或降低复用率 |
| 动态批处理 | 合并多个请求,提高设备利用率和单位时间处理量 | 批量越大,首个请求的排队时间通常越长 |
| 结果缓存 | 跳过重复且可复用的计算 | 缓存键必须包含模型版本、归一化参数、说话人和生成配置 |
| 异步执行 | 重叠网络、磁盘、CPU 预处理与设备计算 | 异步不会让单个 GPU 内核本身变快,仍需设置并发上限 |
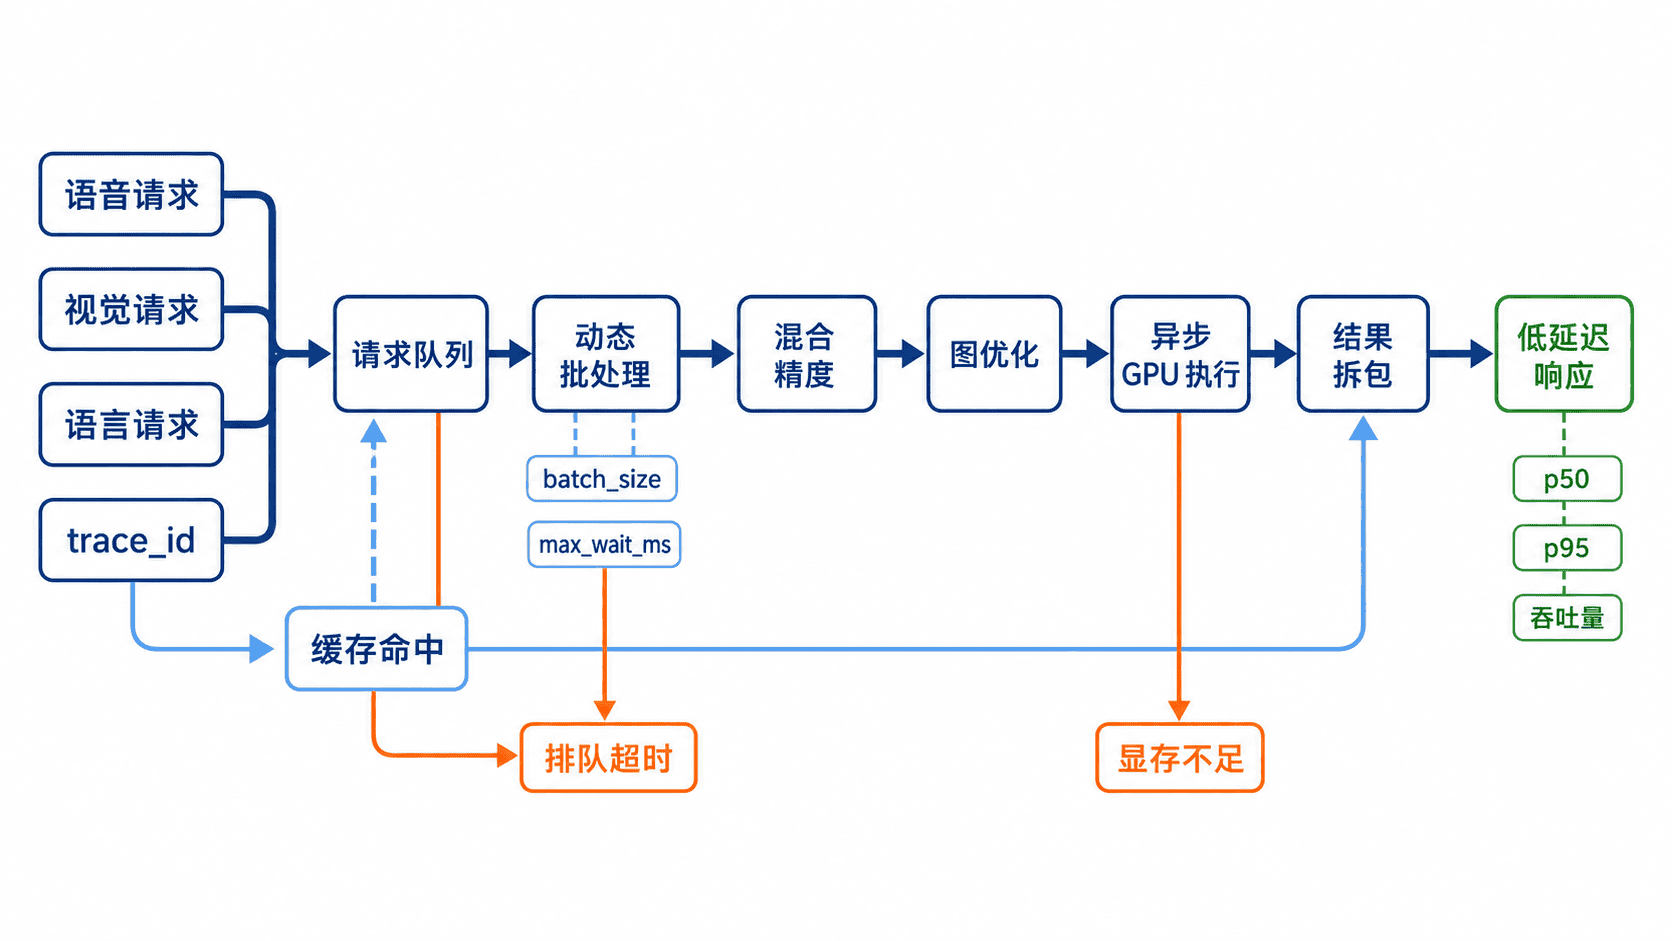
批处理策略应按模型分别配置。流式 TTS 更关注首包延迟,等待窗口通常应比离线视觉特征提取更短;语言模型的连续批处理还要考虑序列长度和 KV Cache 占用。启用低精度或编译图后,必须使用固定评测集比较输出质量,不能只依据速度决定上线。
动态批处理示例
示例使用 Python 3.11。请求进入有限队列,取出首个待组批请求后开始计算等待窗口。窗口只约束组批时间,之前的排队时间仍需单独记录。批内同租户同版本同输入去重。模型失败、输出数量不符和调用方取消都不会使队列无法退出。
import asyncio
from collections import OrderedDict


class Batcher:
    def __init__(self, model, version):
        self.model, self.version = model, version
        self.queue = asyncio.Queue(maxsize=8)
        self.cache = OrderedDict()
        self.accepting = False
        self.worker = None

    def start(self):
        if self.worker is not None:
            raise RuntimeError("already started")
        self.accepting = True
        self.worker = asyncio.create_task(self.run())

    async def infer(self, tenant, text):
        if not self.accepting:
            raise RuntimeError("batcher not accepting")
        key = (tenant, self.version, text)
        if key in self.cache:
            self.cache.move_to_end(key)
            return self.cache[key]
        result = asyncio.get_running_loop().create_future()
        try:
            self.queue.put_nowait((key, result))
        except asyncio.QueueFull:
            raise RuntimeError("batch queue full") from None
        return await result

    async def close(self):
        self.accepting = False
        if self.worker is not None:
            await self.queue.join()
            self.worker.cancel()
            await asyncio.gather(self.worker, return_exceptions=True)
            self.worker = None

    async def run(self):
        loop = asyncio.get_running_loop()
        while True:
            batch = [await self.queue.get()]
            try:
                until = loop.time() + .02
                while len(batch) < 3:
                    remaining = until - loop.time()
                    if remaining <= 0:
                        break
                    try:
                        batch.append(await asyncio.wait_for(self.queue.get(), remaining))
                    except TimeoutError:
                        break
                keys = list(dict.fromkeys(key for key, future in batch if not future.done()))
                if not keys:
                    continue
                async with asyncio.timeout(2):
                    outputs = await self.model([key[2] for key in keys])
                if not isinstance(outputs, (list, tuple)) or len(outputs) != len(keys) or not all(isinstance(value, str) for value in outputs):
                    raise ValueError("model returned invalid results")
                answers = dict(zip(keys, outputs))
                for key, future in batch:
                    if not future.done():
                        value = answers[key]
                        self.cache[key] = value
                        self.cache.move_to_end(key)
                        if len(self.cache) > 16:
                            self.cache.popitem(last=False)
                        future.set_result(value)
            except Exception:
                for _, future in batch:
                    if not future.done():
                        future.set_exception(RuntimeError("batch inference failed"))
            finally:
                for _ in batch:
                    self.queue.task_done()


async def main():
    calls = []

    async def uppercase(texts):
        calls.append(texts)
        return [text.upper() for text in texts]

    batcher = Batcher(uppercase, "v1")
    batcher.start()
    try:
        print(await asyncio.gather(*(batcher.infer("team-a", text) for text in ("hi", "avatar", "hi"))))
        print(await batcher.infer("team-a", "hi"))
        print("模型批次:", calls)
    finally:
        await batcher.close()


if __name__ == "__main__":
    asyncio.run(main())
保存为 dynamic_batcher.py,运行 python dynamic_batcher.py。
['HI', 'AVATAR', 'HI']
HI
模型批次: [['hi', 'avatar']]
示例按单一兼容模型组批。真实推理还要按模型、设备、输入形状或流式状态分桶。等待方取消后可丢弃其返回值;如果批已在设备上执行,并不代表取消能撤销计算。关闭会等待模型调用结束,故障模型需要外部截止时间和隔离回收。按租户隔离缓存只能解决一部分访问边界,用户私有结果还需按授权缩小复用范围。
调优与常见错误
先固定模型版本、输入集、并发模型和预热次数,再逐步改变一个参数。建议从较小的 max_batch_size 与 max_wait_ms 开始,以 p95 延迟是否满足服务目标作为约束,再寻找吞吐量最高的组合。队列必须设置容量;积压超过阈值时,应拒绝、降级或转移请求,避免无限排队最终耗尽内存。
常见错误包括只比较平均延迟、在整个服务上共用一个批量策略、缓存键遗漏生成参数,以及在未验证质量时直接切换低精度。另一个高频问题是把异步任务数量无限放大,导致更多请求同时占用显存。正确做法是使用信号量或工作池限制设备并发,并在模型版本更新时主动失效旧缓存。
本课总结
- 推理优化必须同时衡量排队、计算、吞吐、显存和长尾延迟,而不是只看单次模型耗时。
- 混合精度、图优化、批处理、缓存与异步执行解决的问题不同,需要按模型和服务目标组合使用。
- 动态批处理必须同时设置批量上限、等待窗口、队列容量、缓存版本和质量回归验证。
下一课预告
下一课将学习“Docker 容器化部署”,把模型服务、系统依赖、运行配置和持久化目录封装为可重复构建、可验证启动的部署单元。