
AI 内容创作 / 系统课时
音频预处理与响度归一化
音频预处理与响度归一化
同一段台词可能来自手机、录音棚或在线会议,采样率、声道、静音长度、背景噪声和响度往往不同。本课将这些差异整理为固定处理顺序,并通过 FFmpeg 构建可重复执行的流水线,输出适合语音识别、声音克隆和数字人口型驱动的标准音频。
学习目标
- 设计重采样、声道转换、静音裁剪、降噪和响度归一化的合理顺序。
- 使用 FFmpeg 生成可复用的音频预处理脚本。
- 通过流参数、时长、峰值和试听检查验证处理结果。
预处理顺序与参数
先探测原始采样率、声道和电平。根据录音决定是否混音、降噪或裁剪。示例先下混、过滤低频和高频,再裁剪两端、适度降噪、响度归一化,最后重采样并检查。若原素材用于已有音画同步,裁剪会改变时间轴,应记录起止偏移并同步调整视频。
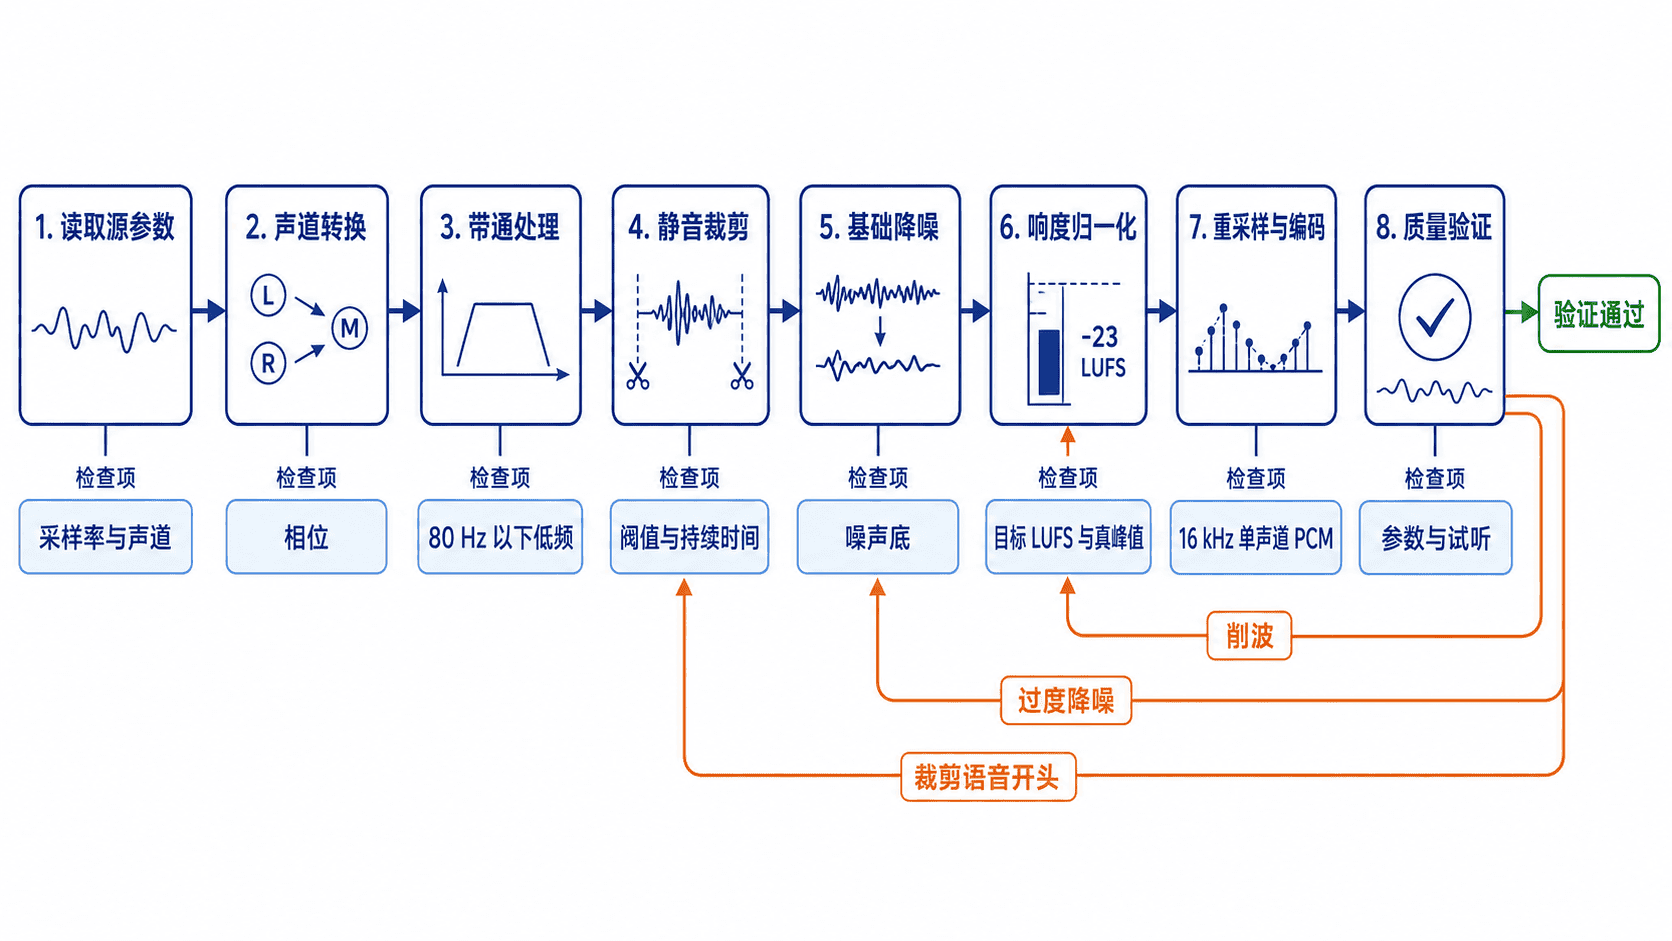
静音裁剪应同时设置阈值和最短持续时间,避免把辅音起始、轻声或自然停顿误删。降噪以降低稳定底噪为目标,不应追求完全无噪;过强处理会产生金属音、音乐噪声和齿音损伤。响度归一化则调整整体电平,使不同文件在感知响度上接近,而不是把每个样本简单缩放到相同峰值。
LUFS 用于衡量感知响度,True Peak 用于约束重建后的峰值。示例使用 -16 LUFS、LRA 7 LU、True Peak -1.5 dBTP 作为教学参数;真实项目应服从模型文档、训练集规范或发布平台标准。批量训练数据更重要的是全库一致,不能让不同文件使用互相矛盾的目标。
构建可复用流水线
以下 Bash 脚本需要 ffmpeg 与 ffprobe 在 PATH 中,课堂已核对 FFmpeg 8.0.1。它生成首尾各 0.5 秒静音、中间含 0.3 秒停顿的立体声,再输出单声道 16 kHz PCM。每次运行写新目录。将脚本保存为 preprocess_audio.sh,运行 bash preprocess_audio.sh。
#!/usr/bin/env bash
set -euo pipefail

folder="$(mktemp -d ./audio-preprocess.XXXXXX)"
raw="$folder/raw_voice.wav"
out="$folder/normalized_voice.wav"

ffmpeg -hide_banner -loglevel error -n \
  -f lavfi -i "anullsrc=r=48000:cl=stereo:d=0.5" \
  -f lavfi -i "sine=frequency=220:duration=1:sample_rate=48000,pan=stereo|c0=c0|c1=c0" \
  -f lavfi -i "anullsrc=r=48000:cl=stereo:d=0.3" \
  -f lavfi -i "sine=frequency=330:duration=1:sample_rate=48000,pan=stereo|c0=c0|c1=c0" \
  -f lavfi -i "anullsrc=r=48000:cl=stereo:d=0.5" \
  -filter_complex "[0:a][1:a][2:a][3:a][4:a]concat=n=5:v=0:a=1[a]" \
  -map "[a]" -c:a pcm_s16le "$raw"

trim="silenceremove=start_periods=1:start_duration=0.05:start_threshold=-55dB:start_silence=0.05"
ffmpeg -hide_banner -loglevel error -n -i "$raw" \
  -af "pan=mono|c0=0.5*c0+0.5*c1,highpass=f=80,lowpass=f=7600,$trim,areverse,$trim,areverse,afftdn=nr=6:nf=-45,loudnorm=I=-16:LRA=7:TP=-1.5,aresample=16000" \
  -c:a pcm_s16le "$out"

ffprobe -v error -select_streams a:0 -show_entries stream=codec_name,sample_rate,channels \
  -of default=noprint_wrappers=1 "$out"
预期输出
codec_name=pcm_s16le
sample_rate=16000
channels=1
先裁开头,再反转整段裁另一端并反转回来,可以保留中间停顿。反转会缓冲整段,只适合短文件离线处理。长音频可先检测静音区间,再按确认后的时间范围裁剪。此处两声道内容相同,平均混音合理。真实录音须检查是否相消或只有单侧有效。
loudnorm 可能使用动态模式。需要双遍时,第一遍在相同的归一化前处理链末尾加 print_format=json 获取测量,再将 input_i、input_lra、input_tp、input_thresh、target_offset 分别传给第二遍的 measured_I、measured_LRA、measured_TP、measured_thresh、offset。峰值或响度范围条件不满足时,线性模式会回退。用 ebur128=peak=true 或等效测量重新检查最终导出文件,别把滤镜目标当成最终测量值。
质量验证与常见错误
自动检查至少应覆盖输出是否可解码、采样率是否正确、是否为单声道、编码是否符合要求、时长是否异常以及峰值是否越界。参数通过后仍要试听,因为过度降噪、呼吸声截断、混响尾音消失和声道相消不一定能从元数据中发现。
| 错误表现 | 常见原因 | 修复方法 |
|---|---|---|
| 语音开头被吃掉 | 阈值过高、连续有效音频门槛与素材不匹配或边缘没有留量 | 可把 dBFS 阈值调得更低(例如从 -45 改到 -55),或保留一小段首尾静音。用获准使用的语音检查轻声及辅音起始 |
| 音色出现水下感或金属感 | 降噪强度过大 | 减弱 afftdn 参数,优先改善录音环境并保留轻微自然底噪 |
| 归一化后仍然削波 | 只做峰值放大,未约束 True Peak | 使用响度归一化并设置 True Peak 上限,处理后重新测量 |
| 单声道后声音变小 | 左右声道相位相反,直接混合发生抵消 | 先检查相关性与相位,必要时选择有效声道或修复相位 |
| 批量结果忽大忽小 | 每个文件使用不同目标或单遍结果波动 | 固定全库标准,严格任务使用两遍 loudnorm |
流水线应保持“原始文件只读、输出写入新目录、参数写入版本控制、处理日志可追踪”。任何参数调整都应在固定验证集上比较,不能只凭一条素材试听后直接覆盖整个数据集。
本课总结
- 音频预处理必须按顺序执行,并在每个关键步骤后验证,避免噪声、静音和响度问题相互放大。
- 响度归一化关注感知响度与 True Peak,不等同于把峰值简单拉到同一数值。
- 自动参数检查与人工试听缺一不可,批量任务还应保存配置、日志和原始文件。
下一课预告
下一阶段将继续学习视频帧率、分辨率、色彩与时间轴等基础,为数字人的画面驱动、音画同步和最终合成建立统一的数据标准。