
AI 内容创作 / 系统课时
语音识别质量评估
语音识别质量评估
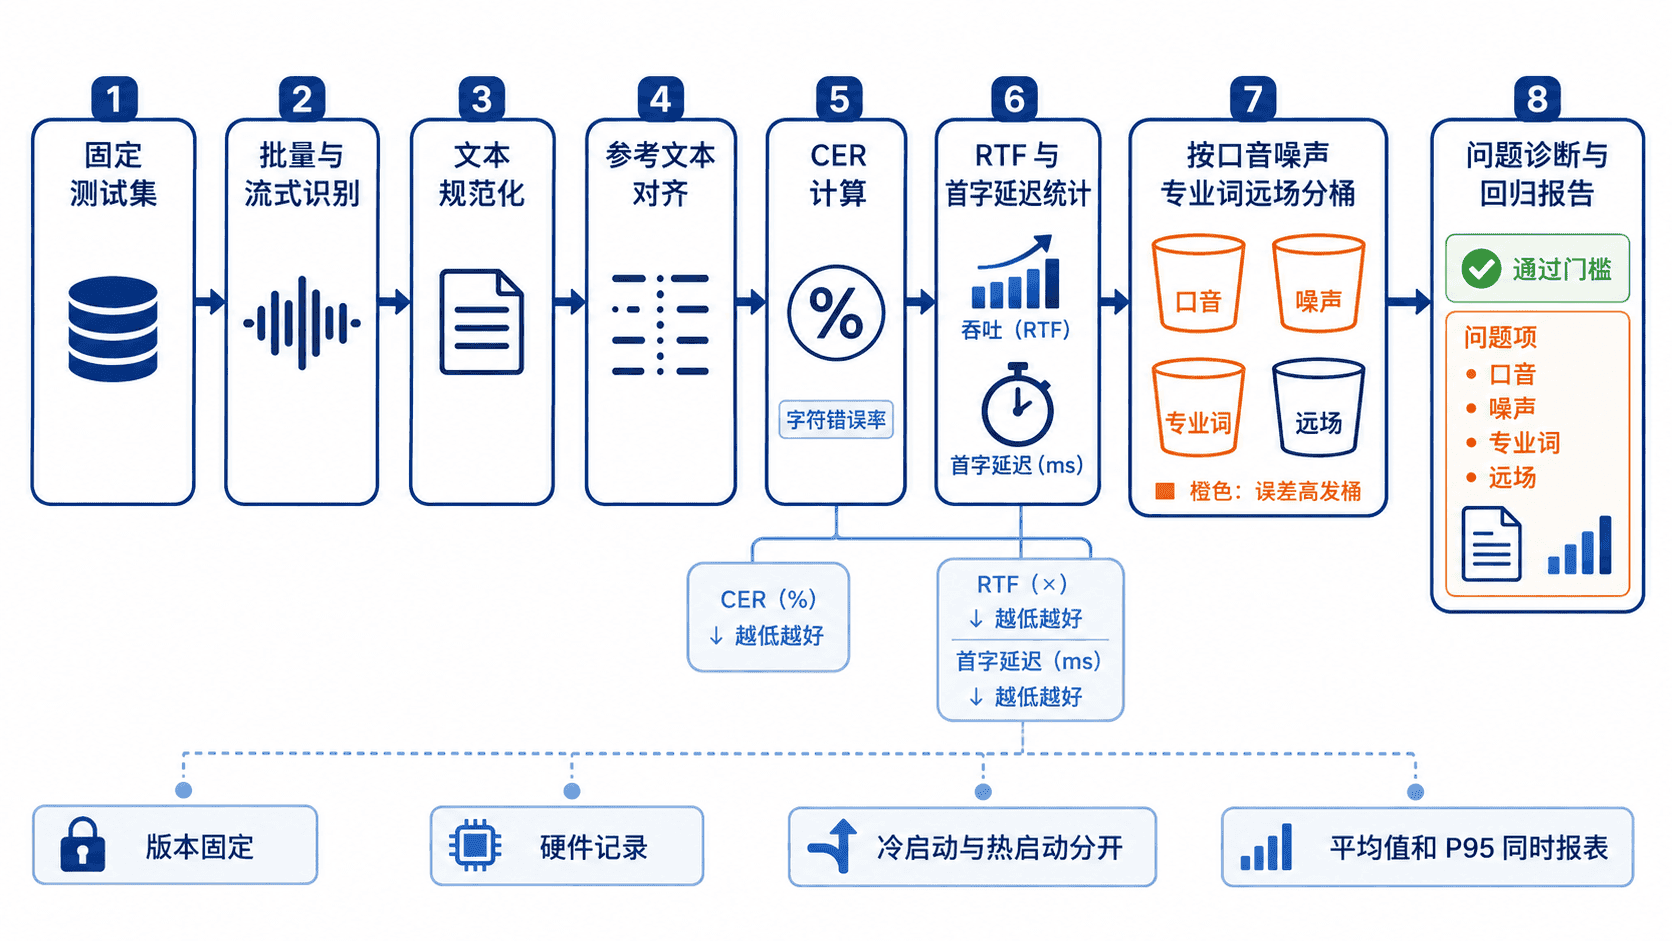
语音识别是否“可用”不能只靠主观试听。本课建立可重复的评测流程,用字错误率衡量文本准确度,用实时率衡量处理速度,用首字延迟衡量流式响应,并按口音、噪声、专业词和远场条件定位误差来源。
学习目标
- 能正确计算并解释字错误率、实时率和首字延迟。
- 能设计固定测试集,避免评测口径前后不一致。
- 能根据分桶结果定位主要误差并提出改进方向。
指标体系与测试口径
中文语音识别常用字错误率 CER,计算式为 。其中 S 是替换数,D 是删除数,I 是插入数,N 是参考文本字符数。先约定字符单位与规范化策略,对参考与识别结果使用同一规则。静音参考的单样本 CER 无定义,但在包含非空参考的语料总体中可以计入该样本的插入数,另报静音误识率。插入较多时 CER 可超过 100%。
实时率 RTF 的计算式为 。RTF < 1 表示处理速度快于音频播放速度,但它不代表低延迟。首字延迟从第一批音频进入识别会话计到首次非空临时结果。首次稳定文本另列。没有结果、超时或取消的样本单独计数,不作为零秒加入。单流离线 RTF 测处理耗时,不能把实时模拟中的固定等待混进处理耗时。
测试集设计与误差分桶
测试集应固定音频、参考文本、采样率、切分方式和评测脚本版本,同时记录模型版本、硬件和并发数。离线吞吐与流式交互要分开评测,冷启动与热启动也不能混为一个平均值。
| 分桶维度 | 典型问题 | 诊断信号 | 优先改进方向 |
|---|---|---|---|
| 口音 | 发音与训练数据差异较大 | 特定地区样本的 CER 明显升高 |
增加对应口音数据或做自适应 |
| 噪声 | 背景声遮盖辅音和词尾 | 低信噪比样本删除错误增加 | 降噪、波束形成、噪声增强训练 |
| 专业词 | 领域词未进入语言模型 | 近音词替换集中出现 | 热词、词表、领域语言模型 |
| 远场 | 混响和距离衰减 | 长句删除、重复和延迟上升 | 麦克风阵列、去混响、端点检测优化 |
总体平均值只能说明全局趋势。发布门槛应同时查看分桶 CER、首字延迟的 P50 与 P95、失败率和空结果率,避免少量极慢请求被平均值掩盖。
完整可运行示例
下面的 Python 程序使用字符级动态规划统计替换、删除和插入次数,并汇总 CER、RTF 与观测到的首字延迟。示例为合成数据,转写文本已采用同一规范。示例只依赖标准库,可直接保存为 evaluate_asr.py 运行。
from dataclasses import dataclass
from math import ceil, isfinite


@dataclass(frozen=True)
class Sample:
    reference: str
    hypothesis: str
    audio_seconds: float
    processing_seconds: float
    first_token_seconds: float | None


def edit_counts(reference: str, hypothesis: str) -> tuple[int, int, int]:
    rows = len(reference) + 1
    cols = len(hypothesis) + 1
    dp = [[(0, 0, 0, 0) for _ in range(cols)] for _ in range(rows)]

    for i in range(1, rows):
        dp[i][0] = (i, 0, i, 0)
    for j in range(1, cols):
        dp[0][j] = (j, 0, 0, j)

    for i in range(1, rows):
        for j in range(1, cols):
            if reference[i - 1] == hypothesis[j - 1]:
                dp[i][j] = dp[i - 1][j - 1]
                continue

            diagonal = dp[i - 1][j - 1]
            deleted = dp[i - 1][j]
            inserted = dp[i][j - 1]

            candidates = [
                (diagonal[0] + 1, diagonal[1] + 1, diagonal[2], diagonal[3]),
                (deleted[0] + 1, deleted[1], deleted[2] + 1, deleted[3]),
                (inserted[0] + 1, inserted[1], inserted[2], inserted[3] + 1),
            ]
            # 同样的最小编辑距离可有多个分解。这里固定先比较插入与删除总数。
            dp[i][j] = min(
                candidates,
                key=lambda item: (item[0], item[2] + item[3], item[1]),
            )

    _, substitutions, deletions, insertions = dp[-1][-1]
    return substitutions, deletions, insertions


def percentile(values, q):
    ordered = sorted(values)
    return ordered[max(0, ceil(len(ordered) * q) - 1)] if ordered else None


def evaluate(samples: list[Sample]) -> None:
    total_s = total_d = total_i = total_n = 0
    audio = processing = 0.0
    first_tokens = []
    for sample in samples:
        if not isfinite(sample.audio_seconds) or sample.audio_seconds <= 0:
            raise ValueError("invalid audio duration")
        if not isfinite(sample.processing_seconds) or sample.processing_seconds < 0:
            raise ValueError("invalid processing duration")
        latency = sample.first_token_seconds
        if latency is not None:
            if not isfinite(latency) or latency < 0:
                raise ValueError("invalid first-token delay")
            first_tokens.append(latency)
        s, d, i = edit_counts(sample.reference, sample.hypothesis)
        total_s += s
        total_d += d
        total_i += i
        total_n += len(sample.reference)
        audio += sample.audio_seconds
        processing += sample.processing_seconds

    print(f"S={total_s}, D={total_d}, I={total_i}, N={total_n}")
    if total_n:
        print(f"CER={(total_s + total_d + total_i) / total_n:.2%}")
    else:
        print("CER=不可计算")
    print(f"RTF={processing / audio:.2f}" if audio else "RTF=不可计算")
    if first_tokens:
        print(f"首字 P50/P95={percentile(first_tokens, .50):.2f}/{percentile(first_tokens, .95):.2f} 秒")
    else:
        print("首字 P50/P95=不可计算")
    print(f"首字可观测={len(first_tokens)}/{len(samples)}")

if __name__ == "__main__":
    test_samples = [
        Sample("今天下午三点开会", "今天下午三点开会", 8.0, 1.6, 0.45),
        Sample("请打开会议纪要", "请打开会议记要", 7.0, 1.4, 0.55),
        Sample("", "", 5.0, 1.0, None),
    ]
    evaluate(test_samples)
运行命令如下。
python evaluate_asr.py预期输出如下。
S=1, D=0, I=0, N=15
CER=6.67%
RTF=0.20
首字 P50/P95=0.45/0.55 秒
首字可观测=2/3
常见错误与改进方法
第一类错误是参考文本与识别文本采用不同规范。例如参考文本写“15:00”,识别文本写“下午三点”,直接计算会产生大量无意义编辑。如果任务约定“15:00”和“下午三点”为等价表达,可按一套明确规则转成统一形式。若时间表达的准确性本身就是评测目标,则分别报告原文及规范化结果。
第二类错误是只报告平均延迟。平均值可能掩盖长尾,流式服务至少应报告 P50、P95 和超时比例。比较不同模型时还要固定硬件、并发数、音频切块和网络环境。
第三类错误是测试集泄漏或样本过于单一。评测样本应与训练、调参与阈值校准样本隔离。相同说话者或同一录音拆分的内容可能造成跨集合泄漏。也不能只包含安静近讲普通话。应按真实业务比例覆盖口音、噪声、专业词、远场和不同句长。
本课练习
- 在示例中增加一条包含删除错误和一条包含插入错误的样本,核对
S、D、I与总CER。验收时需给出手工对齐结果,并确认程序输出一致。 - 为样本增加
condition字段,分别统计安静、噪声和远场三组CER。验收时应输出每组样本数和指标,且总体指标仍按全部字符汇总。
本课总结
CER衡量文本准确度,RTF衡量处理速度,首字延迟衡量流式交互响应,三者不能互相替代。- 评测结果只有在文本规范、测试集、硬件、并发和计时起点固定时才可比较。
- 按口音、噪声、专业词和远场分桶,才能把总体误差转化为可执行的优化任务。
下一课预告
下一阶段将把稳定的识别文本接入语音理解流程,继续学习如何结合上下文完成意图识别、实体提取和多轮对话状态管理。