
AI 内容创作 / 系统课时
基础语音合成接口封装
基础语音合成接口封装
本课把不同语音合成服务收敛为稳定的应用接口。完成后,你将得到统一的请求模型、参数校验、结果对象、缓存键和异常边界,并能用离线模拟提供器验证音色、语速、音调、采样率及输出格式配置是否正确传递。
学习目标
- 设计与具体厂商解耦的语音合成请求和结果模型。
- 实现参数校验、结果缓存及异常封装。
- 通过可运行程序验证首次合成、缓存命中和错误输入三条路径。
接口边界与数据流
数字人业务层只应表达“合成什么声音”,不应直接依赖某个服务的字段名、鉴权方式或响应结构。统一接口接收文本和声音参数,先校验边界,再计算缓存键;未命中时调用提供器,随后把音频字节、采样率、格式、时长等信息归一化为稳定结果。
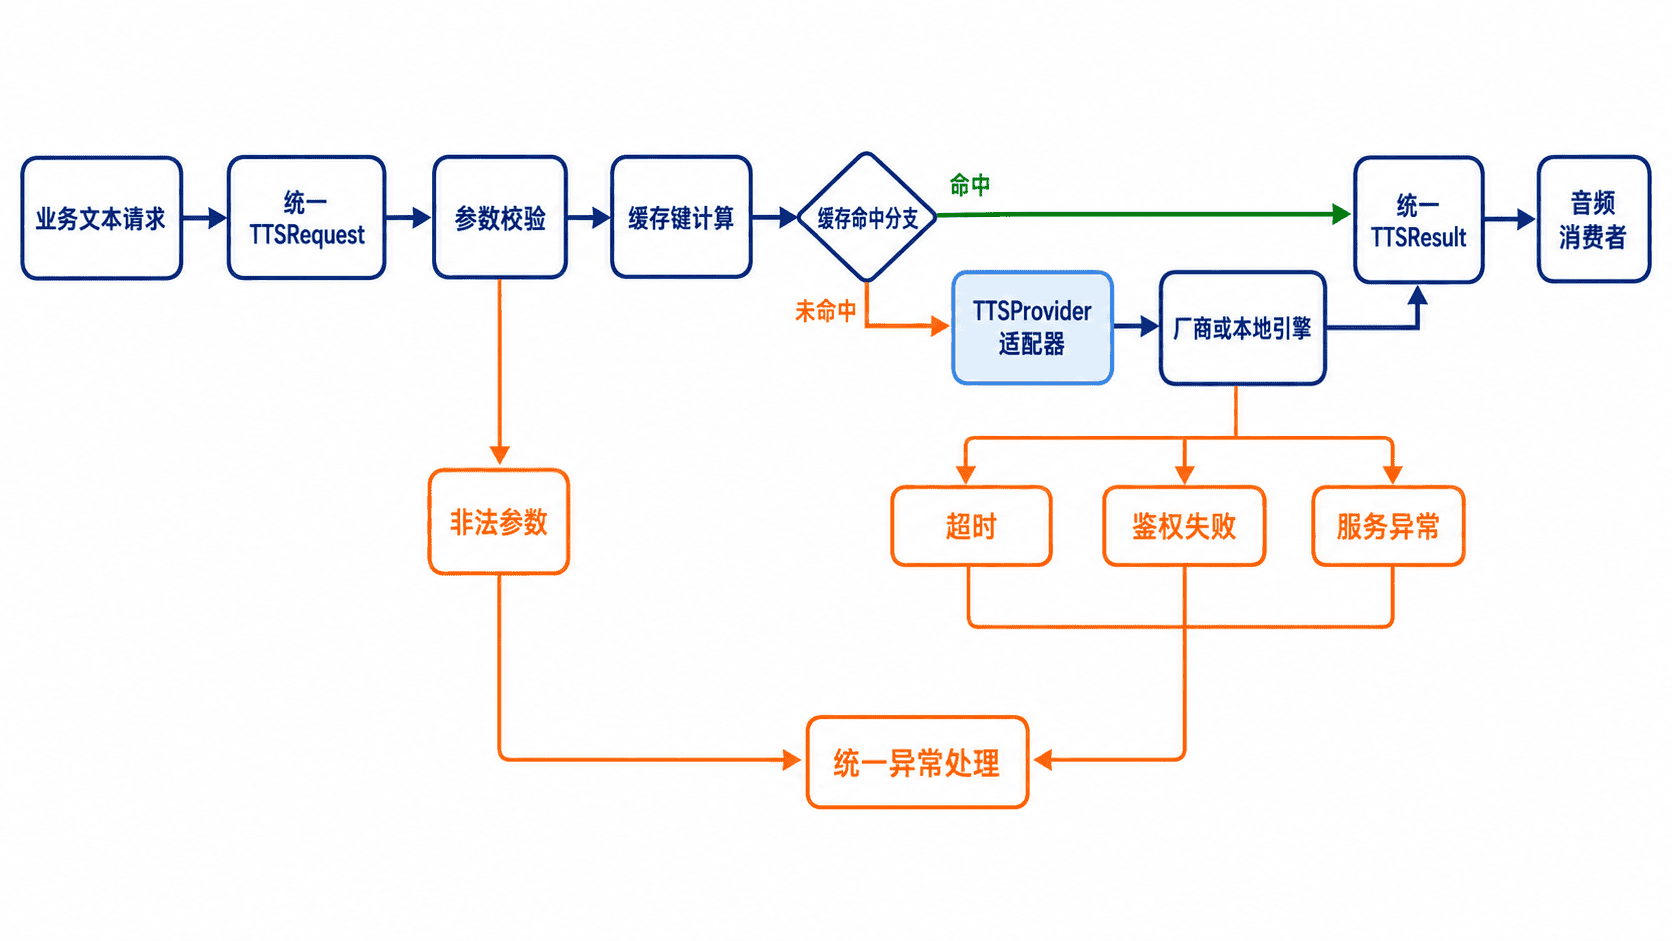
接口层还应明确同步与异步边界。最小实现可以提供同步 synthesize(request),上层通过线程池或任务队列控制并发;当服务原生支持流式返回时,可另设 synthesize_stream(request),不要让一个方法同时返回完整字节和分块迭代器。
数据模型与校验规则
请求模型应使用不可变数据,避免缓存键计算后字段又被修改。下表给出本课示例采用的核心字段和边界。
| 字段 | 作用 | 示例边界 |
|---|---|---|
text |
待合成文本 | 去除首尾空白后不得为空 |
voice |
逻辑音色标识 | 由适配器映射到真实音色 |
rate |
语速倍率 | 示例限制为 0.5 到 2.0 |
pitch_st |
半音偏移 | 示例限制为 -12 到 12 |
sample_rate |
输出采样率 | 示例支持 16000、24000、48000 |
format |
音频封装或裸样本 | 示例支持 wav 和裸 pcm |
缓存键至少要覆盖文本、音色、语速、音调、采样率和格式。生产环境还应加入提供器名称、模型版本、语言、情感参数和后处理版本,否则升级模型后可能错误复用旧音频。结果对象应同时返回二进制音频与元数据,避免上层通过解析文件头猜测格式。
完整可运行示例
下面用 Python 3.11 标准库生成合成测试音,验证音色、音高、语速、格式与缓存契约。两个示例音色对应不同基频,没有生成可理解语音。业务层可换成真实提供器,但应先核对该服务支持的参数和输出结构。
from collections import OrderedDict
from dataclasses import dataclass, replace
from enum import Enum
import io
import math
import struct
import wave


class Format(str, Enum):
    WAV = "wav"
    PCM = "pcm"


@dataclass(frozen=True)
class Request:
    text: str
    voice: str = "narrator"
    rate: float = 1.0
    pitch_st: float = 0.0
    sample_rate: int = 24000
    format: Format = Format.WAV


@dataclass(frozen=True)
class Result:
    audio: bytes
    sample_rate: int
    format: Format
    samples: int
    cache_hit: bool = False


class ToneProvider:
    version = "synthetic-tone-v1"
    voices = {"narrator": 220, "assistant": 330}

    def synthesize(self, request):
        duration = max(0.2, len(request.text) * 0.08 / request.rate)
        frames = round(request.sample_rate * duration)
        frequency = self.voices[request.voice] * 2 ** (request.pitch_st / 12)
        pcm = b"".join(
            struct.pack("<h", round(9000 * math.sin(math.tau * frequency * i / request.sample_rate)))
            for i in range(frames)
        )
        if request.format is Format.PCM:
            return pcm
        buf = io.BytesIO()
        with wave.open(buf, "wb") as file:
            file.setparams((1, 2, request.sample_rate, 0, "NONE", "not compressed"))
            file.writeframes(pcm)
        return buf.getvalue()


def sample_count(audio, request):
    if not isinstance(audio, bytes) or not audio:
        raise ValueError("expected nonempty audio bytes")
    if request.format is Format.PCM:
        if len(audio) % 2:
            raise ValueError("incomplete PCM sample")
        return len(audio) // 2
    with wave.open(io.BytesIO(audio), "rb") as file:
        if (file.getnchannels(), file.getsampwidth(), file.getframerate()) != (1, 2, request.sample_rate):
            raise ValueError("unexpected WAV format")
        count = file.getnframes()
        if not count or len(file.readframes(count)) != 2 * count:
            raise ValueError("truncated WAV")
        return count


class Service:
    def __init__(self, provider):
        self.provider = provider
        self.cache = OrderedDict()

    def synthesize(self, tenant, request):
        if not isinstance(tenant, str) or not tenant.strip():
            raise ValueError("authenticated tenant required")
        if not isinstance(request.text, str) or not request.text.strip() or len(request.text) > 120:
            raise ValueError("text must contain 1 to 120 characters")
        if not isinstance(request.voice, str) or request.voice not in self.provider.voices or not isinstance(request.format, Format):
            raise ValueError("unsupported voice or format")
        if type(request.sample_rate) is not int or request.sample_rate not in {16000, 24000, 48000}:
            raise ValueError("unsupported sample rate")
        for value, low, high in ((request.rate, .5, 2), (request.pitch_st, -12, 12)):
            if type(value) not in (int, float) or not low <= value <= high:
                raise ValueError("invalid rate or pitch")

        key = (tenant, self.provider.version, request)
        if key in self.cache:
            self.cache.move_to_end(key)
            return replace(self.cache[key], cache_hit=True)
        try:
            audio = self.provider.synthesize(request)
            count = sample_count(audio, request)
        except (OSError, ValueError, wave.Error, EOFError):
            raise RuntimeError("tts_provider_or_audio_error") from None
        result = Result(audio, request.sample_rate, request.format, count)
        self.cache[key] = result
        if len(self.cache) > 16:
            self.cache.popitem(last=False)
        return result


if __name__ == "__main__":
    service = Service(ToneProvider())
    request = Request("你好,数字人")
    for label, tenant in (("first", "team-a"), ("again", "team-a"), ("other_tenant", "team-b")):
        result = service.synthesize(tenant, request)
        print(label, result.cache_hit, result.sample_rate, result.samples, len(result.audio))
将示例保存为 tts_interface_demo.py,运行 python tts_interface_demo.py。
first False 24000 11520 23084
again True 24000 11520 23084
other_tenant False 24000 11520 23084
可信调用层在鉴权后提供租户。不同租户即使请求相同也不共享缓存。生产还应按数据权限进一步划分缓存范围。缓存键包含完整请求和提供器版本,不使用分隔符拼接,也不把没有提前约定量化的浮点参数四舍五入。真实请求若含语言、授权音色版本和后处理等参数,也应加入键。课堂缓存为有界单进程示例,多线程或多实例需控制并发和重复生成,按要求设置缓存过期及删除。
WAV 校验头和样本数据。裸 PCM 缺少头部,采样率、声道、位深和字节序必须由经过验证的适配器契约提供。重试由错误类型及提供器保证决定;音频交付、费用或业务写入状态未知时先按请求 ID 核对。