
AI 内容创作 / 系统课时
字幕生成与画面排版
字幕生成与画面排版
本课把语音识别或语音合成产生的时间戳转换为可渲染字幕,并处理语义换行、字体回退、描边、安全区域与中英文混排。完成后,你将得到一份可直接交给播放器或合成器使用的 ASS 字幕文件。
学习目标
- 根据起止时间生成稳定的字幕片段,并避免重叠与过短闪烁。
- 为横屏画面设置行数、字号、描边和安全区域。
- 使用 Python 生成包含中文、英文与强制换行的 ASS 字幕文件。
从时间戳到字幕片段
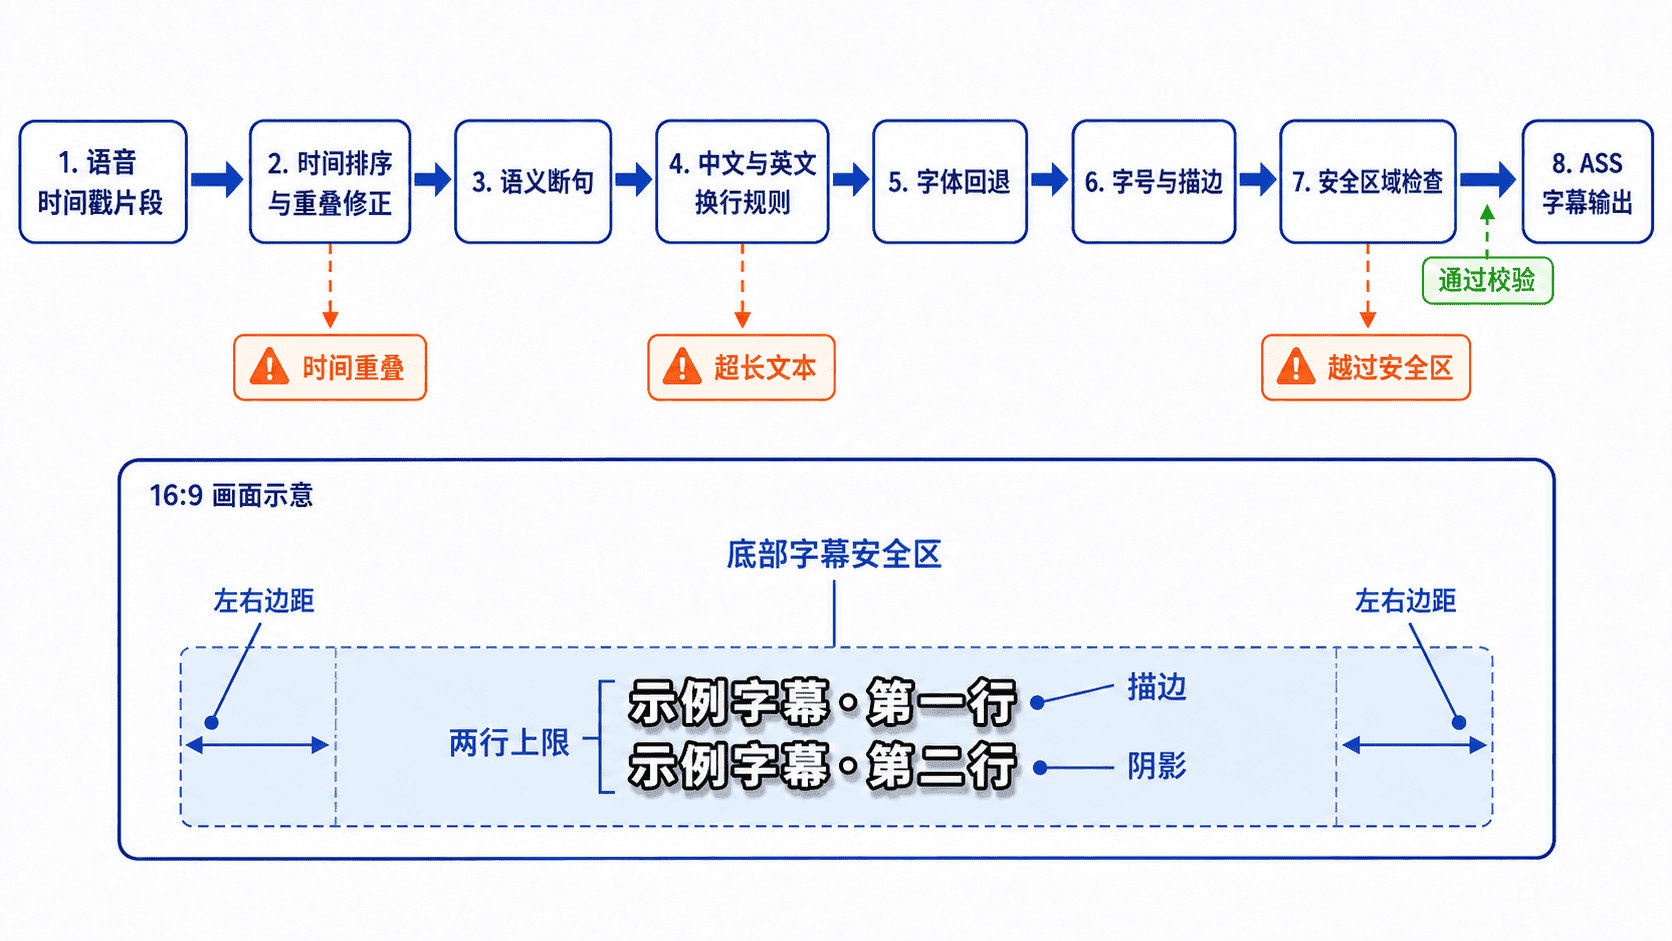
字幕片段至少包含 start_ms、end_ms、text 和 language。生成前应先按时间排序,再检查结束时间是否晚于开始时间。相邻片段发生重叠时,可以把前一条的结束时间截断到后一条开始时间;持续时间过短时可在业务层合并到邻近语义单元。ASS 使用百分秒,示例先向下量化起止时间,再拒绝归入同一开始时刻或已变成零时长的片段。
换行不能只按字符数硬切。中文可在标点或短语边界换行,英文应尽量保持单词完整,数字、单位和专有名词不应被拆开。横屏视频通常控制为最多两行,每行承载一个完整语义块;对白过长时,应优先缩短文案或拆分时间段,而不是无限缩小字号。
字体、描边与安全区域
字幕首先要保证可读性,再考虑视觉风格。字体应覆盖目标语言字符集,中文、日文、韩文和阿拉伯文常需要分别配置字体回退。浅色字幕配深色描边通常比单纯阴影更稳定,因为复杂背景、运动画面和压缩噪声都会降低边缘对比度。
安全区域是字幕不能越过的可视边界。对于 1920×1080 横屏画面,可把左右边距设为约 5%,底部边距设为约 6%~10%,同时避开播放器进度条、人物口型和已有角标。多语言版本应分别测试字符宽度;相同字号下,英文单词和德文复合词可能比中文更容易超宽。
| 排版项 | 建议基线 | 主要目的 |
|---|---|---|
| 最大行数 | 2 行 | 降低阅读负担 |
| 对齐方式 | 底部居中 | 保持视线稳定 |
| 描边 | 2~4 像素等效值 | 提高复杂背景上的对比度 |
| 左右边距 | 画面宽度约 5% | 防止贴边或被裁切 |
| 底部边距 | 画面高度约 6%~10% | 避开播放器控件与画面边缘 |
完整可运行示例
下面的程序只使用 Python 标准库。它会校验时间戳、按中英文规则换行,并生成 subtitles.ass。示例采用 1920×1080 画布、底部居中、白色文字和深色描边。
from pathlib import Path
import re

SEGMENTS = [
    {"start_ms": 0, "end_ms": 1800, "text": "欢迎进入 AI 数字人实时渲染课程。", "language": "zh"},
    {"start_ms": 1900, "end_ms": 4200, "text": "This subtitle keeps complete English words together.", "language": "en"},
    {"start_ms": 4300, "end_ms": 7000, "text": "字幕过长时,应优先在语义边界换行,而不是压缩到难以阅读。", "language": "zh"},
]

def ass_time(ms: int) -> str:
    """把毫秒转换为 ASS 使用的 H:MM:SS.cc。"""
    if ms < 0:
        raise ValueError("时间戳不能为负数")
    centiseconds = ms // 10
    hours, remainder = divmod(centiseconds, 360000)
    minutes, remainder = divmod(remainder, 6000)
    seconds, cs = divmod(remainder, 100)
    return f"{hours}:{minutes:02d}:{seconds:02d}.{cs:02d}"

def wrap_zh(text: str, limit: int = 16) -> str:
    """优先在中文标点后换行,最多生成两行。"""
    if len(text) <= limit:
        return text
    candidates = [m.end() for m in re.finditer(r"[,。!?;、]", text)
                  if 0 < m.end() < len(text) and abs(m.end() - limit) <= 4]
    split_at = min(candidates, key=lambda pos: abs(pos - limit), default=limit)
    return text[:split_at] + r"\N" + text[split_at:]

def wrap_en(text: str, limit: int = 38) -> str:
    """按单词累积长度,避免把英文单词拆成两段。"""
    words = text.split()
    first_line = []
    second_line = []
    current = first_line
    for word in words:
        projected = len(" ".join(current + [word]))
        if current is first_line and first_line and projected > limit:
            current = second_line
        current.append(word)
    return " ".join(first_line) + (r"\N" + " ".join(second_line) if second_line else "")

def normalize_segments(segments: list[dict]) -> list[dict]:
    """排序并修正相邻片段的重叠边界。"""
    normalized = []
    for item in segments:
        start, end = item["start_ms"], item["end_ms"]
        if type(start) is not int or type(end) is not int or not 0 <= start < end:
            raise ValueError("字幕起止时间必须是有效的整数毫秒")
        start, end = start // 10 * 10, end // 10 * 10
        if start >= end:
            raise ValueError("字幕量化到百分秒后没有有效时长")
        normalized.append({**item, "start_ms": start, "end_ms": end})
    normalized.sort(key=lambda item: item["start_ms"])
    for before, current in zip(normalized, normalized[1:]):
        if before["start_ms"] == current["start_ms"]:
            raise ValueError("两条字幕在百分秒时间轴上起点相同,请先合并")
        before["end_ms"] = min(before["end_ms"], current["start_ms"])
    return normalized

def plain_text(text: str) -> str:
    clean = re.sub(r"[\x00-\x20\x7f]+", " ", text).strip()
    # 普通文本中的括号和反斜线不应被当作 ASS 控制语法。
    return clean.translate(str.maketrans({"\\": "\", "{": "{", "}": "}"}))

def build_ass(segments: list[dict]) -> str:
    header = """[Script Info]
ScriptType: v4.00+
PlayResX: 1920
PlayResY: 1080
WrapStyle: 2

[V4+ Styles]
Format: Name,Fontname,Fontsize,PrimaryColour,OutlineColour,BackColour,Bold,Italic,Underline,StrikeOut,ScaleX,ScaleY,Spacing,Angle,BorderStyle,Outline,Shadow,Alignment,MarginL,MarginR,MarginV,Encoding
Style: Default,Noto Sans CJK SC,54,&H00FFFFFF,&H00101010,&H80000000,0,0,0,0,100,100,0,0,1,3,1,2,96,96,72,1

[Events]
Format: Layer,Start,End,Style,Name,MarginL,MarginR,MarginV,Effect,Text
"""
    events = []
    for item in normalize_segments(segments):
        raw = plain_text(item["text"])
        if not raw:
            raise ValueError("字幕正文不能为空")
        text = wrap_en(raw) if item["language"] == "en" else wrap_zh(raw)
        events.append(
            "Dialogue: 0,"
            f"{ass_time(item['start_ms'])},{ass_time(item['end_ms'])},"
            f"Default,,0,0,0,,{text}"
        )
    return header + "\n".join(events) + "\n"

output_path = Path("subtitles.ass")
output_path.write_text(build_ass(SEGMENTS), encoding="utf-8-sig")
print(f"已生成 {output_path.name},共 {len(SEGMENTS)} 条字幕")
将代码保存为 generate_subtitles.py,然后在临时目录运行:
python generate_subtitles.py预期输出:
已生成 subtitles.ass,共 3 条字幕生成的 subtitles.ass 可直接交给支持 ASS 的播放器或视频合成流程。示例的自动换行最多主动插入一个断点,不能保证超长字幕一定适配画布。长句需要按字体实测宽度与阅读速度重新分段。示例把普通文本里的 ASS 控制字符替换为全角字形,自动换行在这之后由程序插入。实际部署要在最终渲染器和分辨率验证字体与边距。
验证与常见错误
先检查时间线,再检查版式。播放时应观察字幕是否与语音同步、是否出现重叠闪烁、两行是否同时可读,以及底部控件出现后是否遮挡文字。多语言版本还要检查缺字方框、连字方向和标点位置。
- 时间单位混用:把秒当成毫秒会让字幕整体延迟或持续数千倍。进入排版前统一使用毫秒,输出时再转换格式。
- 只按字符数切分:英文单词、数字和单位会被拆开。应按语言分别选择断句策略,并保留专有名词完整。
- 依赖单一字体:开发机正常、服务器缺字。应明确字体包、授权与安装路径,并为不同文字系统配置回退字体。
- 字幕贴近画面边缘:移动端裁切或播放器控件会遮挡文字。应在最终播放端验证安全区域,而不是只看编辑器预览。
本课总结
- 字幕生成要先保证时间戳合法,再处理语义断句与换行。
- 字体覆盖、描边和安全区域共同决定字幕在真实画面中的可读性。
- ASS 适合保存时间、样式和位置,便于后续渲染与媒体合成。
下一课预告
下一课将学习“音频与视频编码”,把画面、声音与字幕交付到兼容的编码和封装格式中,并理解码率、关键帧与像素格式的取舍。