
AI 内容创作 / 系统课时
端到端延迟分析
端到端延迟分析
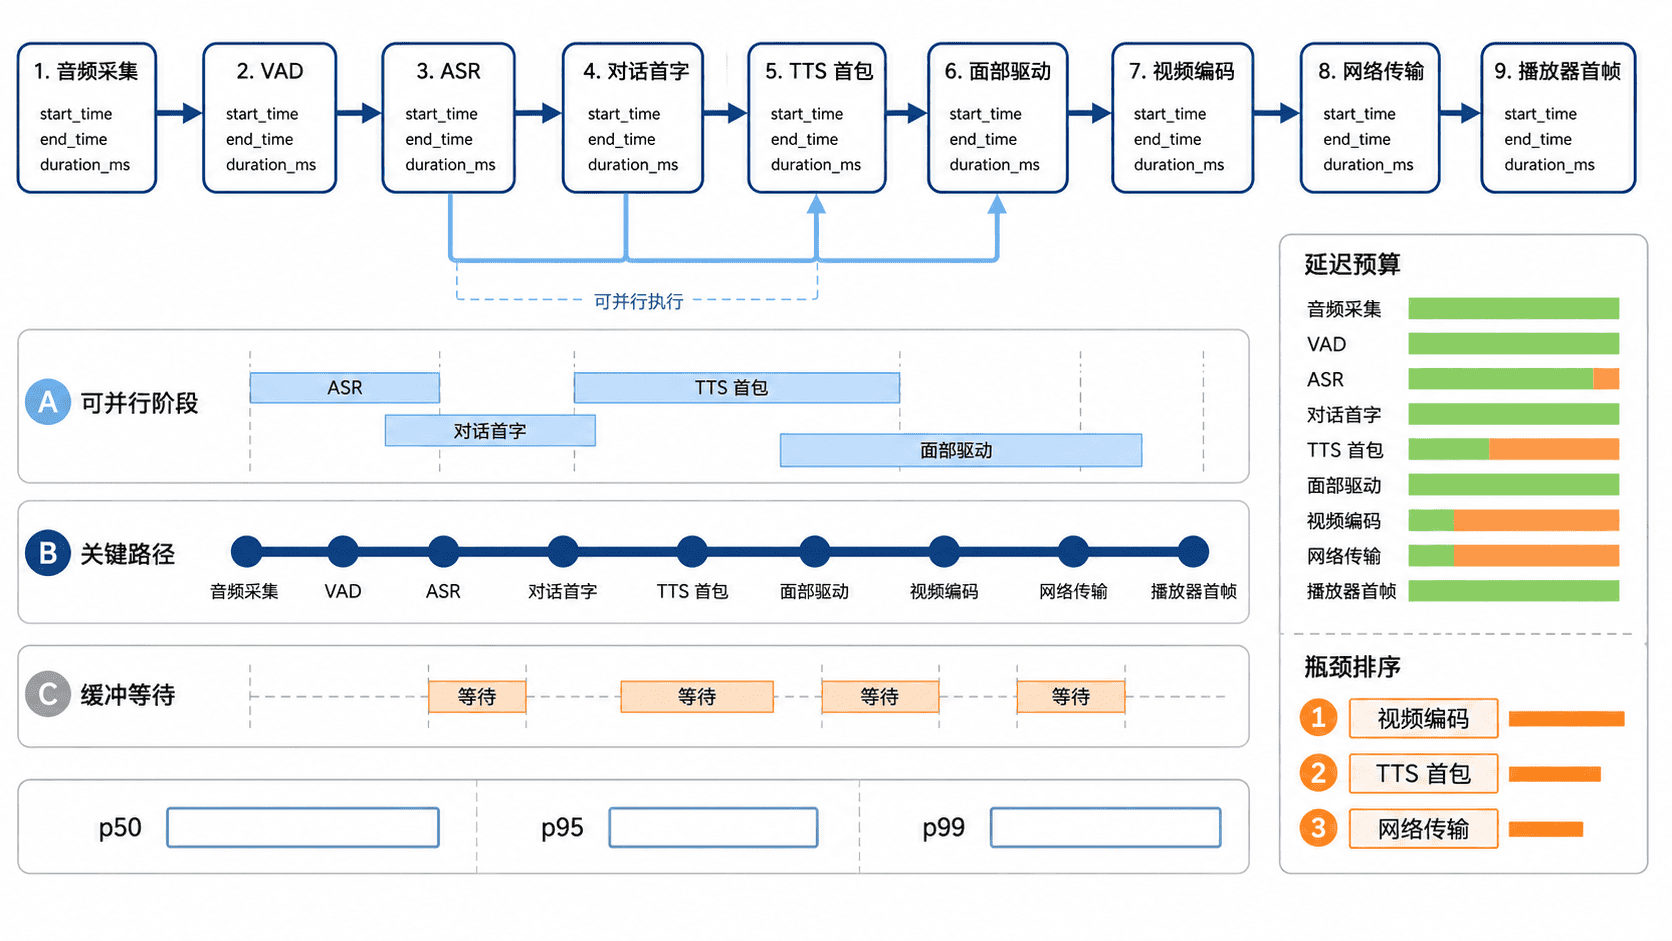
数字人的“反应慢”通常不是单个模块造成的,而是多个串行阶段与缓冲策略共同累积。本课将把一次交互拆成可测量的时间段,建立统一时间戳、分位数指标和延迟预算,并通过一个可运行脚本定位最主要的优化对象。
学习目标
- 拆分并计算数字人交互的端到端延迟
- 使用统一时间戳和链路标识采集分阶段指标
- 根据延迟预算、分位数和关键路径制定优化顺序
延迟链路与关键路径
一次可感知响应通常经历音频采集、VAD 确认、ASR、对话首字、TTS 首包、面部驱动、编码和网络传输。端到端延迟不是所有耗时的简单总和;并行阶段只计入关键路径,播放器预缓冲则会额外增加首帧等待。
当以下各段确实串行且互不重叠,可用下式描述首个画面的主要路径:
若 TTS、驱动和视频渲染采用流式流水线,应以各阶段首个可消费数据的时间计算启动延迟,而不是等待整段文本或整段音频完成。
指标采集与统计规则
所有服务必须使用同一时钟语义。单机内部优先使用单调时钟计算耗时;跨服务传递 trace_id、turn_id 和阶段时间戳,再由追踪系统统一拼接。不要直接用不同主机的本地时间相减,否则时钟偏差会制造虚假延迟。
| 指标 | 含义 | 优化用途 |
|---|---|---|
stage_duration_ms |
单阶段处理耗时 | 定位模块瓶颈 |
queue_wait_ms |
排队和资源等待 | 判断容量不足 |
first_chunk_ms |
首个流式结果到达时间 | 优化首响体验 |
e2e_first_frame_ms |
用户说完到首帧可播放 | 衡量总体体验 |
cancel_to_silence_ms |
抢话到静音 | 衡量打断响应 |
按完整请求独立测量首段可听回应与首个显示帧,使用同一端的时钟记录起止。生产环境可统计 p50、p95 和 p99,另报样本数、取消、超时及无首帧比例,避免只统计成功请求。平均值可能掩盖少量严重卡顿,而高分位可以揭示冷启动、排队、网络抖动和重试带来的长尾问题。
延迟预算与优化顺序
先给端到端目标分配预算,再比较各阶段实际值。优化优先级通常由“关键路径占比 × 超预算频率 × 可优化空间”决定,而不是只选择绝对耗时最大的模块。
常见策略包括缩短 VAD 尾部等待、让 ASR 提前输出稳定片段、让对话模型流式返回、让 TTS 按句并行合成、减少播放器预缓冲,并避免重复的像素格式转换。每次只调整一个主要变量,使用同一批测试语料复测,才能判断收益来自何处。
可运行分析示例
下面的 Python 3.11 脚本读取一次首帧链路的阶段耗时,计算总延迟、预算差值和最大瓶颈。示例中的数值为固定测试数据,真实系统应从追踪日志中导出。
from dataclasses import dataclass
from typing import List

@dataclass(frozen=True)
class Stage:
    name: str
    duration_ms: int

def analyze(stages: List[Stage], budget_ms: int) -> None:
    if not stages or budget_ms <= 0 or any(stage.duration_ms < 0 for stage in stages):
        raise ValueError("需要非空阶段、非负耗时和正预算")
    total_ms = sum(stage.duration_ms for stage in stages)
    bottleneck = max(stages, key=lambda stage: stage.duration_ms)
    share = bottleneck.duration_ms / total_ms * 100 if total_ms else 0.0
    over_budget_ms = max(0, total_ms - budget_ms)

    print(f"total_ms={total_ms}")
    print(f"budget_ms={budget_ms}")
    print(f"over_budget_ms={over_budget_ms}")
    print(
        "bottleneck="
        f"{bottleneck.name}, duration_ms={bottleneck.duration_ms}, "
        f"share={share:.1f}%"
    )

def main() -> None:
    stages = [
        Stage("capture", 35),
        Stage("asr", 180),
        Stage("dialog", 420),
        Stage("tts_first_chunk", 160),
        Stage("avatar_drive", 28),
        Stage("encode", 22),
        Stage("network", 45),
        Stage("player_buffer", 30),
    ]
    analyze(stages, budget_ms=800)

if __name__ == "__main__":
    main()
将代码保存为 latency_analysis.py,然后运行:
python latency_analysis.py预期输出:
total_ms=920
budget_ms=800
over_budget_ms=120
bottleneck=dialog, duration_ms=420, share=45.7%
验证与常见误区
分析结果应在固定网络、固定语料和固定并发条件下重复采集,并分别记录冷启动与热运行。若只测一次,很容易把偶发缓存命中或资源争用误判为稳定性能。
常见误区是把并行阶段全部相加,导致端到端估算偏大;正确做法是根据时间轴识别关键路径。另一误区是只压缩模型推理时间,却忽略队列等待和播放器缓冲。修复后应再次核对 e2e_first_frame_ms,确认局部优化确实转化为用户可感知收益。
本课总结
- 端到端延迟必须按关键路径计算,并区分处理、排队和缓冲时间
- 分阶段时间戳、统一链路标识与高分位统计是定位长尾问题的基础
- 优化应围绕延迟预算和可感知指标验证,而不是只看单模块耗时
下一课预告
后续将进入实时交互架构的综合优化阶段,把打断控制、流式处理、资源调度与监控指标结合起来,形成可持续迭代的性能闭环。